Command Palette
Search for a command to run...
대량의 토양 미생물 데이터 주석의 어려움, BBERT가 100bp 짧은 읽기에서 분류 및 기능 단서를 발굴
미생물 생태계는 극도로 복잡한 구성 구조를 가지고 있으며, 이러한 복잡성을 이해하는 것은 생물권 운영을 유지하는 다양한 과정을 규명하는 데 필수적입니다. 이 작업은 대규모 시퀀싱 데이터셋 분석 없이는 불가능합니다. 오늘날 이러한 데이터 자원은 풍부합니다. 지구의 다양한 생물 군계를 포함하는 수천 개의 공개 메타게놈 데이터셋을 무료로 접근하고 다운로드할 수 있습니다.
이러한 데이터 중 토양 메타게놈은 특히 중요한 연구 가치를 지닙니다. 토양과 같은 복잡한 환경에서의 샷건 메타게놈 시퀀싱(Shotgun Metagenomics)은 극도로 풍부한 생물 다양성을 드러냅니다. 그러나 충분히 포괄적인 참조 데이터베이스의 부재로 인해, 샷건 시퀀싱에서 생성된 대부분의 짧은 읽기(Short Reads)는 정확한 분류학적 또는 기능적 주석을 얻을 수 없어, 미생물 군집의 실제 구조와 기능이 완전히 해석되지 못하는 경우가 많습니다.
이러한 배경에서, 예루살렘 히브리 대학교 연구팀은 짧은 읽기 분석에 최적화된 뉴클레오티드 대규모 언어 모델인 BBERT를 제안했습니다. 연구자들은 대규모 토양 메타게놈 데이터셋에서 테스트를 수행한 결과, BBERT가 참조 데이터베이스에 의존하지 않고도 세균 서열의 구문적 특성을 식별하고, 길이 100bp에 불과한 짧은 읽기에서 분류 도메인(Taxonomic Domain), 코딩 잠재력(Coding Potential), 및 읽기 프레임(Reading Frame)을 정확하게 판단할 수 있음을 발견했습니다. 또한, BBERT 모델은 짧은 메타게놈 읽기를 직접 세균 아미노산 서열로 변환하여 후속 연구 및 응용을 지원할 수 있습니다. 메타게놈 디 노보 어셈블리(de novo assembly) 측면에서도 BBERT는 장점을 보여줍니다. 어셈블리 과정에서 불일치와 간격을 줄이는 동시에 실행 시간을 단축합니다. 연구자들은 야생 콩과 식물 근류의 메타게놈 데이터를 이용하여 추가 검증을 수행했으며, 그 결과 BBERT를 통한 데이터 필터링은 빈닝(Binning) 품질을 현저히 향상시킬 뿐만 아니라 디 노보 어셈블리 속도를 크게 가속화할 수 있음을 확인했습니다.
관련 연구 결과는 "Fast and accurate taxonomic domain assignment of short metagenomic reads using BBERT"라는 제목으로 Nucleic Acids Research에 게재되었습니다.
연구 하이라이트:
- BBERT는 대규모 언어 모델 기반의 기존 방법들이 가진 처리량과 정확성 측면의 한계를 동시에 돌파했습니다.
- 메타게놈 분석 전에 BBERT를 사용하여 사전 필터링하면 기능적 주석 속도 향상, 디 노보 어셈블리 품질 개선, 어셈블리 오류 감소 및 빈닝 품질 개선이 가능합니다.
- BBERT는 짧은 읽기를 위한 빠르고 참조 데이터베이스가 필요 없는 분류 방법을 제공하며, 기존 대량의 메타게놈 데이터 아카이브의 연구 가치를 해방할 잠재력을 가지고 있습니다.
논문 주소:
https://academic.oup.com/nar/article/54/19/gkag1002/8971853?login=false
데이터셋: 세균 게놈 학습부터 복잡한 메타게놈 환경 검증까지
BBERT의 개발 및 평가 과정에서 연구자들은 두 가지 유형의 데이터셋을 정리하고 구축했습니다.
- 첫 번째 유형은 모델 사전 학습에 사용되며, 1,416개 세균 종의 게놈 데이터를 포함합니다. 데이터가 세균 생명 진화 트리를 잘 커버할 수 있도록 RefSeq 데이터베이스의 각 세균 과에서 두 개의 게놈을 무작위로 추출했습니다.
- 두 번째 유형은 모델 보정 및 평가에 사용되며, 396개 다른 속의 899개 세균 종과 823개 다른 속의 1,200개 진핵생물 종을 포함합니다. 주목할 점은 이 두 가지 데이터셋이 속(Genus) 분류 단계에서 완전히 분리되어 서로 속의 중복이 전혀 없다는 것입니다.
동시에, 토양 환경의 진핵생물 다양성을 대표하도록 선별된 참조 게놈 데이터셋을 구축하기 위해, 연구자들은 먼저 토양 미생물 군집의 18S rRNA 및 ITS 증폭자 메타바코딩 연구(Amplicon Metabarcoding Studies)를 검토하여 대상 분류군 목록을 확정했습니다. 관련 연구에는 지구 미생물군 프로젝트, 범유럽 LUCAS 토양 조사 프로젝트, 그리고 전 세계 토양 원생생물 및 곰팡이 다양성 조사가 포함됩니다.
상기 문헌의 종합 분석을 통해 토양 미생물 군집에서 지속적으로 높은 풍부도를 보이는 주요 진핵생물 계통 8개가 확정되었으며, 이들은 다음과 같습니다:
- 사족충류(Cercozoa)
- 섬모충류(Ciliophora)
- 난균류(Oomycota, 이편모류)
- 균근균류(Glomeromycota, 즉 균근균)
- 접합균류(Mucoromycota)
- 자낭균류(Ascomycota)
- 자유생활 선형동물(Free-living Nematoda)
- 아메바류(Amoebozoa)
또한, 데이터셋에는 토양 환경과 관련된 녹조류 및 이미 게놈 시퀀싱 데이터가 확보된 육상 식물 분류군이 추가로 포함되었습니다.
종 분류 과정에 내재된 무작위성을 고려하기 위해, 속(genus) 분류 단계에서 교정(calibration) 및 평가 데이터셋의 모든 게놈 등록 항목을 균등한 20개 그룹으로 나누었으며, 세균과 진핵생물 각각에 대해 20개 그룹으로 분류했습니다. 각 그룹 내에서 종 풍부도는 로그 정규 분포(Log-normal Distribution)에 따라 무작위로 할당되었습니다. 이후 두 데이터셋의 그룹을 서로 조합하여 20개의 조합 하위 집합을 형성했습니다. 각 하위 집합은 독립적인 세균 및 진핵생물 속 구성을 가집니다. 이 20개의 하위 집합 중 첫 10개(데이터셋 1–10)는 모델 미세 조정에 사용되었으며, 나머지 10개(데이터셋 11–20)는 모델 평가를 위해 보존되었습니다.
BBERT 프레임워크: 대규모 언어 모델이 DNA 서열에서 세균 특성을 학습하도록 함
BBERT는 BERT 아키텍처를 기반으로 개발된 모델로, 세균 게놈에서 유래한 뉴클레오타이드 서열의 분포 외 검출(OOD, Out-of-Distribution)을 목적으로 하며, 세균 서열만 사용하여 학습함으로써 주어진 서열이 세균에서 유래한 것인지 판단하는 것이 핵심 아이디어입니다. 뉴클레오타이드 서열을 기반으로 세균 게놈의 분포 외 검출을 수행할 수 있는 대규모 언어 모델을 구축하기 위해 연구자들은 세 단계의 개발 프로세스를 채택했습니다:
- 세균 게놈 리드(reads)만 사용하여 BERT 아키텍처를 사전 학습함;
- 세균/비세균 분류 작업을 위해 미세 조정함;
- 세균 리드 분류 작업에서의 모델 성능을 평가하고 BERTax, Tiara 및 REMME와 비교함.
① 모델 사전 학습
BBERT의 사전 학습에는 합성 짧은 뉴클레오타이드 서열이 포함된 세균 데이터셋이 사용되었으며, 각 서열의 길이는 모두 100bp로 메타게놈 시퀀싱 리드 및 발생할 수 있는 시퀀싱 오류를 모사하기 위한 것입니다. 학습 과정에서 연구자들은 마스킹 언어 모델(Masked Language Model)을 최적화 목표로 채택하여, 입력 서열 내 토큰의 30%를 마스킹하고 컨텍스트를 바탕으로 이러한 마스킹된 토큰을 추론하는 모델의 능력을 최적화했습니다. 이 과정을 통해 모델은 기존 리드 정보에 기반하여 누락된 뉴클레오타이드를 표현하는 능력을 학습할 수 있습니다.
사전 학습의 최적화 과정은 에폭(Epoch)당 5–10개의 학습 주기를 한 단계로 하여 지속되었으며, 최적의 결과를 얻을 때까지 모든 중간 체크포인트(Checkpoints, 즉 모델 가중치)를 저장했습니다. 일반적으로 학습 손실(loss)이 지속적으로 감소하는 동시에 분류 정확도도 함께 향상되는 현상이 관찰되었습니다. 학습 진행이 정체되어 모델 성능의 뚜렷한 개선이 더 이상 나타나지 않을 때 학습을 종료했습니다.
② 모델 미세 조정
다음으로, BBERT가 세균 리드 분류 작업을 수행할 수 있도록 하기 위해 연구자들은 모델에 경량 분류 헤드(Classification Head)를 추가했습니다: BBERT 인코더(Encoder)가 생성한 토큰 임베딩 위에 선형 레이어(linear layer)를 추가하여 특정 리드가 세균에서 유래한 것인지 직접 예측하도록 합니다.
이 분류 헤드는 지도 학습(supervised learning) 방식으로 학습되었습니다. 학습 과정에서 사전 학습된 BBERT의 모델 가중치를 동결하지 않고, 인코더와 분류 헤드를 함께 미세 조정하여 인코더가 학습한 특징 표현이 현재 분류 작업에 적응하도록 했습니다. 사전 학습 가중치가 불안정하게 영향을 받지 않도록 분류 헤드와 인코더에 서로 다른 학습률(learning rate)을 설정했습니다: 인코더의 학습률은 1×10⁻⁶, 분류 헤드의 학습률은 1×10⁻⁵였으며, AdamW 최적화기를 사용했습니다.
연구 결과, Transformer 인코더의 하위 두 레이어를 동결하고 나머지 레이어를 미세 조정하는 전략이 더 나은 성능을 보였다는 것을 발견했습니다. 모델은 최종적으로 해당 리드가 세균에서 유래한 확률(bact_prob)을 출력하며, bact_prob가 0.5보다 클 경우 해당 리드를 세균에서 유래한 것으로 판정합니다.
③ 모델 평가 및 비교
마지막으로, 연구자들은 데이터셋에서 모델의 전반적인 분류 성능 지표를 집계하고 보고하며, 벤치마크 결과를 BERTax, Tiara 및 REMME와 비교했습니다.
결과: BBERT의 분류 정확도, 기능 주석 및 조립 효율이 모두 검증됨
① BBERT의 성능은 기존 최신 딥러닝 분류 도구보다 우수함
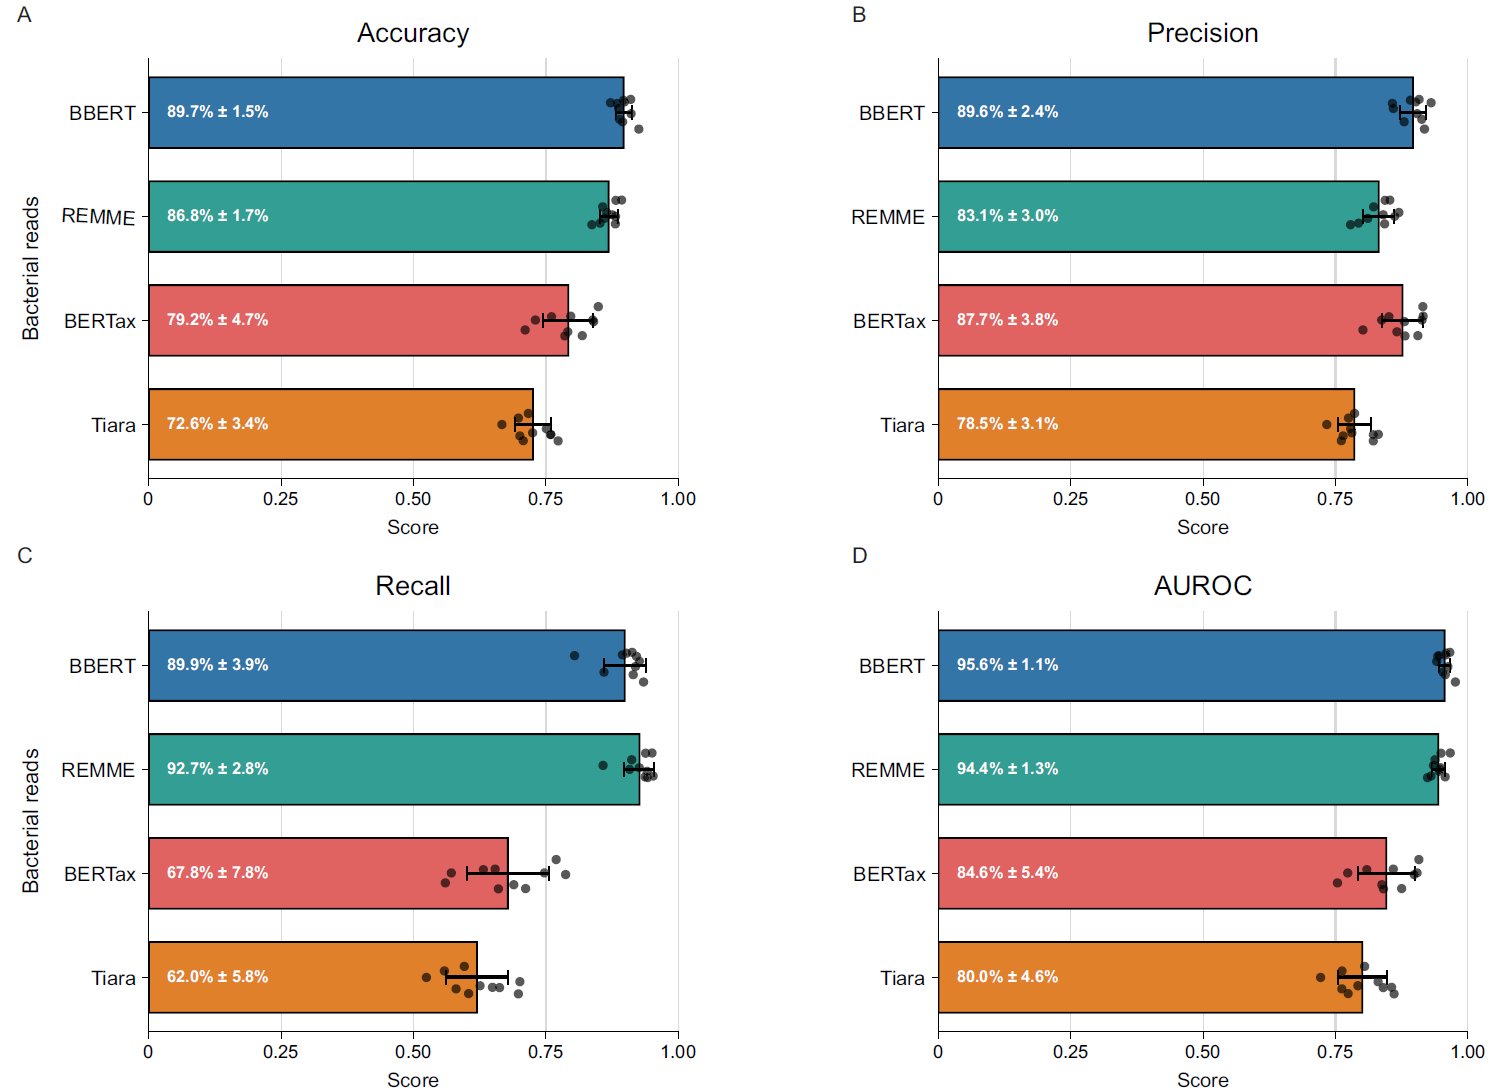
먼저, 세균 및 비세균 리드 분류 작업에서 BBERT는 강력한 식별 능력을 보였습니다 —— 아래 그림과 같이, 정확도, 정밀도, 재현율(REMME와 동등한 수준) 및 AUROC와 같은 표준 분류 지표에서 BBERT의 성능은 BERTax, Tiara 및 최적화된 REMME보다 우수했습니다. BBERT의 10개 테스트셋에 걸친 도메인 분류 평균 정확도는 89.7% ± 1.7%인 반면, REMME는 86.8% ± 1.7%, BERTax는 79.2% ± 4.7%, Tiara는 72.6% ± 3.4%였습니다.
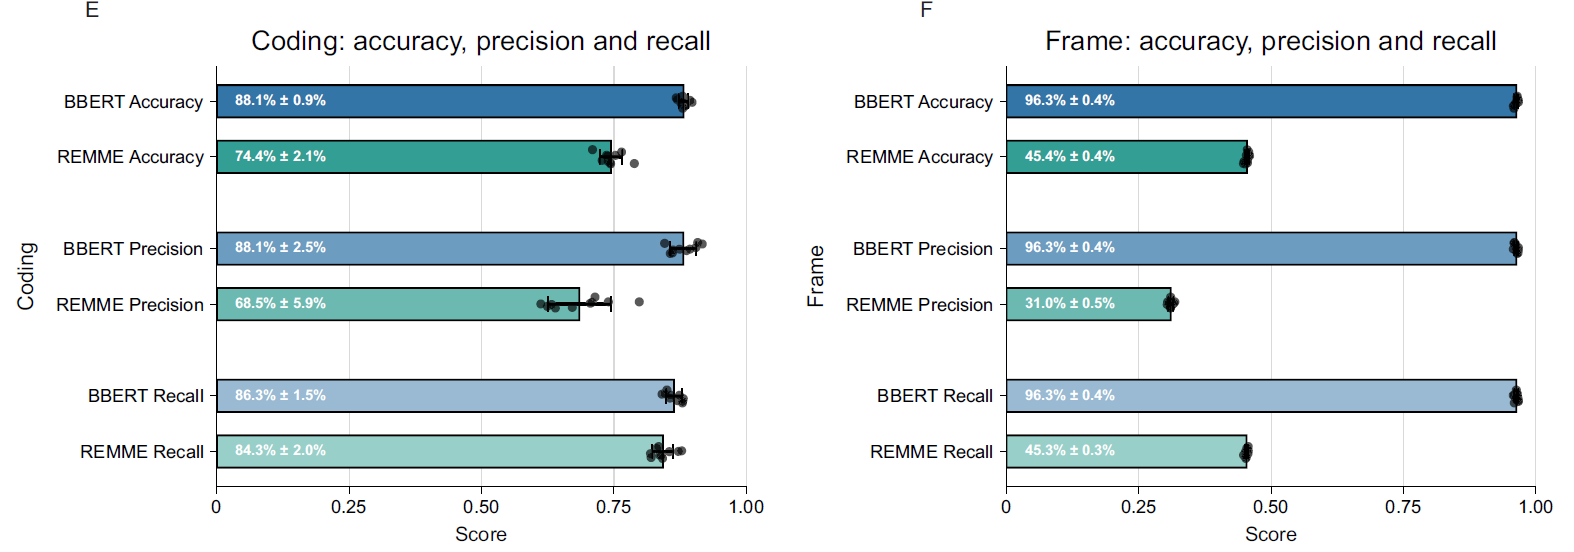
코딩 서열 및 그 판독 프레임(reading frame)을 식별하는 측면에서 BBERT의 성능은 이 기능을 가진 유일한 유사 도구인 REMME보다 우수했습니다(아래 그림 E, 코딩 정확도: BBERT 88.1% ± 0.9%, REMME 74.4% ± 2.1%; 아래 그림 F, 판독 프레임 정확도: BBERT 96.3% ± 0.3%, REMME 45.4% ± 0.4%).
컴퓨팅 성능 측면에서도 BBERT는 뛰어난 실용성을 보여줍니다. 전용 NVIDIA H200 GPU가 장착된 컴퓨팅 노드에서 BBERT는 초당 45,912개의 리드(reads per second, rps)를 처리할 수 있으며, BERTax와 Tiara는 각각 413 rps 및 347 rps를 기록했습니다. 다만, 코드 최적화를 거친 REMME는 50,745 rps로 약간 더 빠른 속도를 나타냈습니다. NVIDIA RTX 3090 GPU를 탑재한 Windows 10 개인용 컴퓨터에서 실행할 경우 BBERT의 처리 속도는 15,373 rps였습니다. 이는 고성능 컴퓨팅 클러스터에 의존하지 않더라도 사용자가 BBERT를 활용해 분석을 수행할 수 있음을 의미하며, 대부분의 유사 도구에서는 이러한 점이 어렵습니다.
② BBERT는 높은 민감도를 가진 세균 식별 도구입니다
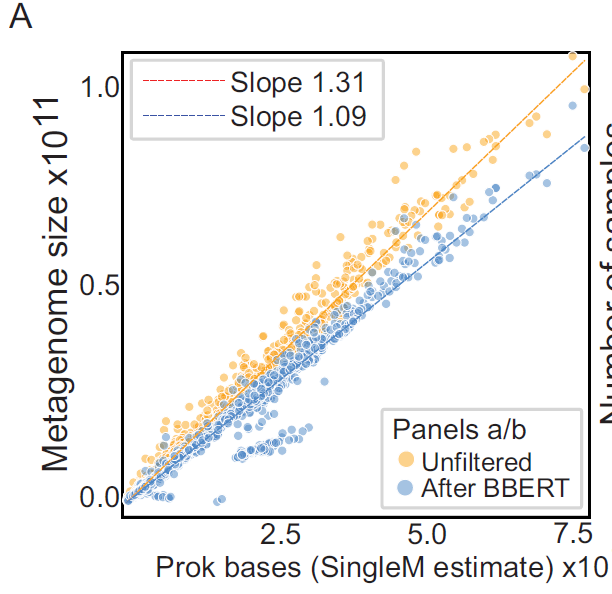
연구자들은 BBERT를 정리된 1,969개의 공개 토양 메타지노믹스 데이터셋에도 적용하여, SingleM으로 추정된 원핵생물 염기 수를 기준으로 삼아 실제 분류 결과가 없는 이러한 데이터에서의 성능을 추가로 검증했습니다. 아래 그림과 같이, 선별 과정을 거치지 않은 경우 메타지노믹스 데이터의 총 염기 수가 SingleM으로 추정된 원핵생물 염기 수보다 31% 높았습니다(기울기 1.31±0.01). BBERT를 통한 선별 후 이 격차는 9%(기울기 1.09±0.01)로 축소되었습니다.
SingleM과 달리 Kraken2는 개별 리드 수준에서의 비교를 지원하므로, 연구자들은 BBERT와 Kraken2를 직접 비교했습니다. 그 결과, Kraken2가 세균 유래로 식별한 리드에 대해 BBERT의 판정 결과는 기본적으로 일치했습니다. 동시에 BBERT는 상당수의 Kraken2가 분류할 수 없는 리드를 식별해냈으며(아래 그림 참조), 반대로 Kraken2가 식별했지만 BBERT가 식별하지 못한 리드는 매우 적었습니다.
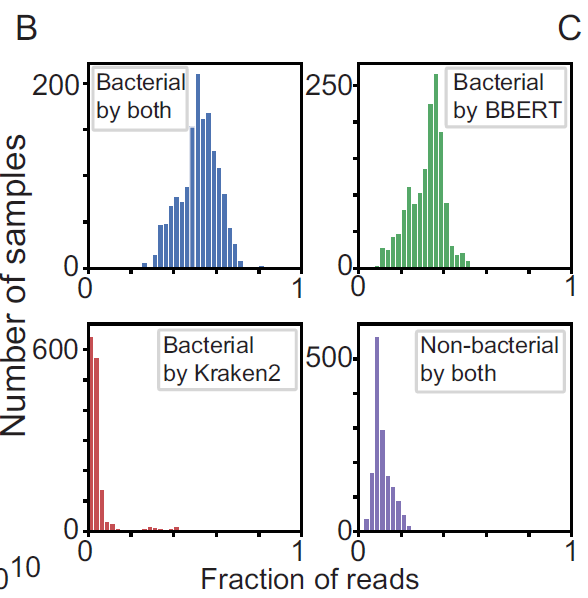
따라서 BBERT는 높은 민감도를 가진 세균 식별 도구로서, Kraken2처럼 리드 수준에서 분류를 수행할 수 있으면서도 참조 데이터베이스의 불완전한 커버리지 제한을 받지 않습니다.
③ BBERT는 짧은 DNA 리드를 아미노산 서열로 직접 번역할 수 있습니다
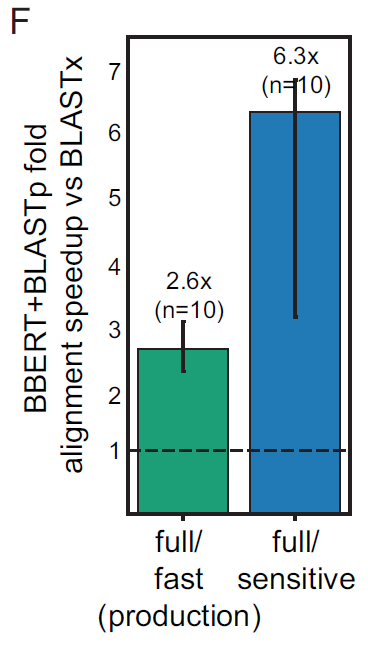
BBERT가 세균 유래의 코딩 리드와 그 오픈 프레임을 식별할 수 있으므로, 짧은 메타지노믹스 리드를 아미노산 서열로 직접 번역하는 것도 가능합니다. 연구 결과, 선별되지 않은 DNA 리드에 BLASTx를 적용하여 주석 처리하는 것과 비교할 때, 이 방법은 기본적으로 일관된 주석 결과를 얻으면서도 처리 속도가 더 빨랐습니다: fast 모드에서는 약 2.6배, sensitive 모드에서는 약 6.3배 향상되었습니다(아래 그림 참조). 이는 BBERT가 연구자들이 데이터를 선별하는 데 도움을 줄 뿐만 아니라, 메타지노믹스 기능 주석 프로세스를 추가로 최적화할 수 있음을 의미합니다.
④ BBERT는 메타지노믹스 데노보 어셈블리를 가속화하고 어셈블리 오류를 줄입니다
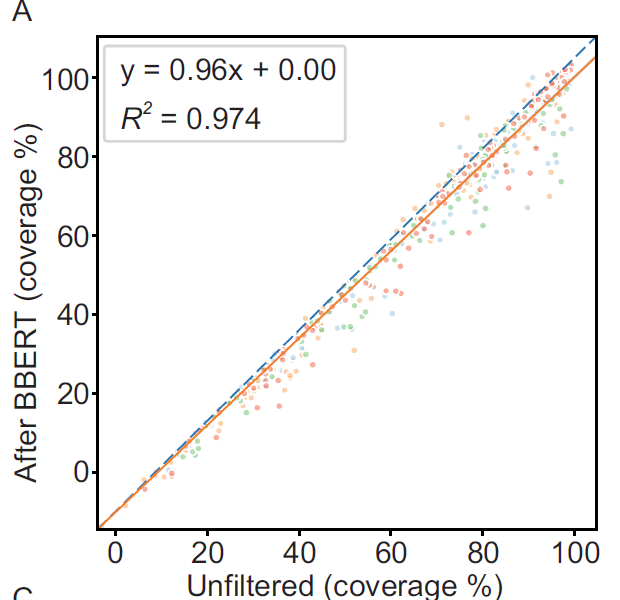
메타지노믹스 어셈블리 측면에서 BBERT의 효과는 더욱 직관적입니다. 연구팀은 선별되지 않은 데이터에서 다수의 비목표 서열이 어셈블리 부담을 증가시키고 오류 결함 및 불일치를 유발할 수 있음을 발견했습니다. 시뮬레이션된 메타지노믹스 데이터에 BBERT 선별을 적용한 결과, 세균 게놈 커버리지의 가중치 없는 평균값이 68.23%에서 65.22%로 감소하여 커버리지 손실은 약 4.4%였습니다(아래 그림 참조). 동시에 어셈블리 시간이 66±8시간에서 25±2시간으로 단축되어 효율이 약 2.7배 향상되었습니다.
조립 정확성 또한 개선되었습니다. 512개 게놈의 가중치 없는 평균을 기준으로 계산하고, 각 지표를 참조 게놈 길이에 대해 정규화하면 다음을 확인할 수 있습니다: 참조 서열 100bp당 결함(gap) 발생 횟수가 0.51회에서 0.36회로 감소하여 0.15회 줄었고, 상대 감소율은 29.3%였습니다. 불일치(mismatch) 횟수는 3.31회에서 2.64회로 감소하여 0.67회 줄었고, 상대 감소율은 20.2%였습니다. 두 지표의 합계는 약 21.4% 감소했습니다.
⑤ 실제 뿌리혹 메타게놈 데이터
BBERT 필터링이 실제 데이터셋에서 가져올 수 있는 잠재적 이점을 평가하기 위해, 연구자들은 이를 콩과 식물 뿌리혹 메타게놈 데이터에 추가로 적용했습니다. BBERT 필터링 이후 공동 조립 결과의 크기는 61% 감소하여 577.6 Mb에서 222.4 Mb로 줄었고, 콘티그(contig) 수는 57% 감소했으며, GC 함량은 40.4%에서 58.5%로 증가했습니다.
이러한 변화는 콩과 식물 게놈의 약 40% GC 함량과 리조비움목(Rhizobiales) 게놈의 약 62% GC 함량과 일치하며, 필터링된 리드(reads)의 대부분이 숙주에서 유래했음을 시사합니다. 또한 BBERT 필터링으로 인해 조립 결과의 N50 값이 0.9 kb에서 1.8 kb로 두 배 증가했고, 조립 실행 시간은 절반으로 단축되었으며, 피크 메모리 사용량도 188 GB에서 82 GB로 감소했습니다.
결론
BBERT는 대형 언어 모델이 짧은 DNA 서열을 처리하는 또 다른 가능성을 보여주었습니다. 참고 데이터베이스의 지원이 없는 100bp 리드라도 서열 자체의 특성을 학습함으로써 분류 도메인 판정, 코딩 가능성 식별 및 오픈 리딩 프레임(ORF) 예측을 수행할 수 있습니다. 더욱 중요한 것은 이러한 능력이 메타게놈 내의 비표적 서열 식별뿐만 아니라 기능 주석, 게놈 조립 및 바닝(bin)과 같은 다운스트림 프로세스도 개선할 수 있다는 점입니다.
연구는 또한 BBERT가 이동성 유전 요소와 같은 특수 서열을 식별하는 데 있어 보이는 편향이 이러한 서열과 숙주 게놈 사이의 상이한 진화적 특성을 반영할 수 있음을 나타냅니다. 향후 대형 언어 모델의 고유한 DNA 서열 패턴에 대한 민감성은 수평적 유전자 이동 사건을 추적하기 위한 새로운 도구를 제공할 수도 있습니다. 관련 모델의 지속적 발전과 함께 그 적용 범위는 미생물 분류에서 더 넓은 생태 유전체학 연구로 확대될 것으로 기대됩니다.
참고 문헌:
https://phys.org/news/2026-10-ai-tool-scientists-bacteria-hidden.html
https://academic.oup.com/nar/article/54/19/gkag1002/8971853?login=false