Command Palette
Search for a command to run...
83職種・1459件の文書を網羅、Google DeepMindが評価ベンチマーク「MKA」を提案、200の専門タスクでマルチモーダルエージェントの自律的業務遂行能力を評価
Google DeepMind が、画像の読み取りから成果物の納品までのプロセスをテストに組み込んだマルチモーダル知識エージェント評価ベンチマーク(MKA)を公開した。研究者らは分野の専門家を招き、200 件の専門的なタスクを設計した。エージェントには、自ら資料を参照し、ツールを呼び出し、職業シナリオの要件に従って成果物を提出することが求められた。結果では、評価対象の 4 モデルは、前世代のモデルがすでに安定して満たせていた要件ではいずれも 95% 超のスコアを記録した一方、それ以外のより難易度の高い要件では、加重充足率の最高値は 56.6% だった。
建築平面図を読む場合、部屋の用途は文字注記から分かるが、空間レイアウトと寸法は線や比率を組み合わせて判断する必要がある。タスクが建築計画の審査であれば、専門家はさらに規範に照らして図面を検証し、判断根拠を報告書に書き込む。今日、マルチモーダル AI はすでに単一の画像に関する多くの質問に答えられる。手がかりが図面、表、文書に分散している場合、エージェントは自ら関連情報を見つけ、検証に耐える専門報告書を完成させられるだろうか?
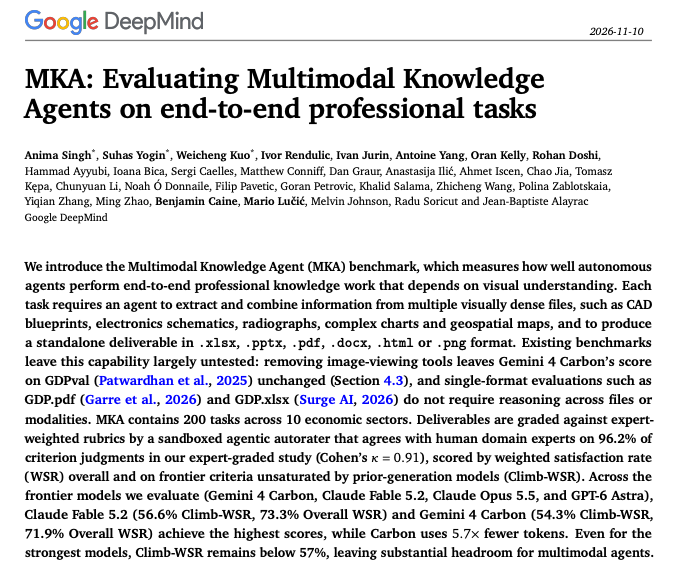
Google DeepMind が公開したマルチモーダル知識エージェント評価ベンチマーク(MKA)は、画像の読み取りから成果物の納品までのこのプロセスをテストに組み込んだ。 研究者らは分野の専門家を招き、200 件の専門的なタスクを設計した。エージェントには、自ら資料を参照し、ツールを呼び出し、職業シナリオの要件に従って成果物を提出することが求められた。結果では、評価対象の 4 モデルは、前世代のモデルがすでに安定して満たせていた要件ではいずれも 95% 超のスコアを記録した一方、それ以外のより難易度の高い要件では、加重充足率の最高値は 56.6% だった。
関連する研究成果は「MKA: Evaluating Multimodal Knowledge Agents on end-to-end professional tasks」です。
論文アドレス:
https://hyper.ai/papers/mka_tech_paper
83 職種をカバーする 200 タスク
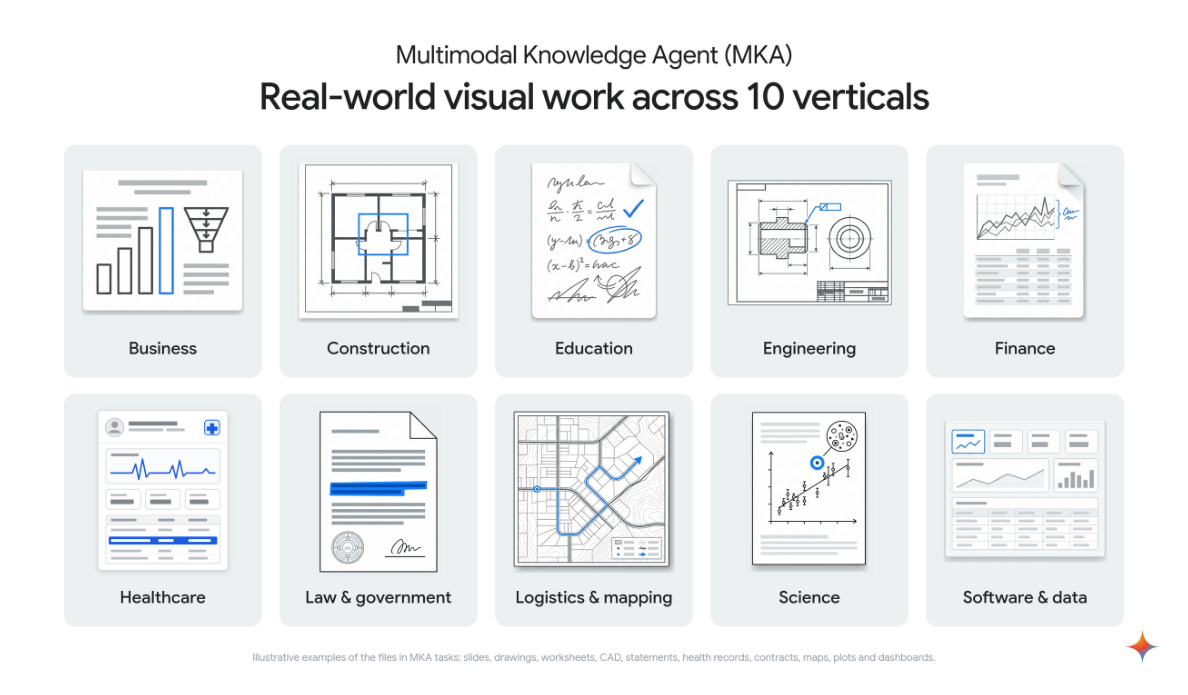
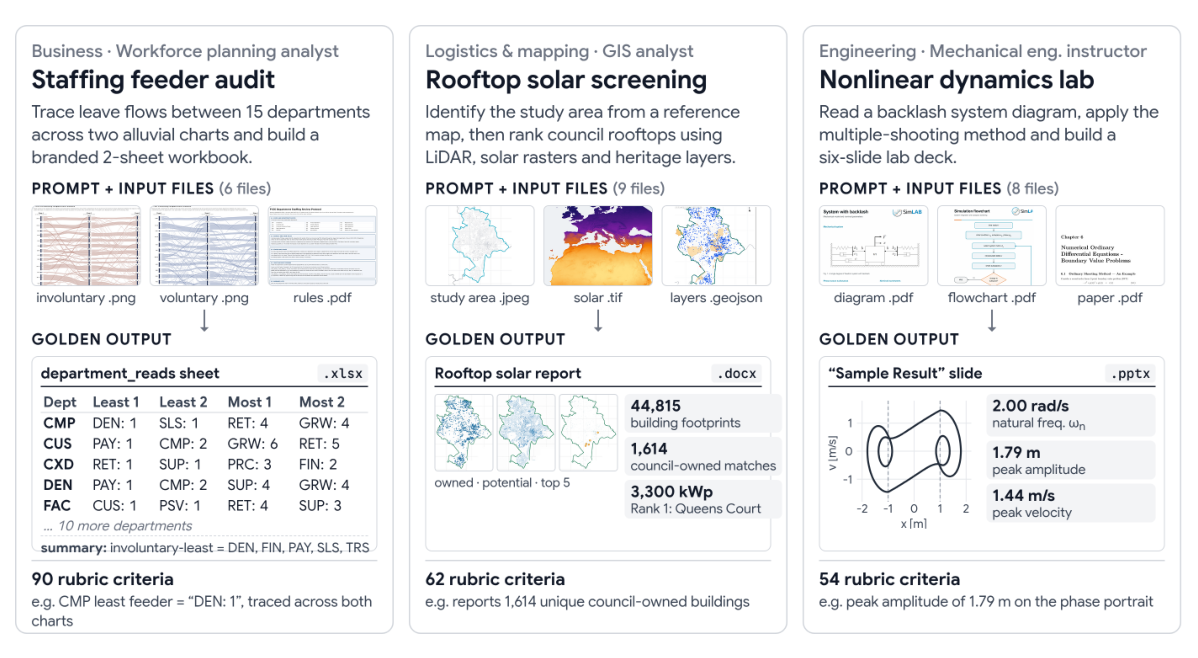
MKA の正式評価セットは、建築、エンジニアリング、金融、医療、法務、行政など 10 分野をカバーし、各分野にそれぞれ 20 タスクが含まれる。出題者は全員、関連分野で少なくとも 5 年の実務経験を持ち、業務に必要な資料を整理し、自ら参考成果物を作成し、判定根拠を明記したうえで、同じ職務背景を持つ別の専門家によるレビューを受けた。テスト内容が事前にモデルの訓練データに混入する可能性を下げるため、正式評価セットは非公開のままとされた。研究者らは別途、10 件のサンプル問題も公開した。各分野から 1 件ずつで、読者は完全なタスク説明、元ファイル、採点基準を確認できる。
そのうち 1 つのサンプル問題は、市議会のために屋根置き太陽光発電を設置するのに適した建物を選別するようエージェントに求めるものだった。問題には 9 件の資料が与えられ、最初のステップから図を読む必要がある。エージェントは、地名が記されていない地図からイギリスのノッティンガム市を特定し、分析対象範囲を確定しなければならない。その後、市議会の資産台帳を地図上の建物輪郭に対応づけ、LiDAR 標高、日射量、歴史遺産保護情報を組み合わせ、規定条件に基づいて上位 5 件の建物を選び、地図を添付した報告書を提出する。日照データの計算が正しくても、資産台帳の 1 棟の建物を誤った屋根に紐づけていれば、最終的な推薦リストに誤りが生じる可能性がある。
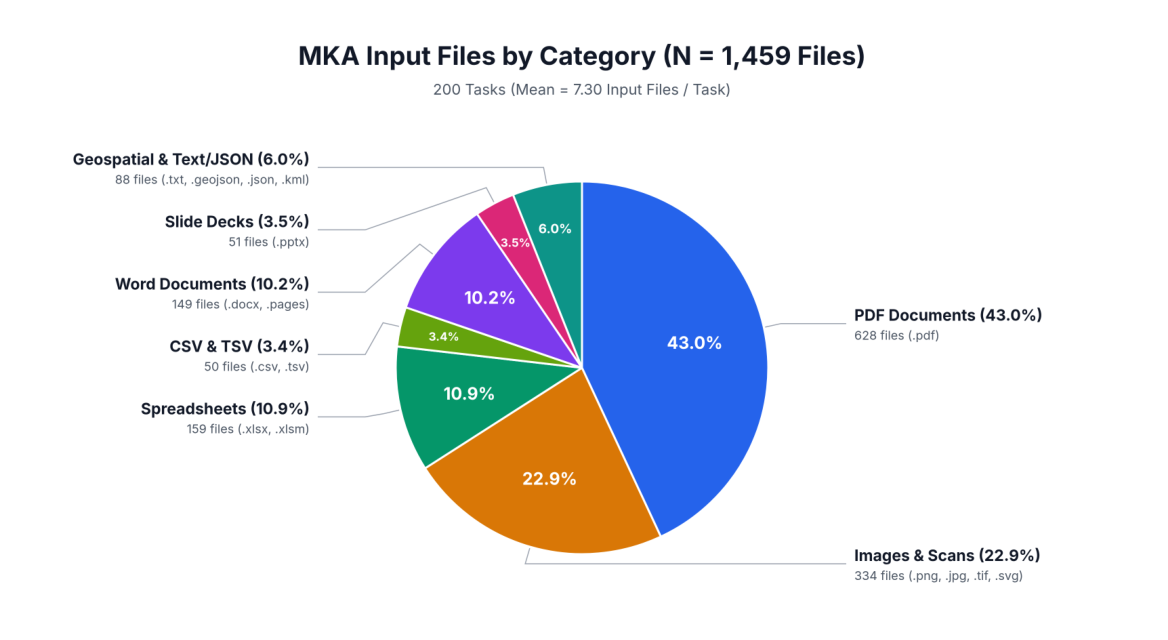
正式評価セットは合計 1,459 件のファイルを使用し、1 タスクあたり 2〜45 件、平均 7.3 件が関わる。うち PDF は 43.0% を占め、テキスト抽出が容易な契約書や規制マニュアルもあれば、線、比率、注記に依存して情報を伝えるエンジニアリング図面もある。画像とスキャンデータは 22.9% を占め、その他の資料にはスプレッドシート、プレゼンテーション、地理空間データなどが含まれる。
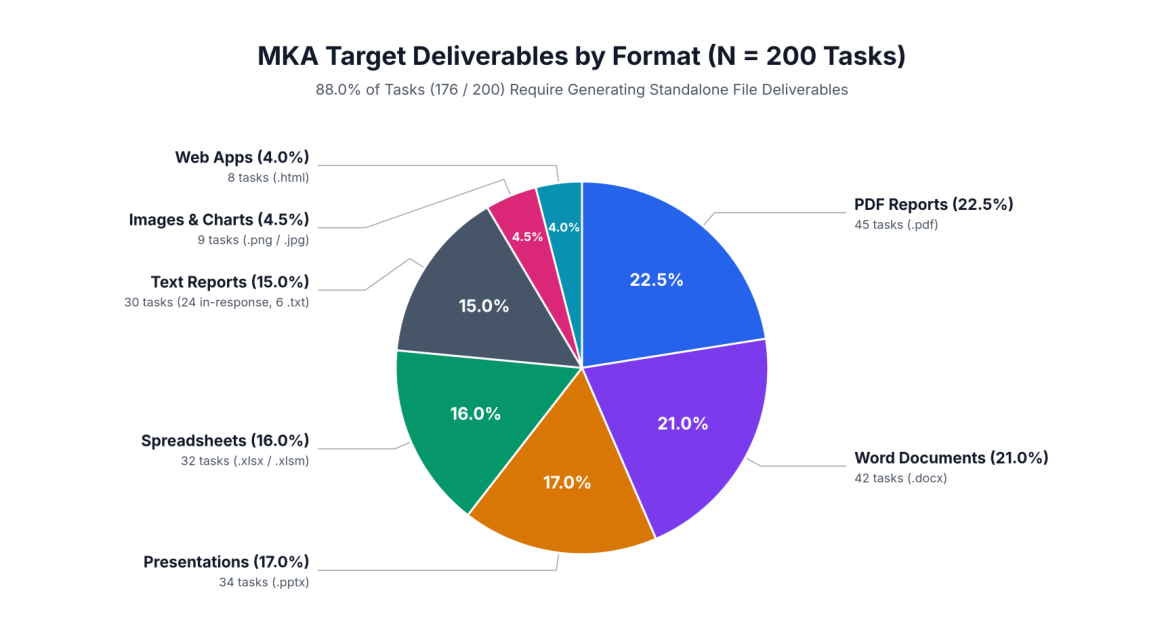
職種によって成果物への要求も異なる。200 タスクのうち、直接テキストで回答することが許されたのは 24 タスクだけで、残りの 176 タスクは、数式を含む財務ワークブック、エンジニアリング判断を伴う評価報告書、授業用プレゼンテーションなど、独立したファイルの作成または修正が必要だった。
エージェントが自律的に資料を参照し、スコアラーがページとファイル構造を同時に照合
こうしたファイル群を前にすると、どれを先に読むか、いつ図を見る必要があるか、どのデータをコードで処理するのが適切かは、すべてエージェントが自ら判断する。研究者らは既存のマルチモーダルモデルを同一のオープンソースフレームワーク Stirrup に接続し、MKA 向けの追加訓練は不要とした。タスク開始時、モデルが受け取るのは業務説明とファイルパスだけだ。エンジニアリング PDF を処理する場合、まずテキストを抽出して関連セクションを特定し、次に図面のあるページを画像に変換して、寸法注記や部品間の位置関係を確認できる。報告書完成後も、同じ方法で出力を照合し、図表が完全か、レイアウトが可読性に影響していないかを確認できる。すべてのモデルは同じツールとリソース上限を使用し、1 タスクあたり最大 250 ラウンド、制限時間は 8 時間だった。
提出されたファイルをどう評価するかは、視覚的判断も伴う。スプレッドシートを例にとると、ページを確認すれば、グラフにラベルが欠けていないか、幅の広いワークシートが切り詰められていないかは分かるが、セル内の数値がどのように計算されたかを判断するのは難しい。こうした2種類の要件を両立させるため、研究者らは GPT-6 Luna を自動評価器として使用し、独立したオフライン環境でレンダリング後のページを確認させ、コードで数式やファイル構造を読み取らせた。評価器はタスクの説明、最終回答、提出ファイルに基づいて検証し、回答時に使われた原始資料を再分析する必要はない。分野の専門家が作成した評価基準は合計 14,284 件で、そのうち 99.6% に参考判定基準が付随しており、期待値、許容誤差、ファイルが備えるべき具体的な属性などが含まれる。評価器はこれに基づいて項目ごとに判断を下し、理由を説明する。
各タスクには平均約 71 件の評価基準があり、グラフのラベルを1つ見落とすことと、最終結論に影響する数値を誤って計算することでは、結果は同じではない。専門家は重要度に応じて各基準に 1 から 5 の重みを付与した。採点では、まず1つのタスク内で満たされた基準の重み割合を計算し、各タスクを等重みで平均化して、総加重充足率(Overall WSR)を得る。
総得点は成果物の品質を反映するが、既存のモデルが一般的に達成できる要件は、最先端モデルの能力を区別する助けにはなりにくい。そのため、研究者らはまず、4つの前世代モデルにそれぞれ3回のテストを実行させた。ある基準が各モデルの3回の実行のうち少なくとも2回で満たされた場合、それは「回帰項目」に分類され、既存の能力が維持されているかを確認するために使われる。この条件に該当する基準は 6,396 件で、残りの 7,888 件は「挑戦項目」に分類された。挑戦項目の加重充足率(Climb-WSR)は、モデルがこうしたより難しい要件でどれほど優れているかを測定するもので、採点の単位は引き続きタスク内の具体的な要求である。
挑戦項目の最高得点は 56.6%
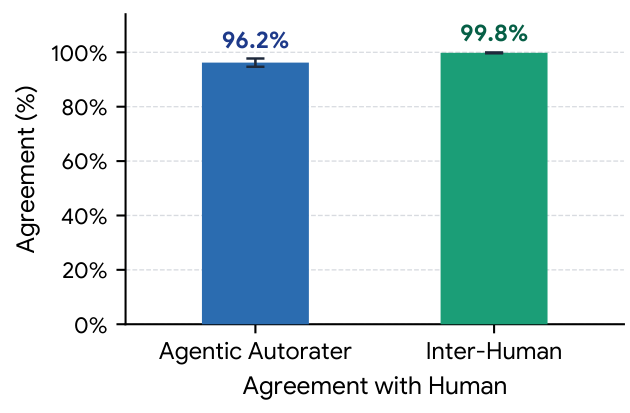
モデルを比較する前に、研究者らは自動評価が専門家の判断にどの程度近いのかを検証した。9つの分野から50のタスクを選び、各タスクについて、回答モデルの身元を知らない分野専門家3人に同じ成果物を独立して審査してもらった。抜き取り検査した高重み基準について、評価器と専門家の判断一致率は96.2%、専門家間の一致率は99.8%だった。いくつかの不一致は、「正解」の捉え方の違いから生じる。例えば、あるレポートで正しい候補値が列挙されていたものの、最終的に誤った結果が採用されていた場合、評価器は依然として合格と判定する可能性がある。今回の検証は事実、計算、ファイル構造など比較的重要な要件に重点を置いているため、96.2%の一致率が低い重みの書式の詳細にも同じように当てはまるかは、別途検証する必要がある。
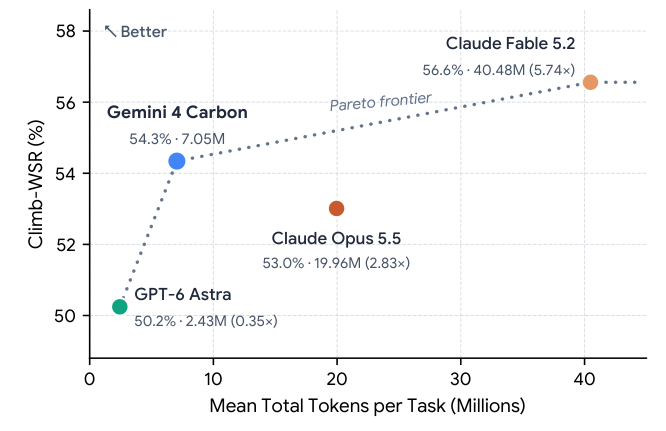
正式テストでは、4つのモデルはいずれも回帰項目で95%を超える得点だった一方、挑戦項目のほうが差が出やすい。Claude Fable 5.2、Gemini 4 Carbon、Claude Opus 5.5、GPT-6 Astra の挑戦項目得点は、順に 56.6%、54.3%、53.0%、50.2% だった。Fable が最高得点ではあるが、上位3モデル間の差は統計的に有意ではなかった。これに対し、Fable と Carbon の得点は、いずれも Astra より有意に高かった。
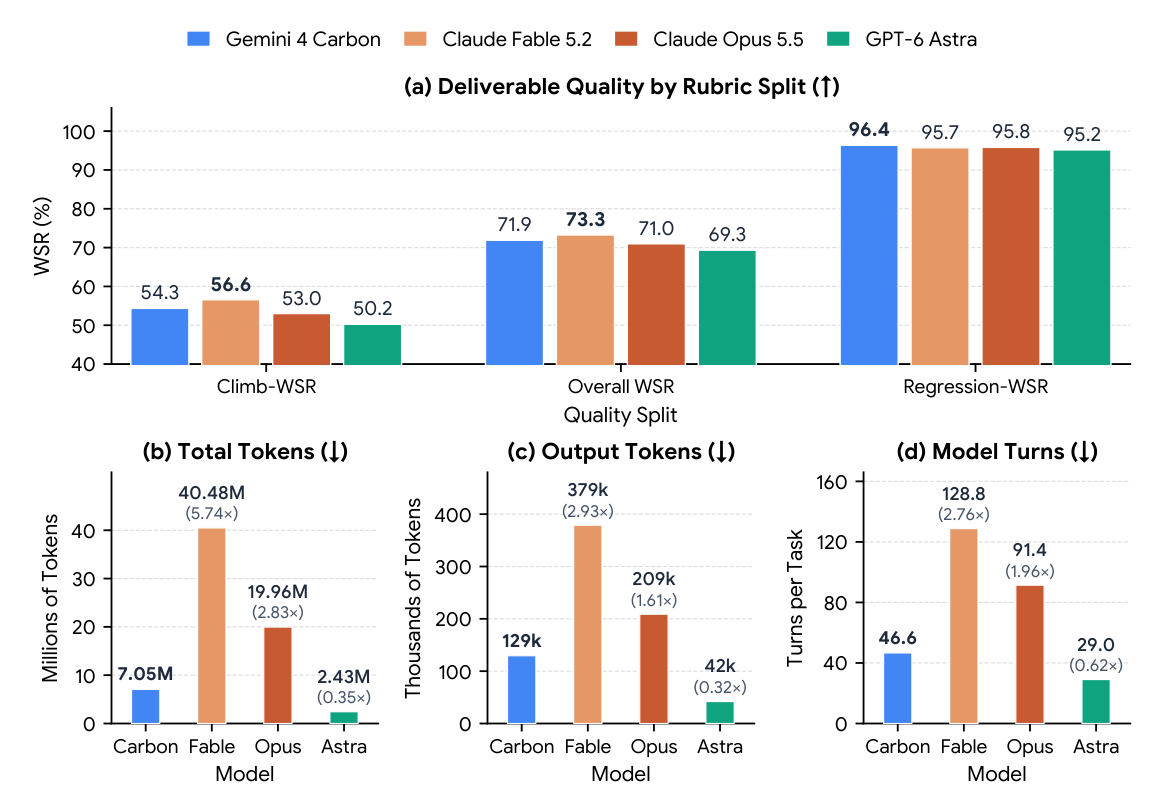
成果物の品質が近くても、作業完了までの時間と費用は大きく異なる場合がある。 Fable と Carbon の総得点は、それぞれ 73.3% と 71.9% だった。Fable は1タスクあたり平均で約129ラウンドを実行し、所要時間は83.2分、Carbon は約47ラウンド、29.2分だった。Fable の総トークン使用量は Carbon の約5.7倍だった。論文で採用された公開価格に基づき、プロンプトキャッシュを勘案すると、1タスク完了時の平均 API 費用はそれぞれ 35.28 ドルと 5.63 ドルだった。Astra は1タスクあたり平均18.5分と、4モデル中最も速く、挑戦項目の得点も最も低かった。
上記の比較は、タスク全体としてのパフォーマンスを測定している。画像を直接見る行為がどれほど効果的だったかを単独で判断するため、研究者らは Carbon で対照実験も行った。画像閲覧ツールを無効化し、同時に文字認識、コード実行、画像処理機能は維持した。 別の専門業務ベンチマーク GDPval では、ツールを無効化する前後の総得点はそれぞれ 88.1% と 88.2% で、ほとんど変わらなかった。同じ変更を MKA で行うと、総得点は4.58ポイント、挑戦項目得点は5.94ポイント低下した。同時に、平均インタラクション回数は28%増加し、出力トークンは40%増加した。
余分な計算はどこに使われたのか。実行ログを見ると、画像を直接見る能力を失った後、Carbon は機械図面上の寸法を測定するスクリプトを書き、時には局所画像を文字図に変換して、部品の位置を認識しようとした。これらの手法は、線が明瞭な図面から主要な幾何学的関係を復元できるが、細かい隙間を見落としやすい。
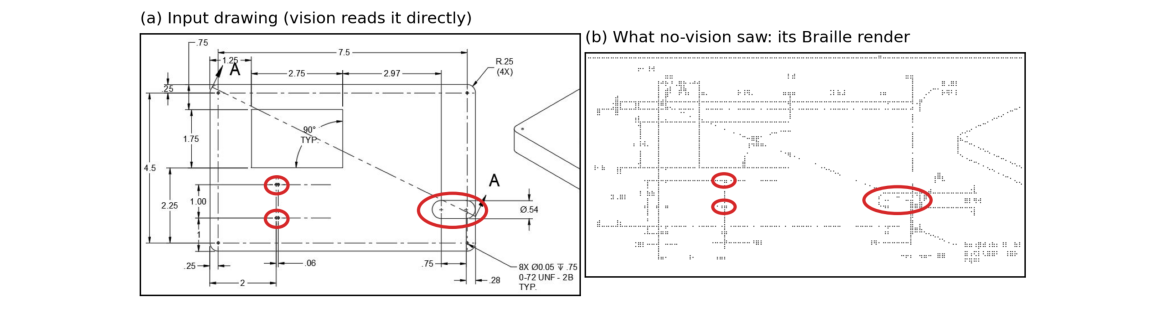
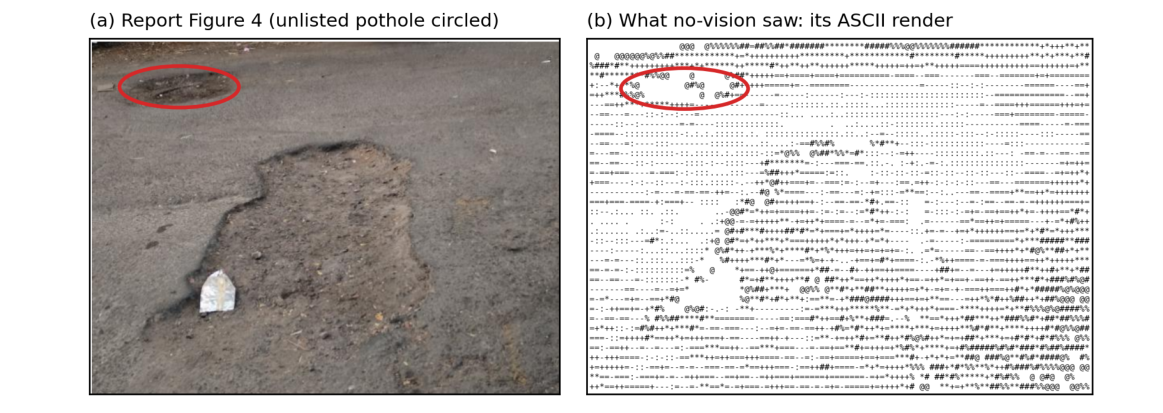
道路巡回点検の写真や医用画像では、スクリプトを何度も調整しても局所的な特徴を判別しきれないことがある。論文分析の一部のケースでは、画像ビューア機能を無効にすると、難問項目のスコアが約34~72ポイント低下した。
2つの評価で同一の変更に対する反応が異なるのは、タスク完了に必要な情報に理由がある。GDPval では多くの重要な情報がテキストや表から直接抽出できるのに対し、MKA では結論を左右する細部が画像の中にしか存在しないことがある。
おわりに
MKA は、画像を読み取ることが専門業務の中で実際に生じる場所に、それを再び位置づけている。部品の隙間がはっきり確認できたかどうかは、最終的には技術レポートがそれに応じたリスクを指摘しているかどうかに現れる。建物が正しく照合できたかどうかは、それが太陽光発電の立地選定リストに含まれるべきかどうかに直結する。エージェントがこれらの業務をこなせるかどうかを評価するには、画像から何を読み取れるかを見るだけでなく、その情報が後続の計算や最終判断に正確に反映されるかも見る必要がある。現時点では、各モデルは正式タスクごとに1回だけ回答し、画像ビューア機能を無効にした実験も Carbon でのみ実施された。専門的な用途にとって、まだ検証すべきなのは、同じ仕事を繰り返しモデルに依頼したときに、結論を左右しうる細部が安定して識別できるかどうかである。