Command Palette
Search for a command to run...
論文週報丨8本の論文がAgent Harnessの新進展にフォーカス、コーディングエージェント/身体性制御/画像・動画生成をカバー
AI Agentが単純なQ&Aから複雑なタスク実行へと移行するにつれて、Agent Harnessはエージェント研究における重要な方向性として徐々に浮上しています。 これは大規模言語モデル、ツール、実行環境を接続する実行フレームワークであり、タスクフローの編成、コンテキストとメモリの管理、ツール呼び出しの調整、および実行中のエラー処理と結果検証を担当します。簡潔に言えば、モデルがエージェントの「思考」を決定する一方、Harnessはそれらの能力が安定かつ信頼できる実際の行動へと変換されるかどうかを大きく左右します。
なぜHarnessへの関心がますます高まっているのでしょうか? モデルの推論および生成能力の向上に伴い、エージェントが直面する課題は単に正しい答えを生成するだけでなく、マルチステップタスクを連続して完了する方法、誤った操作を減らす方法、異なる実行環境への適応、そして自律的な行動過程におけるリスク制御へと拡大しています。Harnessはモデル実行を支える基礎的なフレームワークから、エージェントの実行効果、適用範囲、およびセキュリティに影響を与える重要なインフラへと徐々に進化しています。
これらの課題を巡り、最近の研究ではHarnessの設計、評価、最適化について多角的なアプローチが模索されています。ある研究では、統制実験を通じてプランニング、ツール、コンテキスト管理の役割を分析し、別の研究ではターミナル操作、ロボティクス制御、視覚生成においてより信頼性の高い実行メカニズムを探索しています。さらに、セキュリティ制約、自動構築、再帰的自己改善に焦点を当てる研究もあり、Harnessが単に動作するだけでなく、タスクのフィードバックに基づいて継続的に最適化されることを目指しています。
今週は、Agent Harnessに関する8件の厳選研究を紹介します。 NVIDIA、Google Cloud AI Research、ノースウェスタン大学、中国科学技術大学などの大学・研究機関からの最新の探求をまとめ、フレームワーク設計、実行制御、エンボディドAI、視覚生成、セキュリティガバナンス、エンジニアリング能力評価、再帰的最適化、自己進化などの分野をカバーしています。ぜひご覧ください!
また、HyperAI公式サイト「論文」セクションでは、AI分野の最先端成果を継続的に追跡し、関連する研究動向をいち早く把握できるよう支援しています ⬇️
最新論文を見る:
今週の論文推奨
1. Coding AgentsのためのHarness設計
論文タイトル:
An Empirical Study of Harness Design for Coding Agents
論文および詳細解説:
この研究は、コーディングエージェントのHarness設計について体系的な実証分析を行い、基盤モデルが一定である条件下で、異なる実行メカニズムがタスクパフォーマンスにどのように影響するかを重点的に検証しました。研究者たちは、プランニングメカニズム、アクション空間、コンテキスト管理という3つの主要コンポーネントに焦点を当てた統制実験を実施し、Harnessの各構成要素がタスク成功率、実行効率、リソースコストに具体的にどのような影響を与えるかを明確にすることを目指しました。これにより、完全なシステムの最終的なパフォーマンスのみに基づいて特定の設計の有効性を判断することを避けます。
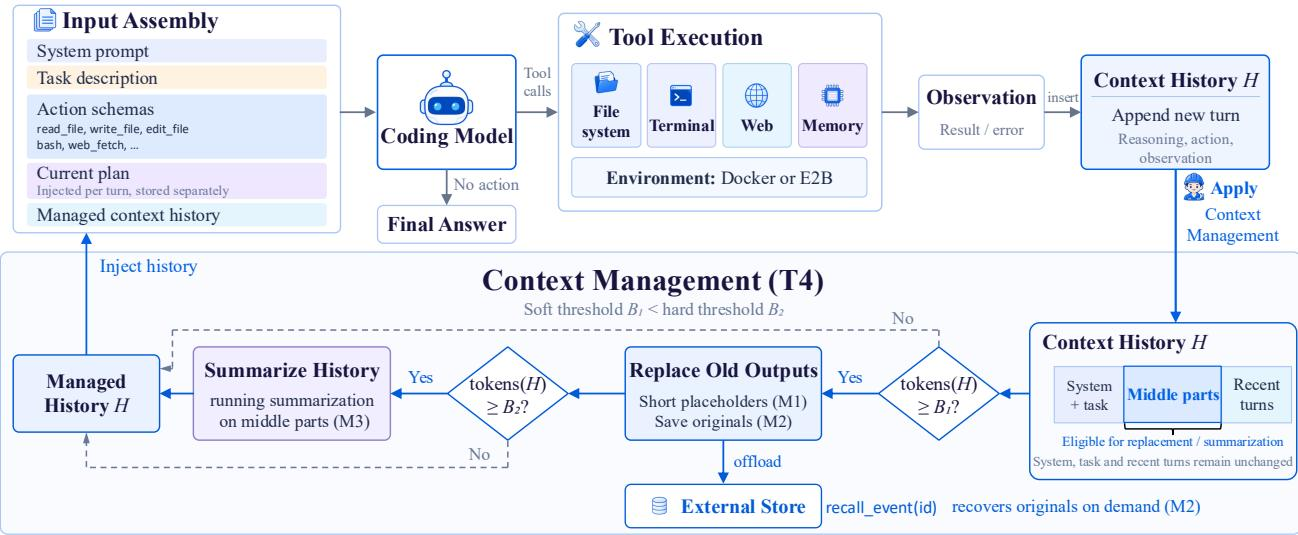
研究チームは、SWE-Bench VerifiedやTerminal-Bench 2.1などのベンチマークにおいて、複数のマッチング実験を実施しました。その結果、コンテキスト管理は長期的なタスクにおいて特に重要であり、履歴情報の適切な処理により、コンテキスト溢れによる失敗を軽減できることが示されました。プランニングメカニズムの利点はモデルの能力によって異なり、ツールインターフェースの選択もモデルの特徴に合わせて調整する必要があります。Harnessは構成要素が多ければ多いほど良いわけではなく、タスク要件、モデル能力、リソース予算に応じて設計すべきであり、今後の定量的なHarness最適化研究のための実証的基盤を提供しています。
2. Mid-Harness
論文タイトル:
Mid-Harness: Scaling Actions Between Model and Harness for Terminal Agents
論文および詳細解説:
NVIDIA、韓国科学技術院(KAIST)などの研究機関の研究者たちは、Mid-Harnessを提案し、大規模言語モデルと実行フレームワークの間にアクションサンプリングおよび検証メカニズムを導入することで、ターミナルエージェントの実行信頼性を向上させる方法を探索しました。従来のターミナルAgentは、モデルが生成したコマンドを直接実行するのが一般的ですが、誤った操作は実行環境を変更し、後続のタスクに影響を与える可能性があります。モデル自体がより優れたコマンドを生成する能力を持っていても、初回試行で最良の選択肢を提示できるとは限りません。Mid-Harnessは、実際の前に複数の候補アクションを生成し、バリデータによる比較およびフィルタリングを通じて、不適切な操作がタスク進行に与える影響を低減します。
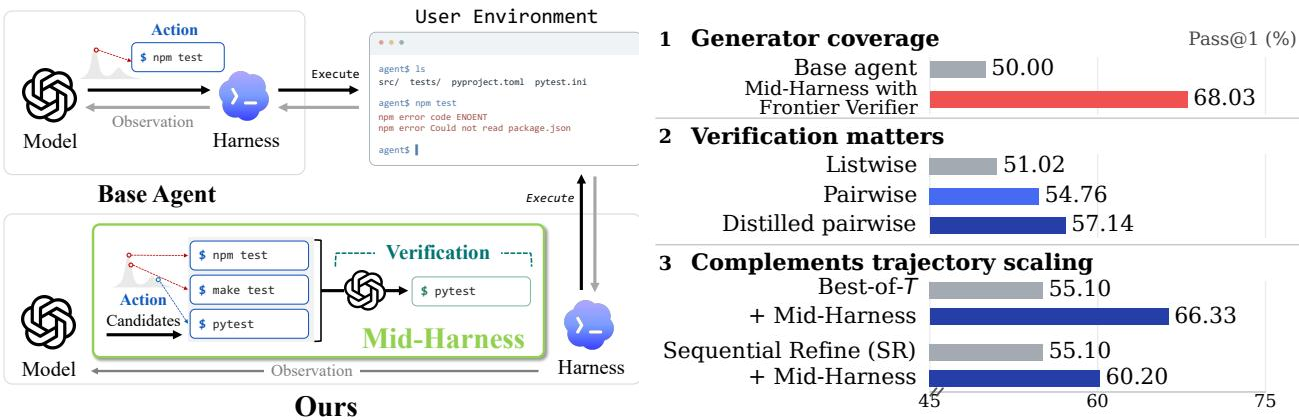
研究チームは、候補アクションのサンプリング方法、バリデータの選択、および異なる実行戦略に関する実験を実施し、モデルとHarnessの間で追加の計算リソースを割り当てる実用的価値を分析しました。その結果、候補アクションを増やしても必ずしも利点が得られるわけではなく、その効果はバリデータがより優れた操作を識別できるかどうかに依存することが示されました。適切な比較およびフィルタリングメカニズムは、アクションの質を向上させ、タスク全体の実行経路の成功率を改善します。この研究は、単にモデルの生成能力を向上させることだけでなく、実行前のアクション選択へと最適化の重点を移し、より信頼性の高いターミナルエージェントを構築するための新たな視点を提供しています。
3. Show-Harness
論文タイトル:
Show-Harness: Just a VLM Agent Can Play Robots
論文および詳細解説:
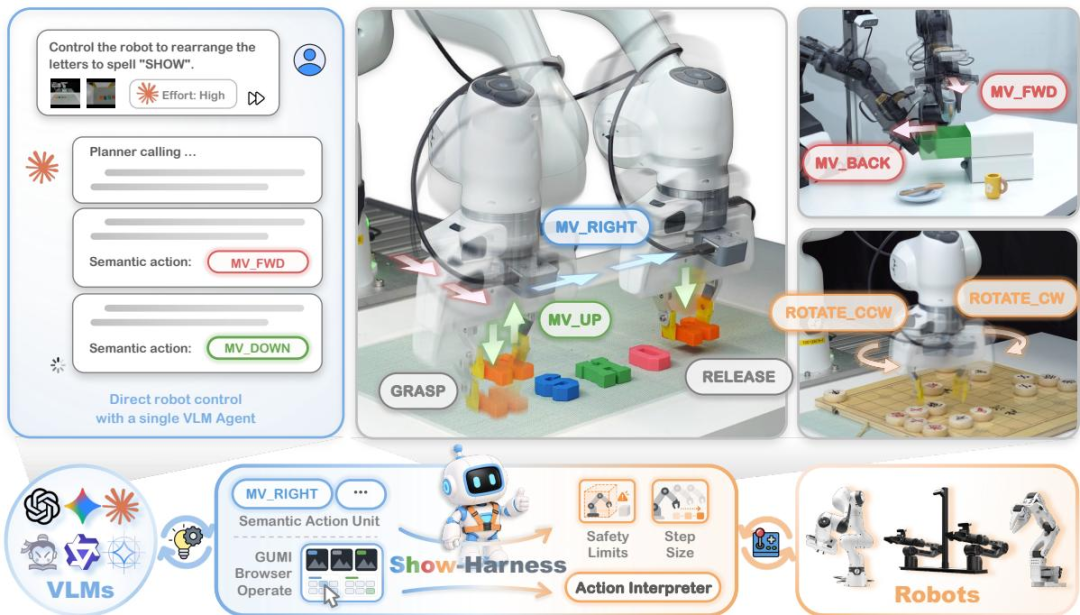
研究者らは、視覚言語モデル(VLM)が視覚理解と言語推論能力を実際のロボット操作にどのように変換するかという課題を解決するために、Show-Harnessを提案した。従来のロボットシステムは、視覚-言語-行動モデルの専門的な訓練を必要とするか、あるいは高次モデルが生成した指示を実行するための独立したコントローラーに依存するのが一般的であった。Show-Harnessは、ロボットの操作をモデルが理解・推論できる離散的な行動ユニットとして表現するセマンティック行動インターフェースを設計し、さらに特定のロボット向けに設計されたインタープリターが、これらの行動を実際の制御コマンドに変換する仕組みを導入した。また、研究チームはGUMI(GUI Manipulation Interface)を開発し、グラフィカルユーザーインターフェースを通じてロボットの操作デモを収集することを可能にし、専用テレオペレーションハードウェアへの依存度を低減した。
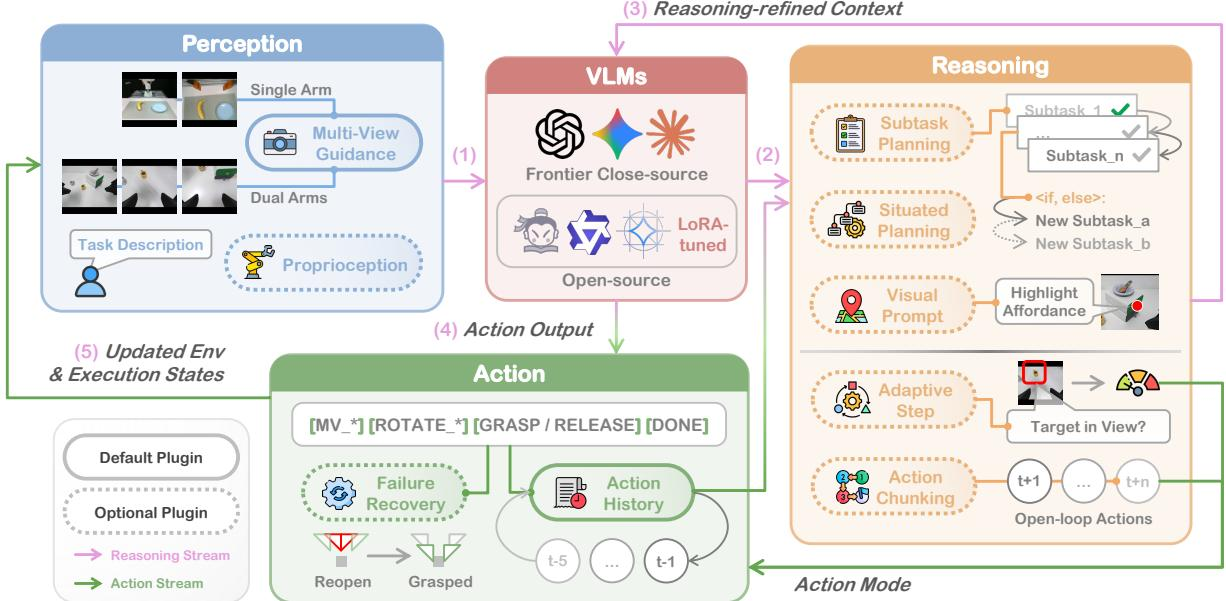
研究チームは、複数のタスク、ロボット形態、環境において評価を実施し、このフレームワークがゼロショット制御および軽量ファインチューニングのシナリオでどのように機能するかを検証した。結果は、Show-Harnessが最先端のVLMに対し、専門的なファインチューニングを行わずとも多様なロボット操作タスクを実行させられること、また比較的軽量のファインチューニングにより小型のオープンソースモデルにも適応できることを示した。さらに、文脈ベースのプランニング、行動履歴の記録、失敗からの復旧といったメカニズムが、実行の安定性を向上させることが明らかになった。この研究は、モデルと環境間のインタラクションインターフェースを適切に設計することで、基礎VLMが既に備えているエンボディメント(身体性)能力を解放し、Harnessがソフトウェア実行フレームワークから物理世界での行動制御層へと発展する可能性を示唆している。
4. MaLiang-Harness
論文タイトル:
MaLiang-Harness: A Programmable Path to Image and Video Generation
論文および詳細解説:
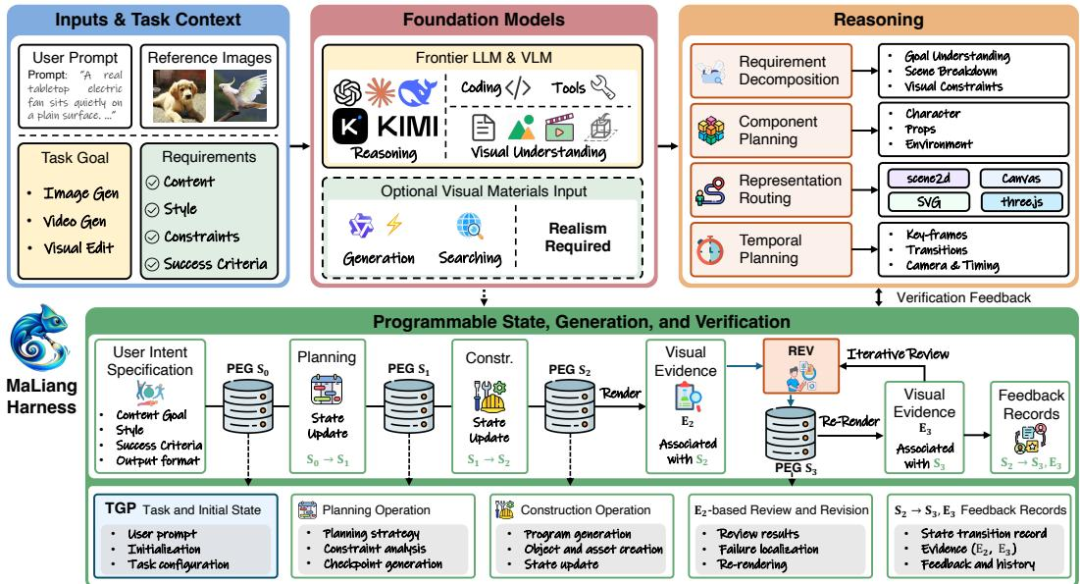
研究者らは、Harnessの設計理念を画像および動画生成分野へと拡張する方法を模索するため、MaLiang-Harnessを提案した。従来のプログラマティック生成手法は、明確な構図やアニメーション制御を提供できるものの、プログラムが正常に実行されたとしても、最終的な視覚結果がユーザーの期待に沿うとは限らない。この問題に対処するため、本フレームワークはマルチモーダル大規模言語モデルに基づく視覚生成を、継続的な構築、チェック、修正のプロセスとして組織化する。実行可能なプログラムやタスクコンテキストの保存、編集履歴およびレンダリング根拠の追跡、現在バージョンに対する検証を通じて、視覚生成プロセスのトレーサビリティ(追跡可能性)、リカバリー可能性(復元可能性)、および反復性を向上させる。
研究チームは、画像および動画生成能力を評価するためにMaLiang-IBenchとMaLiang-VBenchを構築し、複数の最先端マルチモーダル大規模言語モデルでテストを実施した。その結果、GPT-6-Astraは両方のベンチマークで100%の生成成功率を達成したが、すべての視覚品質閾値を満たした画像タスクは96.0%、動画タスクは76.9%であった。この結果は、プログラムの実行成功と最終的な視覚品質の達成が異なる評価軸であることを示唆している。また、汎用モデルの能力スコアが類似していても、視覚生成タスクにおけるパフォーマンスが同じであるとは限らない。本研究は、プログラマティックな視覚生成のための体系的な実行フレームワークを提供するとともに、Harnessの生成AIシーンにおける応用範囲を拡大するものである。
5. EvoSafeHarness
論文タイトル:
EvoSafeHarness:Evolving Model- and Domain-Specific Harnesses for Securing Agents
論文および詳細解説:
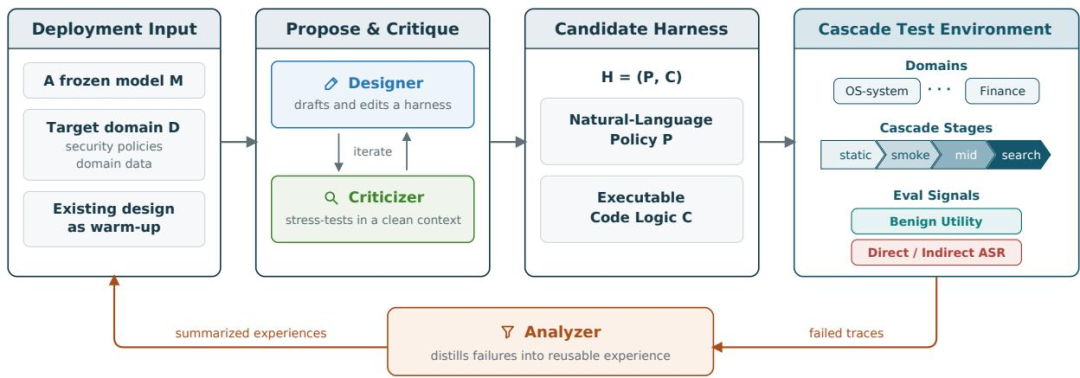
研究者らは、エージェントが直面する直接的な有害なリクエストや間接的なプロンプトインジェクションに対するセキュリティ保護の課題を解決するために、EvoSafeHarnessを提案した。従来のセキュリティ制約は、専門家によって事前に設計され、異なるモデルやタスクドメインに適用されることが一般的であったが、モデルごとの挙動特性やドメインごとのリスク要件は多様であり、固定ルールでは通常タスクを過度に制限したり、特定のシナリオにおけるセキュリティリスクを見逃したりする可能性がある。EvoSafeHarnessは、セキュリティ制約の設計を最適化可能なプロセスとして捉え、自然言語によるセキュリティポリシーと実行可能なコードロジックを共同で調整する。さらに、ターゲットモデルの挙動フィードバック、ドメイン規範、敵対的審査を組み込むことで、特定のデプロイ環境により適した制約スイートを生成する。
研究チームは、複数のエージェント安全性ベンチマークにおいて評価を実施した。DecodingTrust-Agent の関連テスト設定では、本手法により平均攻撃成功率が 45.6% から 10.0% に低下し、ユーティリティの損失は約 3.3 ポイントにとどまった。AgentDojo の特定の評価設定では、攻撃成功率は 0.0% に低下し、通常タスクのユーティリティは 82.8% に達した。これらの結果は、モデルとドメインにカスタマイズされた安全メカニズムが、安全性とタスクユーティリティのバランスを改善する可能性があることを示している。ただし、セキュリティ性能は依然として攻撃の種類、タスク環境、および評価範囲に依存する。本研究は、Harness の役割をタスク実行からリスク管理へとさらに拡張し、エージェントがタスクを完了すると同時に、対応するセキュリティ境界を遵守する方法を探究した。
6. Doc 2 Harness
論文タイトル:
Doc2Harness: Benchmarking LLMs on Long-Horizon Harness Engineering of Coding Agents
論文および詳細解説:
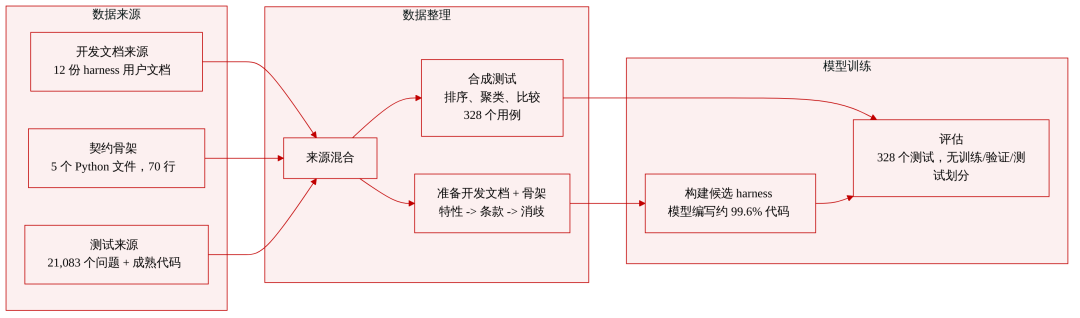
研究者らは Doc2Harness を提案し、大規模言語モデルが完全な Agent Harness を構築するエンジニアリング能力を直接評価することを目指した。従来の研究は、事前に設計された実行フレームワーク内でエージェントのタスクパフォーマンスをテストすることが一般的であったが、モデルが開発ドキュメントやインターフェース契約に基づいて、実際に動作する実行フレームワークを独立して構築できるかどうかを検証するケースは少なかった。Doc2Harness は評価を2段階に設計した。第1段階では、構築モデルがインターフェース契約と開発ドキュメントに基づいて候補となる Harness を生成する。第2段階では、研究チームが隔離環境でそのフレームワークを実行し、モデルのリクエスト、ディスクファイル、プロセス終了コード、コマンド出力などの観測可能な情報を通じて、その実際の動作が要件を満たしているかを確認する。
研究チームはこのベンチマークを使用して19の最先端モデルを評価し、各モデルに対して328個のテストケースで3回の独立した構築を行った。結果は、最も高性能な GPT-6 Astra の合格率が 53.05% であった一方、最も低いモデルは 27.44% であったことを示した。最も高性能なモデルであっても、半数近くのテストケースを通過できなかった。失敗の主な問題は、複数のモジュールにまたがる機能の実装、および異なるモジュール間の責任分担に集中していた。この研究は、モデルがコードを生成できることが、複雑な実行インフラストラクチャを構築する完全なエンジニアリング能力をすでに備えていることを意味するわけではないことを示している。Doc2Harness は、長期的な Harness エンジニアリング能力を測定するための確定的な評価ベンチマークを提供し、エージェントフレームワークの自動構築能力を改善するための参考資料ともなる。
7. Harness²
論文タイトル:
Harness²:Recursive Agent Harnessing for an Open World
論文および詳細解説:
エージェントが絶えず変化する、事前に定義することが難しい現実的なタスクに直面した際、従来の人手による設計と固定設定に依存する Harness は、適時に対応することが困難であることが多かった。この問題に対処するため、Harness² が提案され、エージェントがタスクを完了できるだけでなく、実行中に自身のランタイムフレームワークを継続的に改善できることを試みた。本手法は、相互に関連する2つの再帰レベルを構築した。タスクレベルの再帰では、Propose–Probe–Compose プロセスを通じて、現在のタスクに対して候補となるフレームワークの変更を提案し、比較テストを実行した上で、実際のトラジェクトリとタスクの出力に基づいて採用するかどうかを決定する。フレームワークレベルの再帰では、これらの変更から再利用可能な経験を抽出し、その後のフレームワーク最適化の方法を段階的に更新する。タスクの正誤を直接判定できる標準的な解答がない場合でも、システムは異なる設定下での実行パフォーマンスを比較することで、フレームワーク調整の根拠を提供できる。
研究チームは、3つの専門ベンチマークと4種類のモデル-フレームワーク構成において評価を実施した。実験では、単一のフレームワーク改善により、GLM-5 と Gemini 3.5 Flash の複数のベンチマークでのパフォーマンスが向上することが示された。WorkBuddy-Bench では最大 11.5 ポイントの向上、JobBench では 4.5 ポイントの向上、LAB では 11.8 ポイントの向上が確認された。タスクレベルの再帰予算が増加するにつれて、パフォーマンスの向上幅はさらに拡大する可能性がある。Harness² の意義は、「現在のタスクの完了」と「経験の蓄積・その後のタスクの改善」の間のつながりを打ち破ろうとすることにある。これにより、Harness は使い捨ての設定から、新しいタスクに持続的に適応できる実行システムへと徐々に変化し、オープン環境下でのエージェントの自己改善に対する新たなアプローチを提供する。
8. Self-Evolving Agent Harness
論文タイトル:
Self-Evolving Agent Harness
論文および詳細解説:
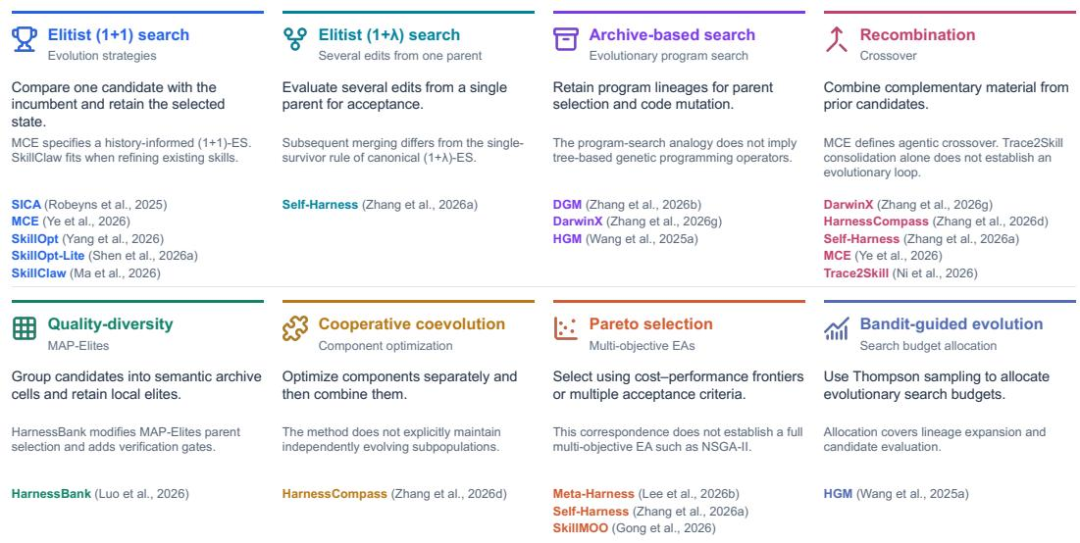
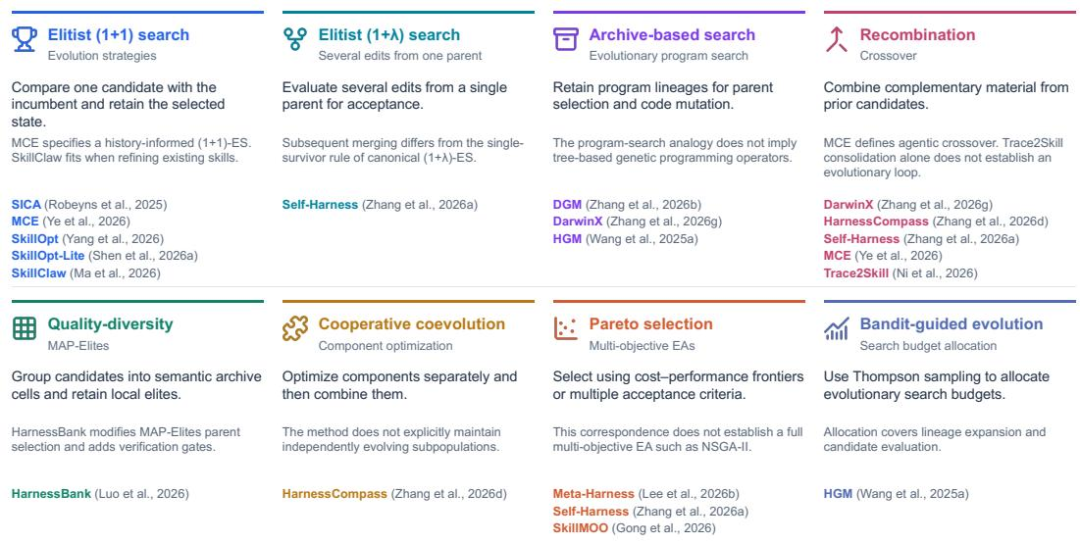
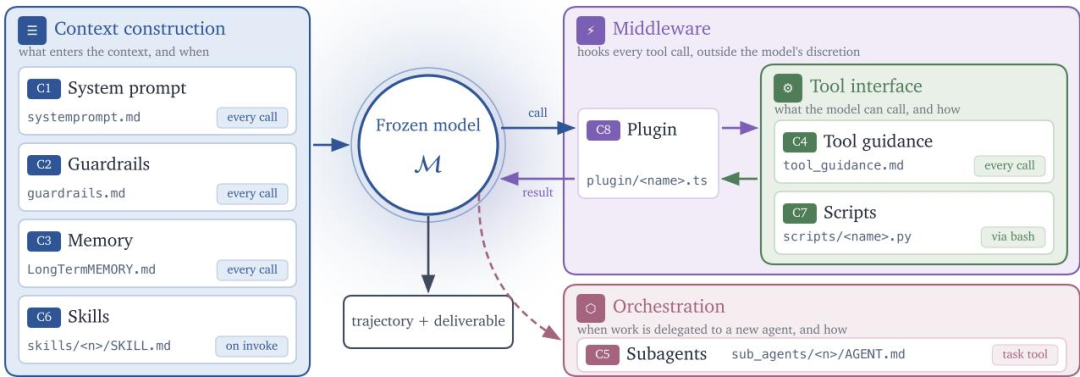
もし前述の研究がHarnessの設計、行動の制御、またはタスクパフォーマンスの再帰的最適化に焦点を当てていたとすれば、本研究はさらに全体的な問いを提起する。すなわち、エージェントが長期的に稼働する際、Harnessは継続的な自己更新メカニズムを形成しうるか、というものである。本研究は「自己進化」を、フィードバックに駆動された継続的な修正プロセスとして定義する。基盤となるモデルの重みを変更することなく、システムは実行経験に基づいてプロンプト、メモリ、ワークフロー、および実行可能コンポーネントを調整し、承認された変更を保持して、その後の稼働に活用する。調整対象には単一のモジュールだけでなく、ツールとコード、リポジトリレベルの制御ロジック、さらには異なるプラグインやコンポーネント間の組み合わせ関係も含まれる。同時に、本研究は、修正の提案、修正の有効性の判断、そして正式な採用の決定は、それぞれ別々に処理すべき3つの段階であり、単一のタスクパフォーマンスの向上のみをもって、その変更が長期的な価値を持つと判断すべきではないことを強調している。
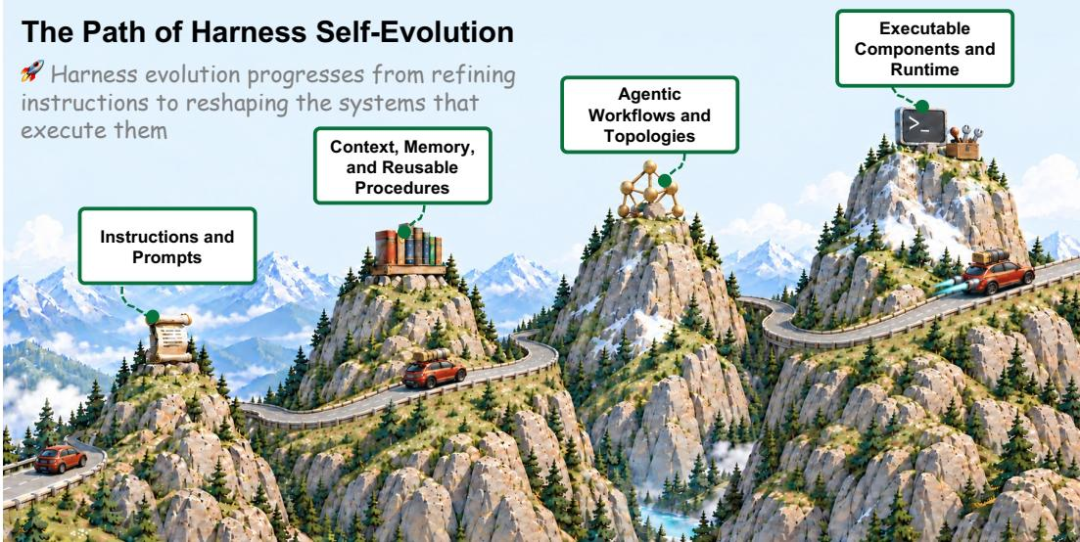
理論的な側面において、論文は進化最適化と継続的PAC学習を組み合わせて、Harnessの継続的な更新時に直面しうる一般化の問題やパフォーマンスの後退を分析し、明確な仮定の下で、期待される一般化限界、履歴的回帰予算に関連する保持限界、および完全に独立した検証データに基づく候補変更の受け入れ規則について議論している。特定のベンチマークでのスコアの単純な比較とは異なり、本研究は、Harnessが反復的なイテレーションの中で有効な経験を保持し、同時に過学習、忘却、および旧タスクでのパフォーマンス低下を軽減する方法により注目している。論文はまた、タスク分布の変化、評価器のバイアス、そして科学的信頼性、物理的安全、組織的説明責任などの展開上の課題についても議論し、継続的な検証と独立した安全対策が依然として不可欠であることを指摘している。本研究が描く方向性は、Harnessがモデルの周りに構築された静的なソフトウェア構造にとどまらず、フィードバックを蓄積し、慎重に自己を修正し、継続的な検証を受け入れることが可能なシステムへと進化しうるというものである。