Command Palette
Search for a command to run...
大量の土壌微生物データの注釈が困難な中、BBERTは100bpの短リードから分類学的および機能的手がかりを抽出
微生物生態系は極めて複雑な構成要素を持っており、この複雑さを理解することは、生物圏の維持に関わる各種プロセスを解明する上で不可欠である。この作業には、大量のシーケンシング・データセットの分析が必須となる。現在、こうしたデータ資源は非常に豊富であり、地球上のあらゆる生物群系をカバーする数千件の公開メタゲノムデータセットが無料で入手・ダウンロード可能となっている。
これらのデータの中でも、土壌メタゲノムは特に重要な研究価値を持つ。 土壌のような複雑な環境におけるショットガン・メタゲノミクス(Shotgun Metagenomics)シーケンシングは、極めて豊かな生物多様性を明らかにする。しかし、十分に包括的なリファレンスデータベースの欠如により、ショットガン・シーケンシングで生成された大多数の短読配列(Short Reads)に対して正確な分類学的または機能的注釈を付与することができず、微生物群集の真の構造と機能を包括的に解析することが困難であった。
こうした背景のもと、エルサレム・ヘブライ大学の研究チームは、短読配列解析に最適化されたヌクレオチド大規模言語モデル「BBERT」を提案した。 研究者たちは大規模な土壌メタゲノムデータセット上でテストを実施し、BBERTがリファレンスデータベースに依存することなく細菌配列の構文的特徴を認識し、長さがわずか100 bpの短読配列から、分類ドメイン(Taxonomic Domain)、コード化能力(Coding Potential)、および読み取り枠(Reading Frame)を正確に判定できることを発見した。さらに、BBERTモデルは短いメタゲノム読配列を細菌アミノ酸配列へ直接変換することが可能であり、その後の研究や応用に資する。デノボ(de novo)メタゲノムアセンブリーにおいても、BBERTは優位性を示す。アセンブリープロセスにおけるミスマッチやギャップを削減すると同時に、実行時間を短縮するのだ。研究者たちはさらに、野生マメ科植物の根粒のメタゲノムデータを用いて検証を行い、BBERTによるデータフィルタリングにより、ビニング(Binning)の質が著しく向上するだけでなく、デノボアセンブリーの速度も大幅に加速されることを示した。
関連する研究成果は「Fast and accurate taxonomic domain assignment of short metagenomic reads using BBERT」という題名で、Nucleic Acids Research誌に掲載された。
研究のハイライト:
- BBERTは、従来大規模言語モデルに基づく手法が抱えていたスループットと精度の限界を同時に克服した
- メタゲノム解析の前にBBERTを用いて事前フィルタリングを行うことで、機能注釈の速度向上、デノボアセンブリーの質の改善、アセンブリーエラーの削減、およびビニングの質の改善が可能となる
- BBERTは短読配列に対して迅速でリファレンスデータベース不要な分類手法を提供し、既存の大量のメタゲノムデータアーカイブの研究価値を解き放つことが期待される
論文リンク:
https://academic.oup.com/nar/article/54/19/gkag1002/8971853?login=false
データセット:細菌ゲノムからの学習から複雑なメタゲノム環境での検証まで
BBERTの開発と評価のプロセスにおいて、研究者たちは2種類のデータセットを整理・構築した。
- 第1の種類はモデルの事前学習用であり、1416種の細菌種由来のゲノムデータを含む。 データが細菌の進化系統樹を十分にカバーするように、RefSeqデータベース内の各細菌科からランダムに2つのゲノムを選択した。
- 第2の種類はモデルのキャリブレーションと評価用であり、396属由来の899種の細菌、および823属由来の1200種の真核生物を含む。 注目すべきは、これら2種類のデータセットは属レベルの分類階層において完全に分離されており、属の重複が一切存在しない点である。
同時に、土壌環境における真核生物の多様性を代表するよう選別されたリファレンスゲノムデータセットを構築するため、研究者たちはまず土壌微生物群集の18S rRNAおよびITSアンプリコン・メタバーコーディング研究(Amplicon Metabarcoding Studies)を調査し、対象とする分類群のリストを決定した。関連する研究には、地球微生物組計画、汎ヨーロッパLUCAS土壌調査プロジェクト、および世界中の土壌原生生物と真菌の多様性に関する調査研究が含まれる。
上記の文献の総合分析により、土壌微生物群集において常に高い豊度を示す主要な8つの真核生物系譜が特定され、それぞれ以下の通りである:
- 糸足虫類(Cercozoa)
- 繊毛虫類(Ciliophora)
- 卵菌門(Oomycota、異鞭毛類群)
- 球囊菌門(Glomeromycota、すなわちアーバスキュラー・マイコリザ真菌)
- 接合菌門(Mucoromycota)
- 子嚢菌門(Ascomycota)
- 自由生活線虫(Free-living Nematoda)
- 変形虫類(Amoebozoa)
さらに、データセットには土壌環境に関連する緑藻門、およびゲノム配列データが存在する陸生植物分類群も追加収録された。
種分類過程におけるランダム性の影響を考慮し、属という分類階層に基づいて、キャリブレーションデータセットと評価データセット内のすべてのゲノム登録エントリを、それぞれ20の均等なグループに分割した。その際、細菌と真核生物をそれぞれ20グループに分類した。各グループ内では、対数正規分布(Log-normal Distribution)に従って種多様性をランダムに割り当てた。その後、両データセットのグループをペアごとに統合し、20の組み合わせサブセットを作成した。各サブセットは、細菌と真核生物の属構成が独立している。この20個のサブセットのうち、最初の10個(データセット1~10)はモデルのファインチューニングに使用し、残りの10個(データセット11~20)はモデル評価のために保持した。
BBERT フレームワーク:大規模言語モデルが DNA 配列から細菌の特徴を学習する
BBERT は BERT アーキテクチャに基づいて開発されたモデルであり、細菌ゲノム由来のヌクレオチド配列に対する分布外検出(OOD)を目的としている。その核心理念は、細菌配列のみを用いて訓練することで、与えられた配列が細菌由来かどうかを判定することである。ヌクレオチド配列に基づいて細菌ゲノムの分布外検出を行う大規模言語モデルを構築するため、研究者らは3段階の開発プロセスを採用した。
- 細菌ゲノムリードのみを用いて BERT アーキテクチャを事前学習する。
- 細菌/非細菌分類タスクに対してファインチューニングを行う。
- 細菌リード分類タスクにおけるモデルのパフォーマンスを評価し、BERTax、Tiara、および REMME と比較する。
① モデルの事前学習
BBERT の事前学習には、サンプリングにより生成された合成短ヌクレオチド配列を含む細菌データセットが使用された。各配列の長さは 100 bp であり、メタゲノムシーケンシングリードおよびそれに伴う可能性のあるシーケンシングエラーをシミュレートすることを目的としている。 訓練過程において、研究者らはマスクド言語モデルを最適化目標として採用し、入力配列中の 30% のトークンをマスクし、文脈からこれらのマスクされたトークンを推論する能力を最適化した。この過程を通じて、モデルは既存のリード情報に基づいて欠落ヌクレオチドを特徴付ける能力を学習する。
事前学習の最適化プロセスは、5~10 エポック(Epochs)ごとに1段階として継続され、最良の結果が得られるまで行われ、すべての中間チェックポイント(Checkpoints、すなわちモデル重み)が保存された。一般的に、訓練損失が継続的に低下するにつれて、分類精度も向上することが観察された。訓練の進捗が停滞し、モデル性能に顕著な改善が見られなくなった時点で、訓練を終了した。
② モデルのファインチューニング
次に、BBERT に細菌リード分類タスクを実行させるため、研究者らはモデルに軽量な分類ヘッド(Classification Head)を追加した。BBERT エンコーダ(Encoder)によって生成されたトークン埋め込みの上に線形層を追加し、特定のリードが細菌由来であるかどうかを直接予測するものである。
この分類ヘッドは教師あり学習により訓練された。訓練過程では、事前学習済み BBERT のモデル重みを凍結せず、エンコーダと分類ヘッドを共同でファインチューニングし、エンコーダが学習した特徴表現が現在の分類タスクに適応できるようにした。事前学習重みが不安定な影響を受けないよう、分類ヘッドとエンコーダに異なる学習率を設定した。すなわち、エンコーダの学習率を 1×10⁻⁶、分類ヘッドの学習率を 1×10⁻⁵ とし、AdamW 最適化器を使用した。
研究の結果、Transformer エンコーダの下部2層を凍結し、残りの層をファインチューニングする戦略が効果的であることが明らかになった。 モデルの最終出力は、リードが細菌由来である確率(bact_prob と表記)であり、bact_prob が 0.5 を超える場合、そのリードは細菌由来と判定される。
③ モデルの評価と比較
最後に、研究者らはデータセット上でモデルの全体的な分類性能指標を集計・報告し、ベンチマークテストの結果を BERTax、Tiara、および REMME と比較した。
成果: BBERT の分類精度、機能注釈、およびアセンブリ効率が検証された
① BBERT の性能は既存の先進的な深層学習分類ツールを上回る
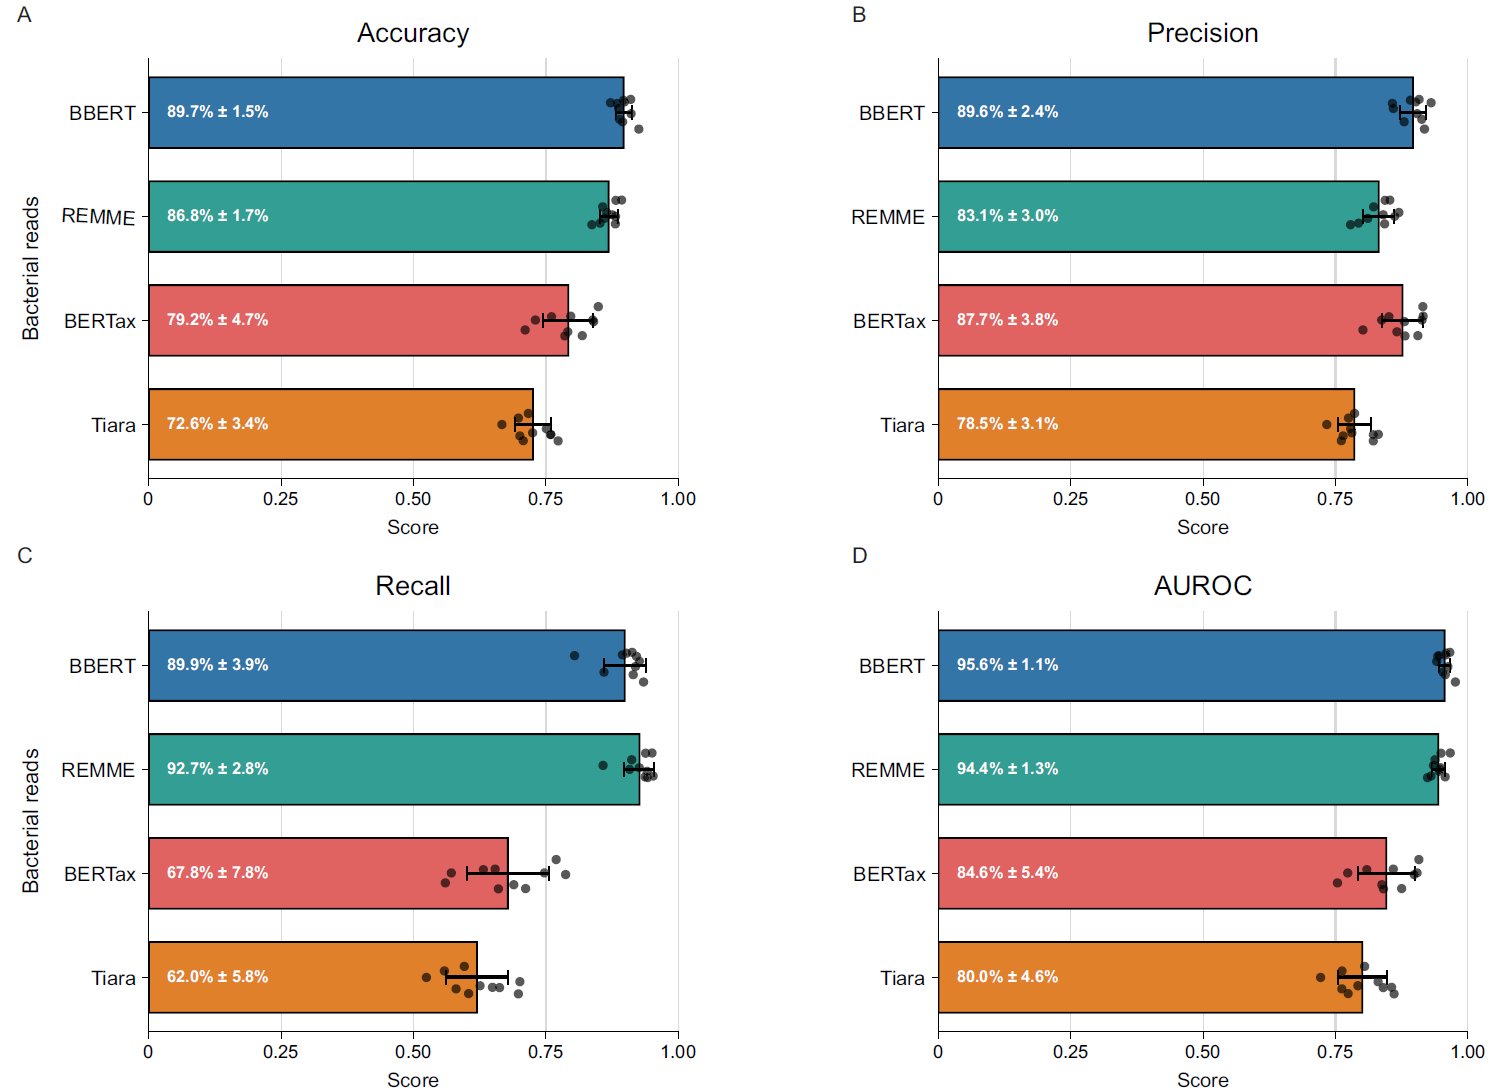
まず、細菌と非細菌リードの分類タスクにおいて、BBERT は強力な識別能力を示した —— 下図に示す通り、精度、適合率、再現率(REMME と同等)、および AUROC といった標準的な分類指標において、BBERT のパフォーマンスは BERTax、Tiara、および最適化された REMME を上回った。BBERT の10個のテストセットにおけるドメイン分類平均精度は 89.7% ± 1.7% であり、REMME は 86.8% ± 1.7%、BERTax は 79.2% ± 4.7%、Tiara は 72.6% ± 3.4% であった。
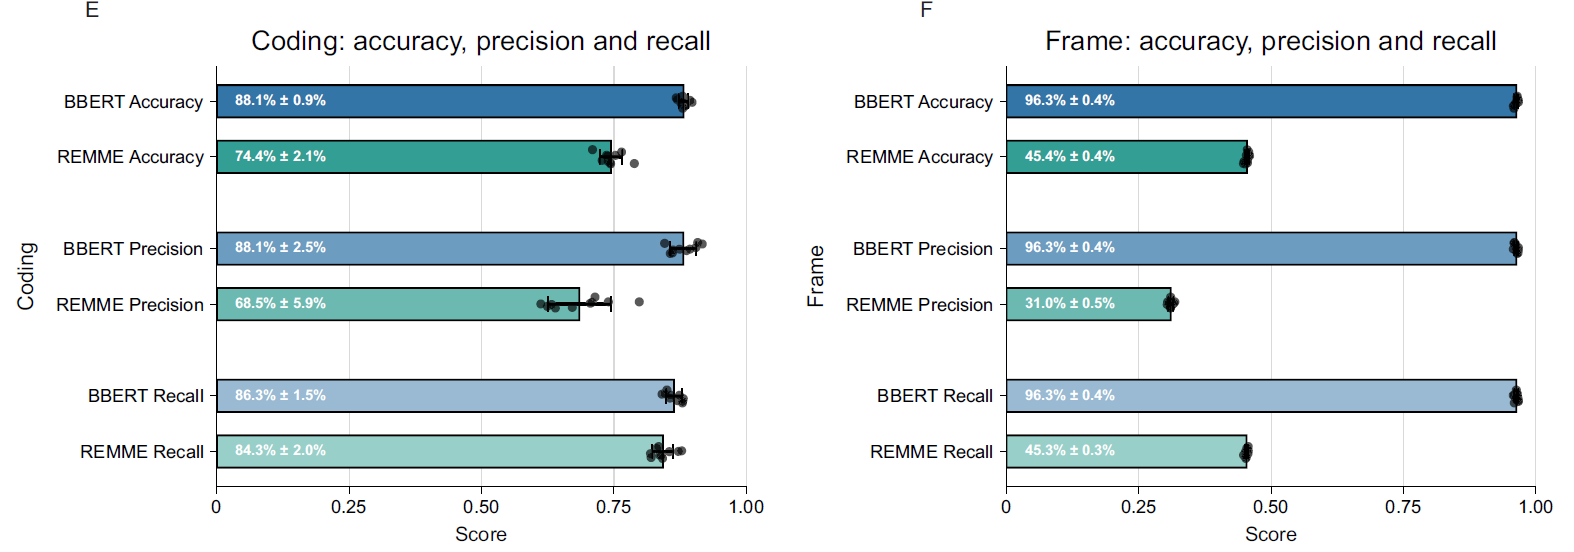
コード配列およびその読み取り枠の認識において、BBERT の性能は、この機能を備えた唯一の同種ツールである REMME を上回った(下図 E、コード精度:BBERT は 88.1% ± 0.9%、REMME は 74.4% ± 2.1%;下図 F、読み取り枠精度:BBERT は 96.3% ± 0.3%、REMME は 45.4% ± 0.4%)。
計算性能においても、BBERTは優れた実用性を示しています。 BBERTは専用NVIDIA H200 GPUを搭載した計算ノードにおいて、毎秒45,912リード(reads per second, rps)を処理可能です。一方、BERTaxとTiaraはそれぞれ413 rpsおよび347 rpsです。ただし、コード最適化後のREMMEはわずかに高速で、50,745 rpsに達します。NVIDIA RTX 3090 GPUを搭載したWindows 10パーソナルコンピュータで実行した場合、BBERTの処理速度は15,373 rpsです。これは、高性能計算クラスターに依存しなくても、ユーザーがBBERTを用いて分析を実施できることを意味し、同様の多くのツールでは実現が困難な点です。
② BBERTは高い感度を備えた細菌識別ツール
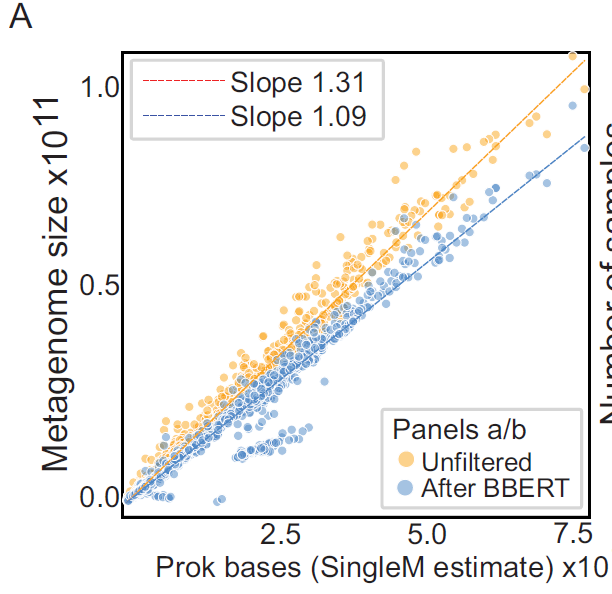
研究者らはまた、整理した1,969件の公開土壌メタゲノムデータセットにBBERTを適用し、SingleMで推定された原核生物塩基数を参照として、真の分類結果が存在しないこれらの実データにおける性能をさらに検証しました。以下の図に示すように、スクリーニングを行わない場合、メタゲノムデータ中の総塩基数はSingleMで推定された原核生物塩基数より31%多く(傾き1.31±0.01)、BBERTによるスクリーニング後にはこの差は9%まで縮小しました(傾き1.09±0.01)。
SingleMとは異なり、Kraken2は個々のリードレベルでの比較に対応しているため、研究者らはBBERTとKraken2の直接比較も実施しました。その結果、Kraken2が細菌由来と識別したリードについて、BBERTの判定結果はほぼ一致しました。同時に、BBERTはKraken2が分類できないリードの相当部分を識別できることが分かりました(以下の図参照)。逆に、Kraken2が識別できたもののBBERTが識別できなかったリードは極めて少数でした。
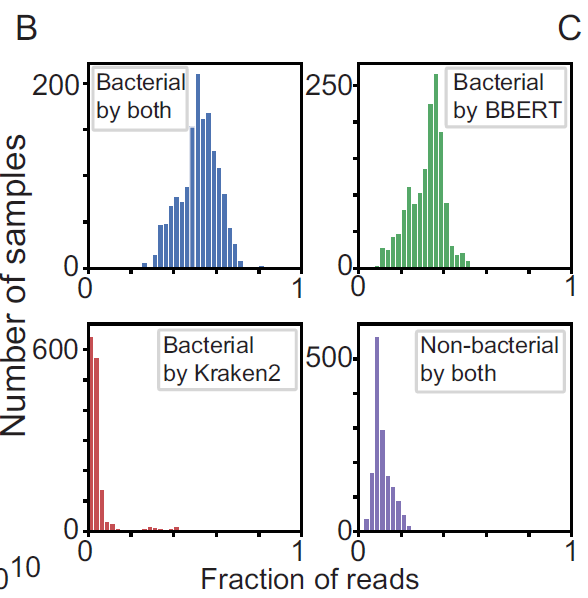
したがって、BBERTは高い感度を備えた細菌識別ツールであり、 Kraken2と同様にリードレベルでの分類が可能である一方で、参照データベースのカバレッジ不足による制限を受けません。
③ BBERTは短いDNAリードを直接アミノ酸配列に翻訳できる
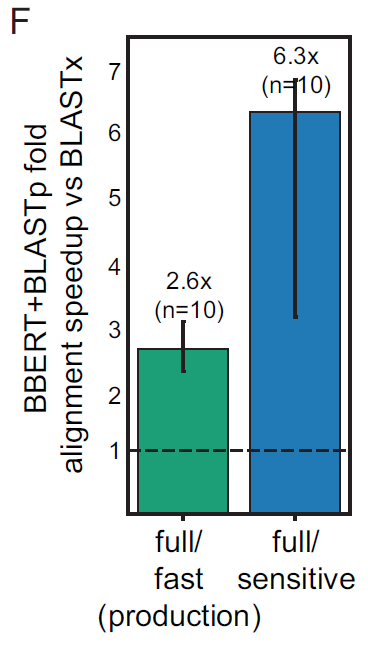
BBERTが細菌由来のコードリードおよびその読み枠を識別できるため、短いメタゲノムリードを直接アミノ酸配列に翻訳することも可能です。 研究により、スクリーニングされていないDNAリードをBLASTxでアノテーションする方法と比較して、この方法ではほぼ同等のアノテーション結果が得られるものの、処理速度が向上することが分かりました。fastモードでは約2.6倍、sensitiveモードでは約6.3倍の高速化が実現しました(以下の図参照)。これは、BBERTが研究者によるデータスクリーニングを支援できるだけでなく、メタゲノム機能アノテーションのプロセスをさらに最適化する可能性があることを意味します。
④ BBERTはメタゲノムデノボアセンブリを加速し、アセンブリエラーを低減
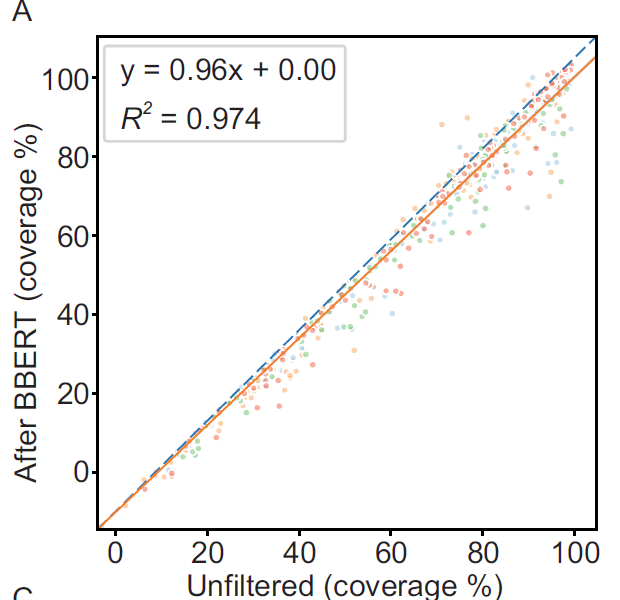
メタゲノムアセンブリにおいて、BBERTの効果はより顕著です。 研究チームは、スクリーニングされていないデータでは、多数の非ターゲット配列がアセンブリの負荷を増大させ、エラーによるギャップやミスマッチを導入する可能性があることを発見しました。シミュレーションメタゲノムデータにBBERTによるスクリーニングを適用すると、細菌ゲノム被覆率の非加重平均値は68.23%から65.22%に低下し、被覆率の損失は約4.4%でした(以下の図参照)。同時に、アセンブリ時間は66±8時間から25±2時間に短縮され、効率は約2.7倍向上しました。
アセンブリの正確性も向上した。 512のゲノムに対する加重平均を計算し、各指標を参照ゲノムの長さで正規化すると、参照配列100 bpあたりのギャップ開始回数は0.51回から0.36回へ0.15回減少し、相対的な減少率は29.3%であった。ミスマッチ回数は3.31回から2.64回へ0.67回減少し、相対的な減少率は20.2%であった。両指標を合わせた減少率は約21.4%である。
⑤ 実際のマメ科植物根粒メタゲノムデータ
BBERTスクリーニングの実データセットにおける潜在的な利点を評価するため、研究者らはさらに豆科植物の根粒メタゲノムデータに適用した。BBERTスクリーニング後の共同アセンブリ結果のサイズは61%縮小し、577.6 Mbから222.4 Mbへ減少した。コンティグ数は57%減少し、GC含量は40.4%から58.5%へ増加した。
この変化は、豆科植物ゲノムのGC含量約40%および根粒菌目ゲノムのGC含量約62%と一致しており、除去されたリードの大多数が宿主由来であることを示唆している。さらに、BBERTスクリーニングによりアセンブリ結果のN50値は倍増し、0.9 kbから1.8 kbへ向上した。アセンブリの実行時間は半分に短縮され、ピークメモリ使用量も188 GBから82 GBへ減少した。
結語
BBERTは、大規模言語モデルが短いDNA配列を処理する別の可能性を示した。参照データベースのサポートがない100 bpリードに対しても、配列自体の特徴を学習することで、分類ドメインの判定、コード可能性の認識、読み枠の予測を完了できる。さらに重要なのは、この能力がメタゲノム中の非ターゲット配列の認識に使用できるだけでなく、機能注釈、ゲノムアセンブリ、ビニングなどの下流プロセスの改善にも寄与する点である。
本研究はまた、BBERTが可動性遺伝要素などの特殊配列の認識においてバイアスを示すことが、これらの配列と宿主ゲノム間の異なる進化的特徴を反映している可能性を示唆している。将来、大規模言語モデルの独特なDNA配列パターンに対する感受性は、遺伝的水平伝播イベントの追跡に関する新たなツールを提供する可能性がある。関連モデルの発展に伴い、その応用は微生物分類からより広範な生態ゲノム学研究へと拡大することが期待される。
参考文献:
https://phys.org/news/2026-10-ai-tool-scientists-bacteria-hidden.html
https://academic.oup.com/nar/article/54/19/gkag1002/8971853?login=false