Command Palette
Search for a command to run...
Des Molécules Médicamenteuses Aux Composés Spécifiques De La Cible : L’université De Pittsburgh, Aux États-Unis, Utilise La Recherche Par Empreinte Moléculaire Pour Accélérer La Découverte De Médicaments Ciblés
传统药物发现是一项极具挑战性的工作,其核心目标是在庞大的化学空间中,识别出具有特定理想性质且能够作用于特定靶点的分子。从最初的研发构想到最终获得上市批准,一款新药的开发成本超过 26 亿美元,耗时超过 12 年。其中一个根本性挑战在于,如何在包含 1023-1060 个分子的庞大化学空间中高效搜索,从而找到同时具备目标生物活性、理化性质和可合成性的化合物。
近年来,生成式人工智能为分子设计带来了新的可能。通过学习已有分子的结构和性质,生成模型能够探索潜在的化学空间,提出具有特定理化性质或生物活性特征的候选分子。然而,如何将模型生成的分子转化为化学结构有效、实际可获取,并且具有真实生物活性的化合物,仍是这一领域面临的重要问题。
在此背景下,来自美国宾夕法尼亚州匹兹堡大学的研究团队提出了一种全谱生成式先导化合物发现(Full-Spectrum Generative Lead Discovery,FSGLD)流程,这是一种由深度学习驱动的高效药物先导化合物识别方法。 FSGLD 的核心是多尺度 DRUG-GAN 模型,能够在三个不同场景下,通过生成式模型指导药物分子的发现,包括:
(1)生成随机的类药性化合物;
(2)生成具有靶点特异性的化合物;
(3)生成具有共同化学结构的靶点特异性系列化合物。
在针对三类药理学特征各异的靶点开展的评估中,FSGLD 在识别靶点特异性候选化合物方面展现出良好的应用潜力。此外,研究还建立了一套用于热力学积分(TI)计算的计算流程,在保持计算精度的同时,将计算时间缩短了 80% 至 90%。
相关研究成果以「A Full-Spectrum Generative Lead Discovery (FSGLD) pipeline via DRUG-GAN: A multiscale method for drug-like/target-specific compound library generation」为题,已刊登 ScienceAdvances。
研究亮点:
-
FSGLD 流程不仅可以利用生成式模型设计具有类药性和靶点特异性的化合物,还能对候选化合物进行系统、高效的筛选和验证
-
研究人员构建了一个具有实用性和可扩展性的框架,有望降低临床前药物发现所需的时间和成本
-
通过该流程生成的化合物并非仅停留在理论层面的候选分子,而是具备进一步开展实验验证的可行性,能够为学术研究人员和制药行业从业者带来切实价值
论文地址:
https://www.science.org/doi/full/10.1126/sciadv.aei5257
数据集:针对三种应用场景的不同数据集
FSGLD 针对不同的先导化合物发现任务设计了三种应用场景, 因此采用了不同的数据集和训练策略。
对于场景 I, 研究人员依据 Lipinski 五规则并结合多样性筛选,从 DrugBank 数据库(https://go.drugbank.com/) 中收集了 7,002 种药物,构建类药性化合物数据集。
对于诱饵分子集,研究人员使用 Open Babel 计算了 ZINC 数据库类药性子集中 19,212,639 个分子的分子量(MW)和脂水分配系数(logP)。随后,研究人员利用内部开发的程序,从中筛选出 284,552 种分子量和 logP 值与 DrugBank 化合物最为接近的 ZINC 化合物。接下来,使用 SYBYL-X 2.1.1 软件,基于分子指纹(FP)对这些化合物进行聚类,以最大限度地提高其结构多样性。最终,研究人员选取 9998 种分子,构建诱饵分子集。
为了训练和验证 dcGAN 的判别器,研究人员采用十折交叉验证方法([75]),将所有选定的类药性分子(7002种)和诱饵分子(9998种)划分为训练集和测试集。
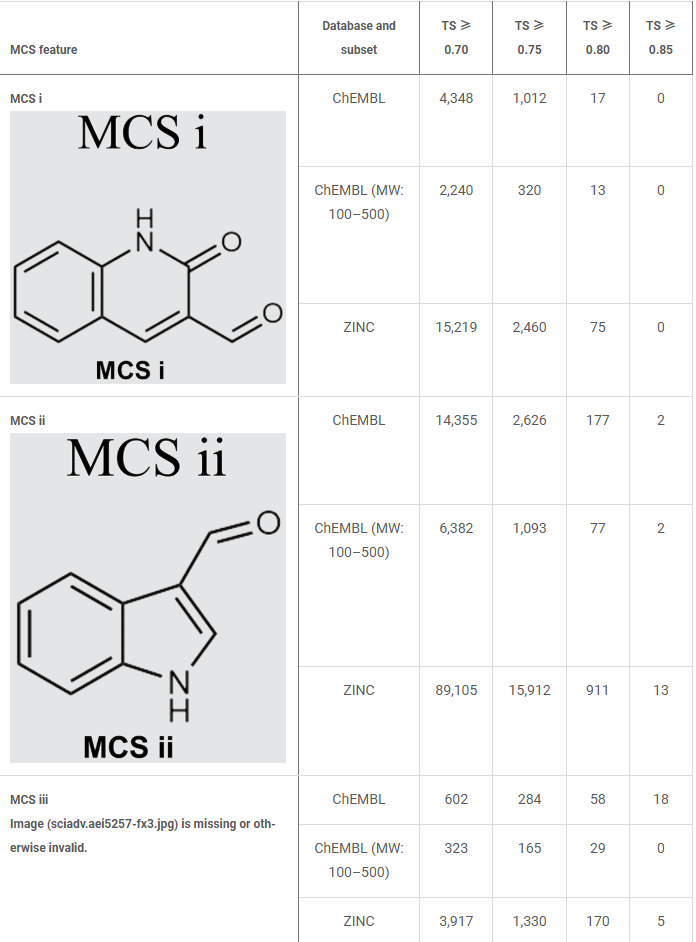
对于场景 II 和场景 III 中靶点偏向型化合物的生成, 研究人员从 ChEMBL 数据库中收集了 1,896 种 CB2 活性化合物(Ki/IC50 低于100 nM)和 2996 种 CB2 非活性化合物(Ki/IC50 大于或等于100 nM),用于训练 cdcGAN 模型。此外,研究人员还对收集到的 CB2 活性化合物的化学结构进行了人工检查,并识别出其中最常见的三个最大公共子结构(MCS),如下表:
在模型训练过程中,所有分子均使用 Open Babel 2.3.1 版本软件转换为 MACCS 分子指纹(168位)。为了开展进一步验证,研究人员获取了 CB1 的 X 射线晶体结构,并构建了 CB2 的同源模型。
Cadre FSGLD : DRUG-GAN comme noyau
Le noyau de FSGLD est DRUG-GAN. Son idée clé n'est pas de générer directement des structures moléculaires complètes, mais d'apprendre la distribution des empreintes moléculaires, de générer des empreintes présentant des caractéristiques spécifiques, puis de les utiliser comme conditions de requête pour rechercher dans de grandes bases de données chimiques des composés réels structurellement similaires. Un aperçu de ce flux est présenté ci-dessous :
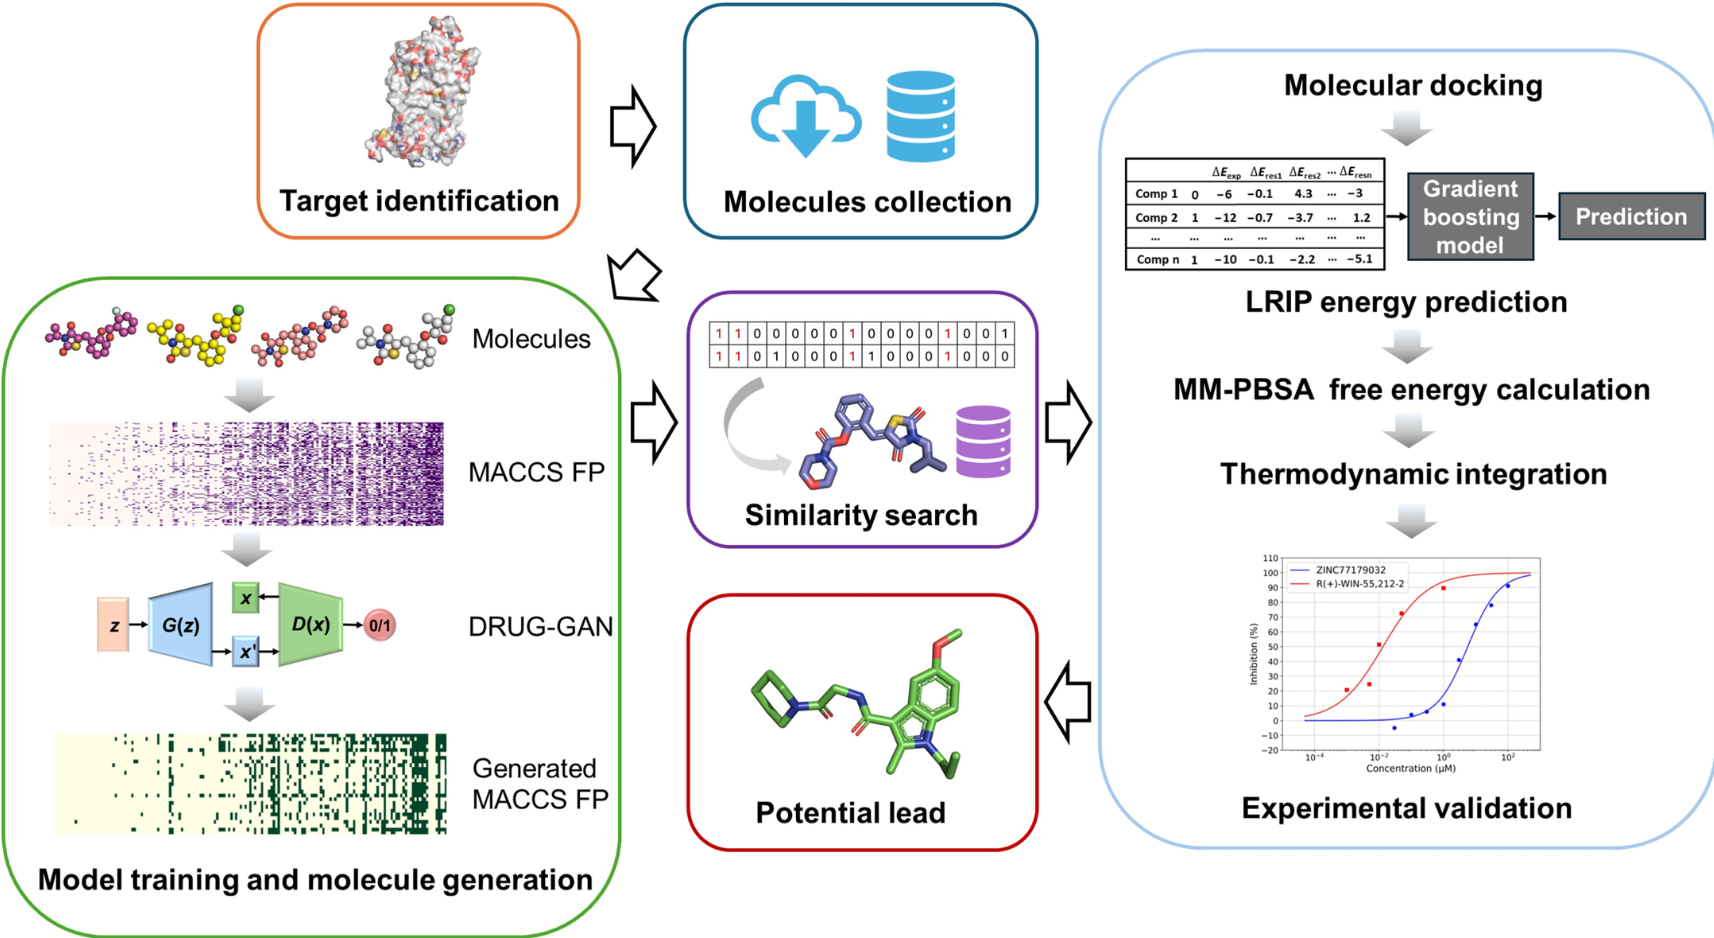
Cette conception diffère des modèles génératifs traditionnels basés sur des chaînes SMILES ou des graphes moléculaires. Les empreintes moléculaires MACCS peuvent décrire les caractéristiques structurelles des molécules sous une forme compacte et conviennent à l'apprentissage à partir de jeux de données relativement limités. Cependant, comme les empreintes moléculaires ne peuvent pas établir une correspondance unique avec une molécule individuelle et ne peuvent pas être converties directement en structures moléculaires chimiquement valides, les empreintes générées par DRUG-GAN doivent être associées par similarité à des bases de données telles que ChEMBL et ZINC pour obtenir des composés candidats réels.
D'après l'architecture du modèle, les chercheurs ont construit un discriminateur à l'aide d'un réseau neuronal convolutif profond (DCNN) et ont exploré quatre principales architectures DCNN : LeNet-5, AlexNet, ZFNet et VGGNet.
Selon différents objectifs de découverte, DRUG-GAN a été conçu pour trois scénarios d'application.
Scénario I : il utilise un dcGAN standard, avec les empreintes moléculaires de composés médicamenteux de DrugBank comme échantillons réels, afin d'apprendre la distribution des caractéristiques des molécules médicamenteuses. Le générateur part d'un bruit aléatoire, génère de nouvelles empreintes moléculaires, puis recherche les composés correspondants dans la base de données ZINC par récupération par similarité. Ce scénario sert principalement à explorer l'espace chimique présentant des caractéristiques de type médicamenteux.
Scénario II : il introduit en outre des informations spécifiques à la cible, en utilisant un réseau génératif antagoniste conditionnel cdcGAN. Le modèle utilise les ligands actifs et inactifs de CB2 comme deux types de données d'entraînement, apprend les caractéristiques d'empreintes moléculaires associées à l'activité CB2, puis génère des empreintes présentant une préférence pour la cible CB2. Ensuite, les chercheurs utilisent les empreintes générées comme conditions de requête pour rechercher des composés candidats dans les bases de données ChEMBL et ZINC, réalisant ainsi une extension de l'exploration non biaisée de molécules médicamenteuses vers une découverte orientée par la cible.
Scénario III : il améliore encore la contrôlabilité de la conception moléculaire. Les chercheurs ont introduit une couche de masque (Mask Layer) dans le générateur, en fixant spécifiquement via une couche Lambda les positions des caractéristiques d'empreinte moléculaire correspondant au MCS prédéfini, afin que les empreintes générées conservent les caractéristiques structurelles spécifiées tout en permettant à d'autres positions de varier. De cette manière, le modèle peut générer des séries de composés présentant à la fois une préférence pour la cible CB2 et des caractéristiques de squelette spécifiques, fournissant un soutien à l'expansion des composés hits et à l'optimisation ultérieure des composés de tête.
Après la génération des composés candidats, FSGLD établit également un processus de filtrage computationnel hiérarchique. Tout d'abord, l'interaction de liaison des molécules candidates avec le récepteur cible est évaluée par docking moléculaire, puis un filtrage est effectué à l'aide de la fonction de score LRIP spécifique à la cible, suivi de simulations de dynamique moléculaire (MD), de calculs d'énergie libre de liaison MM-PBSA et de calculs d'intégration thermodynamique (TI). Seuls les composés ayant passé le filtrage de l'étape actuelle peuvent passer à l'étape suivante. Enfin, les chercheurs effectuent une validation expérimentale sur les molécules candidates les plus prioritaires, formant un flux complet allant de la génération, la récupération, le filtrage computationnel à l'évaluation expérimentale.
Résultats : de bonnes performances dans l'évaluation de trois cibles aux profils pharmacologiques variés
Les expérimentateurs ont évalué les performances du modèle à travers trois scénarios :
Scénario I : génération de composés médicamenteux
Les chercheurs ont procédé à une comparaison exhaustive entre DRUG-GAN et trois modèles génératifs publiés — ORGAN, OR(W)GAN et ORGANIC — selon cinq dimensions : unicité (Uniqueness), nouveauté (Novelty), diversité (Diversity), similarité (Similarity) et validité (Validity).
Comme indiqué dans le tableau ci-dessous, dans l'espace MACCS FP, DRUG-GAN surpasse les autres modèles génératifs servant de références sur plusieurs indicateurs clés. En particulier, les scores d'unicité et de nouveauté de DRUG-GAN atteignent 1.00, obtenant une performance parfaite. Cela signifie que toutes les empreintes moléculaires générées sont différentes les unes des autres et n'apparaissent pas dans les données d'entraînement. Son score de diversité est de 0.73, proche des performances de ORGAN (0.77) et ORGANIC (0.76), et supérieur à celui de OR(W)GAN (0.63). En outre, la similarité moyenne entre les empreintes moléculaires générées par DRUG-GAN et 7002 médicaments de référence est la plus faible, à seulement 0.25. Cela indique que le modèle peut générer des empreintes moléculaires présentant des différences structurelles marquées tout en conservant les caractéristiques médicamenteuses.
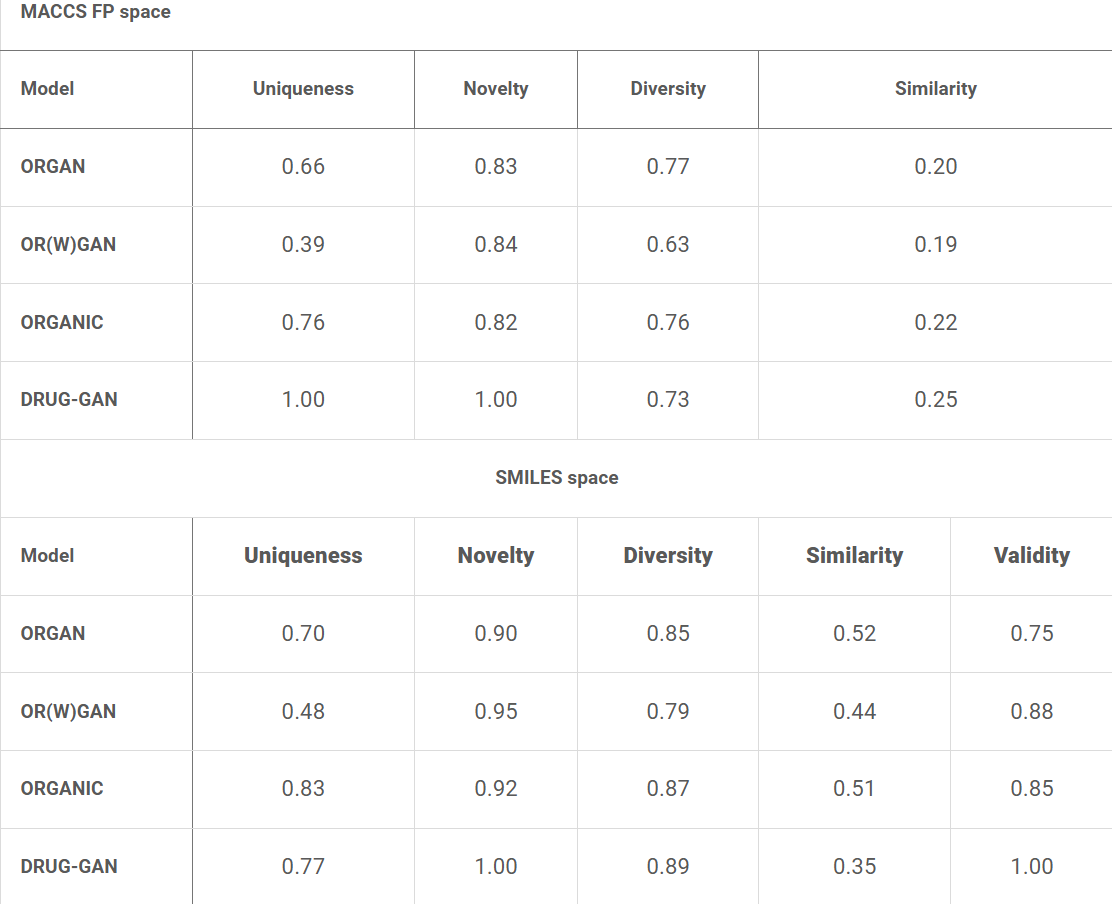
与 FP 空间评估结果一致,DRUG-GAN 在 SMILES 空间也表现出色。DRUG-GAN 的新颖性得分仍保持在1.00,表明解码得到的所有分子均未出现在训练数据集中。正如预期,由于多个不同的分子指纹可能解码为相同的分子结构,其唯一性得分从 FP 空间中的1.00下降至 SMILES 空间中的0.77。尽管如此,DRUG-GAN 的唯一性仍高于 ORGAN 和 OR(W)GAN,仅略低于 ORGANIC。同时,DRUG-GAN 还保持了较高的多样性,得分达到 0.89,而其生成分子与参考药物之间的相似性相对较低,得分为 0.35。这与该模型在不牺牲化学合理性的前提下拓展化学空间的设计目标一致。
为了进一步评估这些结果,研究人员还分析了 2252 种美国食品药品监督管理局(FDA)批准的药物,其分子量(MW)范围为 100 至 1000 Da。这些已获批药物的平均分子量(MW)、脂水分配系数对数值(logP)和拓扑极性表面积(TPSA)分别为 358.0 Da、2.8 和 89.3 Ų。DRUG-GAN 检索得到的分子则表现出与之相近的类药性特征,其平均分子量为 382.9 Da,平均 logP 为 2.0,平均 TPSA 为 76.0 Ų。这些数据表明,与 FDA 已批准药物相比,DRUG-GAN 检索得到的分子整体分子量略大,但极性相对较低,显示出潜在的有利理化性质。
场景 II:靶点特异性化合物生成
除了生成具有类药性的候选化合物,DRUG-GAN 还具备生成靶点特异性化合物的能力。 为展示这一能力,研究人员以大麻素受体2(CB2)为例开展研究。
在与生成的分子指纹相似性达到 85% 或以上(TS ≥ 0.85)的 186 个 ChEMBL 化合物中,有 169 个化合物的分子量(MW)介于 100 至 500 Da 之间,其中 104 个化合物已在生物活性实验中被报道为具有 CB2 活性的配体,其抑制常数(Ki)小于10 μM。检索得到的化合物中,低 Ki 值分子的富集表明,DRUG-GAN 生成的分子指纹查询能够有效地从与目标靶点相关的生物活性数据库中,检索出已知具有 CB2 活性的化学结构类型。此外,研究人员还从 ZINC 数据库中检索到 161 个化合物,其与 DRUG-GAN 生成的分子指纹查询之间的 TS 均达到或超过 0.85。
随后,研究人员将检索得到的化合物分别与 CB1 和 CB2 受体进行分子对接,预测其结合亲和力,结果如下图:
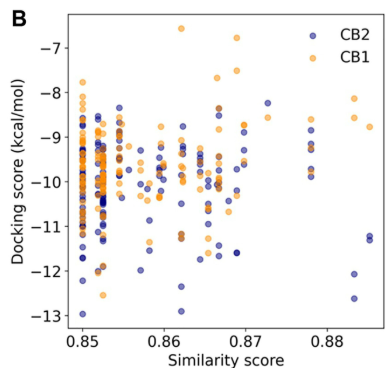
总体而言,DRUG-GAN 生成的分子指纹查询所检索得到的化合物,对 CB2 表现出较好的预测结合能力,其与 CB2 受体分子对接得分的平均值为 −10.10 kcal/mol,优于场景 I 判别器训练所用诱饵分子的平均值 −8.29 kcal/mol。对每个检索化合物的对接得分进行配对比较后,研究人员进一步发现,这些化合物整体上表现出对 CB2 的结合偏好,其中相当一部分化合物与 CB2 的预测结合能力优于与 CB1 的结合能力。
场景 III:靶点特异性系列化合物生成
在场景三中,研究人员将三个预定义 MCS 引入生成器,通过掩码层生成具有特定骨架约束的 CB2 候选化合物。
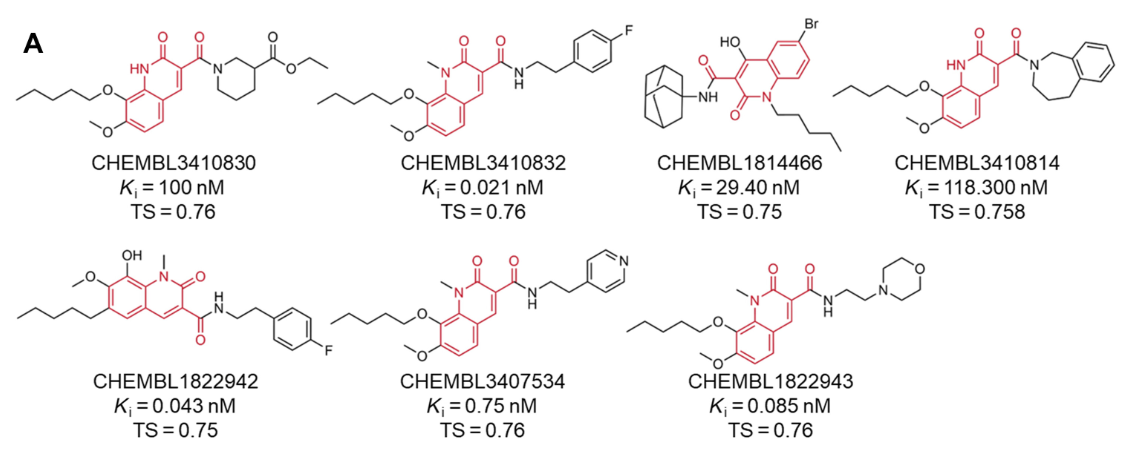
MCS i:喹啉二酮核心结构
对于 MCS i,研究人员从 ChEMBL 数据库中检索并确认了 49 个包含预定义子结构、且与生成的分子指纹查询之间 TS ≥ 0.75 的化合物。如下图,有 7 个化合物已被报道具有较高的 CB2 活性(Ki 小于10 μM)。
在 ZINC 数据库中,研究人员则检索并确认了32个包含 MCS i 子结构、且 TS ≥ 0.75 的化合物,部分具有代表性的候选化合物及其对应的 TS 值如下图:
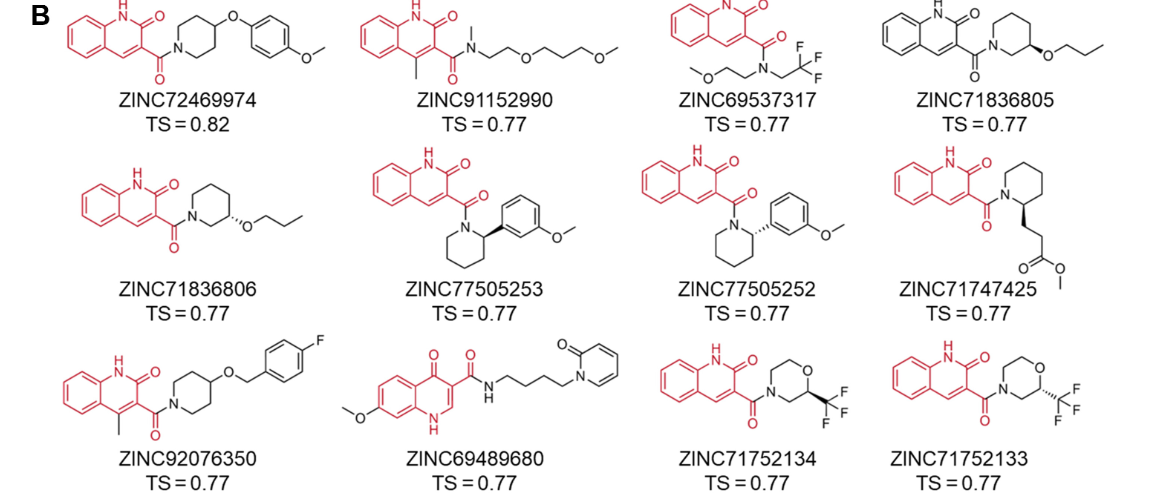
这些候选化合物中的大多数,其与 CB2 的预测分子对接得分优于与 CB1 的对接得分,表明它们在基于分子对接的候选化合物优先级排序中可能具有 CB2 结合偏好。
MCS ii:吲哚甲酰胺核心结构
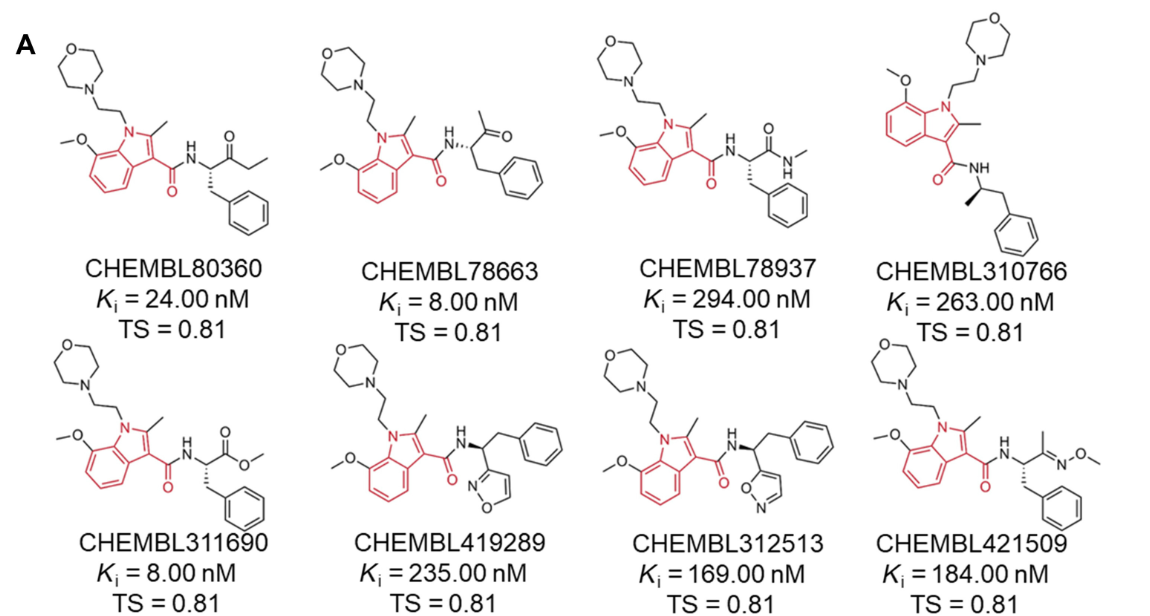
Pour MCS ii, les chercheurs ont identifié et confirmé 24 composés dans la base de données ChEMBL contenant la sous-structure prédéfinie et présentant une TS ≥ 0.80 par rapport aux requêtes d'empreintes moléculaires générées. Parmi eux, 8 composés ont montré une forte affinité de liaison pour CB2 (figure ci-dessous), confirmant ainsi que la stratégie DRUG-GAN contrainte par le squelette permet de rechercher efficacement des types de structures chimiques liés à CB2.
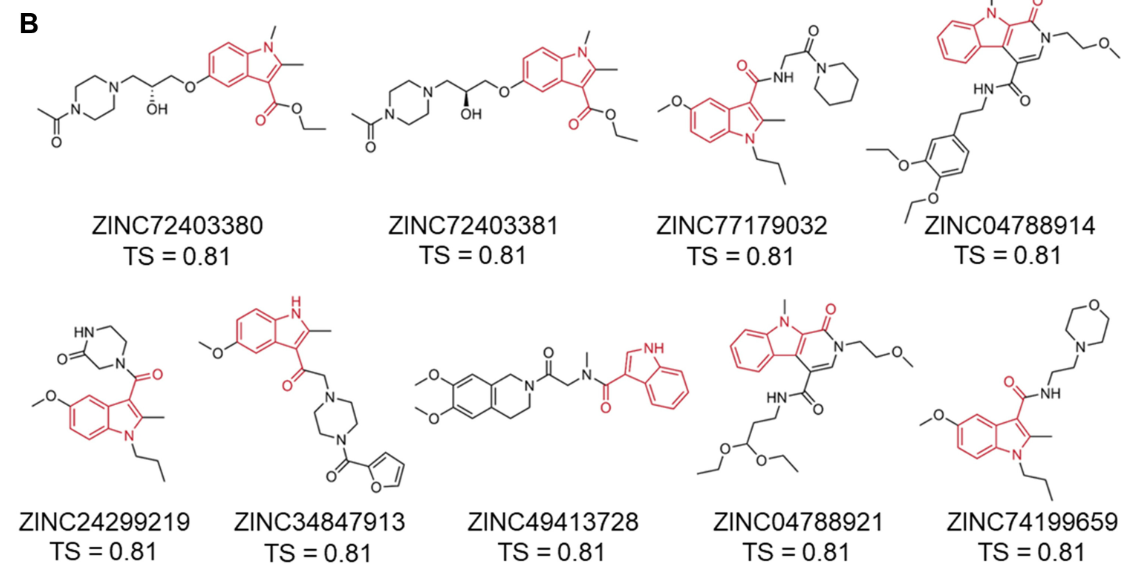
Dans la base de données ZINC, les chercheurs ont en revanche identifié 9 composés contenant la sous-structure MCS ii et présentant une TS ≥ 0.80 (figure ci-dessous). Comme pour les composés candidats de MCS i, la plupart de ces composés présentent des scores de docking moléculaire prédits pour CB2 supérieurs à ceux pour CB1, indiquant qu'ils présentent un potentiel pour des criblages ciblant CB2.
MCS iii : squelette indole-sulfonamide
Pour MCS iii, les chercheurs ont initialement identifié 165 composés dans la base de données ChEMBL dans des conditions où TS ≥ 0.75. Cependant, après analyse par empreintes moléculaires FP2, seuls 2 composés ont finalement été confirmés comme contenant une sous-structure MCS iii correspondant parfaitement (figure ci-dessous).
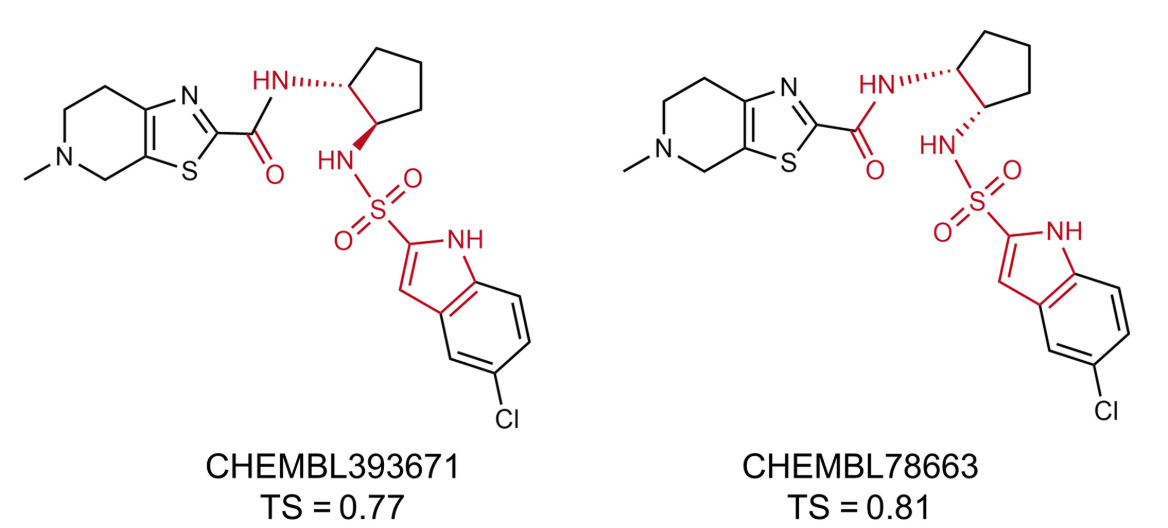
De plus, dans la base de données ZINC, aucun des composés recherchés avec TS ≥ 0.75 n'a réussi la validation, c'est-à-dire qu'aucun composé n'a été confirmé comme contenant une sous-structure MCS iii correspondant parfaitement.
Les résultats globaux montrent que la stratégie DRUG-GAN contrainte par le squelette permet, tout en préservant les caractéristiques des structures chimiques associées à CB2, d'élargir l'espace chimique représenté par les ligands d'entraînement et de découvrir de nouveaux composés candidats structurellement différents.
Conclusion
Afin de prioriser la sélection de composés candidats prometteurs, FSGLD adopte un flux de travail hiérarchisé pour évaluer les composés identifiés, comprenant le docking moléculaire, le score LRIP spécifique de la cible, les simulations de dynamique moléculaire (MD), les calculs d'énergie libre de liaison MM-PBSA et les calculs d'intégration thermodynamique, et effectue une validation expérimentale sur une partie des composés candidats. En intégrant ces méthodes complémentaires dans un flux de travail unifié, FSGLD établit un cadre de recherche pratique permettant de prioriser la sélection de composés candidats leaders et de fournir une base pour les évaluations expérimentales ultérieures.
Au fur et à mesure que les méthodes de prédiction de la structure des protéines et de co-repliement progressent, les chercheurs prévoient que la précision, la robustesse et la portée du cadre FSGLD s'amélioreront en conséquence. Les recherches futures évalueront DRUG-GAN et FSGLD dans un éventail plus large de familles de cibles, notamment les canaux ioniques et les récepteurs nucléaires, tout en introduisant des stratégies avancées d'apprentissage sur petits échantillons et sur petits jeux de données, afin d'améliorer davantage les performances des modèles dans des scénarios à données limitées.
Références :