Command Palette
Search for a command to run...
Wie Lässt Sich Das Gedächtnis Von Robotern Bei Begrenztem Abfragebudget Zuverlässiger Machen? MIT Stellt UQ-DAAAM Vor, Das Unsicherheitsbewertung Für Das Räumlich-zeitliche Gedächtnis Einführt
Mit dem Übergang von Robotern von kurzzeitigen, einzelnen Aufgaben zu langfristigen autonomen Operationen in offenen Umgebungen müssen sie ein Langzeitgedächtnis aufbauen, das Objekte und ihre räumlichen Beziehungen über verschiedene Zeitpunkte und Blickwinkel hinweg speichern kann, um Aufgaben wie Navigation, Objektsuche und räumlich-zeitliche Frage-Antwort-Aufgaben zu unterstützen.
In den letzten Jahren haben Szenenbeschreibungen auf Basis von Vision-Language-Modellen (VLM) einen neuen Weg zur Konstruktion semantischer Gedächtnisse für Roboter eröffnet. Allerdings enthalten die Ausgaben von VLMs häufig Rauschen, und es können semantische Inkonsistenzen zwischen unterschiedlichen Beobachtungsansichten auftreten. Wenn Objekte weit entfernt sind, durch die Blickrichtung verdeckt werden oder sich in komplexen Beleuchtungsumgebungen befinden, kann ein VLM einen Text erzeugen, der sehr sicher erscheint, die Objektattribute jedoch tatsächlich falsch beschreibt. Bei Gedächtnissystemen wie DAAAM kann der resultierende Gedächtniseintrag fehlerhafte Informationen enthalten, wenn der ausgewählte Blickwinkel zufällig von schlechter Qualität ist, ohne dass das System dies bemerkt.
Um diese Herausforderung anzugehen, hat ein MIT-Forschungsteam eine Unsicherheitsbewertung in ein fortschrittliches räumlich-semantisches Gedächtnissystem integriert und es als UQ-DAAAM bezeichnet. Unter der Einschränkung eines festen Abfragebudgets nutzt UQ-DAAAM diese Bewertung, um Objekte mit hoher Unsicherheit gezielt zu verbessern: Es werden hochwertige Blickwinkel ausgewählt, um neue Beschreibungen zu erhalten, und anschließend werden die aus mehreren Blickwinkeln erzeugten Beschreibungen zu einer einheitlichen Objektbeschreibung fusioniert. Experimentelle Ergebnisse zeigen, dass die Unsicherheitsquantifizierung die Zuverlässigkeit und Wirksamkeit von 4D-Gedächtnissystemen für Embodied AI verbessern kann. Auf dem OC-NaVQA-Benchmark kann UQ-DAAAM im Vergleich zu Basismethoden die Unsicherheit signifikant reduzieren und eine bessere Leistung bei räumlich-zeitlichen Frage-Antwort-Aufgaben erzielen.
Die Forschungsergebnisse erscheinen unter dem Titel „Remember with Confidence: Uncertainty Quantification for Spatio-temporal Memory with Probabilistic Guarantees“ auf der NeurIPS.
Forschungshighlights:
- Einführung einer objektspezifischen Unsicherheitsbewertungsmethode: Für Bildbeschreibungen aus mehreren Blickwinkeln wird ein objektspezifisches semantisches Unsicherheitsmaß definiert.
- Einführung einer budgetbeschränkten aktiven Optimierungs- und Fusionsstrategie: Bei begrenztem zusätzlichem VLM-Abfragebudget werden Objekte mit hoher Unsicherheit priorisiert und Multi-View-Beschreibungen fusioniert.
- Bereitstellung probabilistischer Garantien für die Blickwinkelauswahlstrategie: Der Zusammenhang zwischen der DAAAM-Blickwinkelqualitätsbewertung und der Unsicherheitsreduktion in einem einzelnen Schritt wird theoretisch hergestellt und die entsprechende geschlossene Update-Formel abgeleitet.
Paper-Adresse:
https://arxiv.org/pdf/2606.08277
Datenvorverarbeitung, Szenenrekonstruktion, Segmentierung und Tracking
Datensatz und Vorverarbeitung
Die Forscher bewerten UQ-DAAAM auf dem CODa-Outdoor-Fahrdatensatz in räumlich-zeitlichen Frage-Antwort-Aufgaben. Der Datensatz stellt 30-Hz-Stereobilder, durch LiDAR-Projektion erzeugte Tiefenkarten und global konsistente Pose-Informationen bereit.
Alle Experimente verwenden Bilder der Frontkamera (cam0); die Bilder werden zentral zugeschnitten und skaliert, sodass eine endgültige Auflösung von 480×640 Pixeln erreicht wird. Die Tiefendaten stammen aus der Rohschätzung der 3D-LiDAR-Projektion und werden gefiltert, sodass nur Tiefen im Bereich [0.05, 20.0] Meter beibehalten werden. Die Videoframes werden mit einer Frequenz von 10 Hz verarbeitet, konsistent mit der Frequenz der Datenausgabe der Sensoren.
Szenenrekonstruktion
Die Forscher verwenden Khronos zur Echtzeitkonstruktion von 3D-Szenengraphen. Die Voxelgröße des TSDF (truncated signed distance field) wird auf 0,2 Meter und die Abschneideentfernung auf 0,6 Meter gesetzt.
Die Extraktionsparameter für Objektfragmente (Object Fragments) sind wie folgt eingestellt: minimales Volumen 0,005 Kubikmeter, maximales Volumen 50 Kubikmeter; jedes Objektfragment muss mindestens 8 Beobachtungen erhalten, und die Zuordnungskonfidenz darf 0,5 nicht unterschreiten.
Die Breite der Traversability Places (Begehbarkeitsorte) wird auf 0,4 bis 2,0 Meter eingestellt, und die Labelprojektion auf die Bodenebene wird aktiviert.
Segmentierung und Tracking
Die Forscher verwenden FastSAM für die Open-Vocabulary-Instanzsegmentierung und kompilieren es in eine TensorRT-Engine. Die Eingabeauflösung der Bilder beträgt 480×640 Pixel, und die minimale Fläche der Segmentierungsmasken ist auf 400 Pixel eingestellt.
Das Objekt-Tracking erfolgt mit ByteTrack; die Erscheinungsbild-Merkmalsübereinstimmung wird durch ein CLIP-basiertes Re-Identification-Modell (ReID) realisiert, das ebenfalls auf einer TensorRT-Engine bereitgestellt wird. Bei den Tracking-Parametern wird die Konfidenzschwelle für neue Tracks (new track) auf 0,6 und die Track-Pufferlänge (track buffer) auf 30 Frames eingestellt. Eine Objektbahn muss mindestens 8 Beobachtungen ansammeln, bevor sie in die Phase der semantischen Annotation eingeht.
UQ-DAAAM-Framework: von der Unsicherheitserkennung zur aktiven Beobachtung und semantischen Fusion
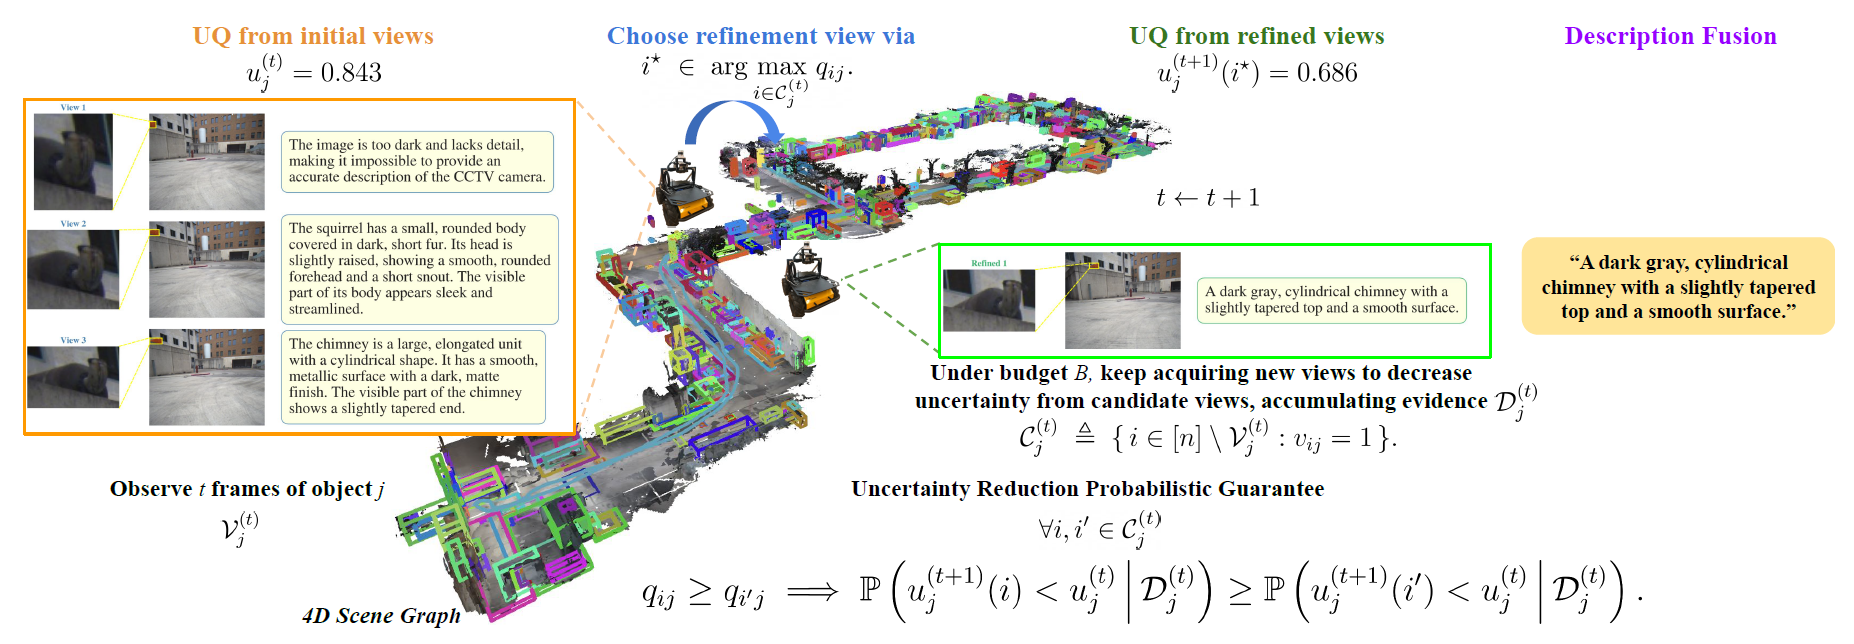
Die vorliegende Studie baut auf DAAAM auf; DAAAM kann aus RGB-D-Datenströmen in Echtzeit 4D-Szenengraphen konstruieren. Die folgende Abbildung zeigt den Gesamtrahmen von UQ-DAAAM. Der Konstruktionsprozess umfasst drei Hauptschritte: Unsicherheitsquantifizierung, aktive Blickwinkelauswahl und Aggregation von Beschreibungen aus mehreren Blickwinkeln:
① Unsicherheitsquantifizierung (Uncertainty Quantification)
Um die objektzentrierte semantische Unsicherheit zu quantifizieren, führten die Forscher die Methode der volumetrischen semantischen Messung (Volumetric Semantic Measurement) in das Szenario zum Aufbau eines Multi-View-Roboter-Gedächtnisses von DAAAM ein.
In dem hier untersuchten Szenario wird jedes Objekt aus mehreren ausgewählten Ansichten beobachtet, wobei jede Ansicht durch eine vom VLM generierte natürlichsprachliche Beschreibung repräsentiert wird. Wenn die in unterschiedlichen Ansichten generierten Beschreibungen semantisch inkonsistent sind oder eine einzelne Beschreibung selbst eine geringe interne Kohärenz aufweist, sollte die Unsicherheit des Systems entsprechend steigen. Daher berücksichtigt die Berechnungsmethode dieser Studie zwei Aspekte: die semantische Streuung über Ansichten hinweg (Cross-view Semantic Scatter) und die Inkohärenz pro Ansicht (Per-view Incoherence).
Je größer die Unterschiede in der semantischen Richtung zwischen den Beschreibungen aus verschiedenen Ansichten oder je weniger kohärent eine einzelne Beschreibung selbst ist, desto höher ist typischerweise die berechnete Unsicherheit. Somit verlässt sich das System nicht mehr allein auf den Konfidenzgrad einer einzelnen Beschreibung, sondern prüft umfassend die Konsistenz der Informationen aus mehreren Ansichten sowie die Zuverlässigkeit einer einzelnen Beschreibung.
① Aktive Ansichtsauswahl (Active View Selection)
Nach Abschluss der anfänglichen Unsicherheitsbewertung vergleicht das System die objektbezogene Unsicherheit mit einem vorab festgelegten Schwellenwert. Wenn die Unsicherheit eines Objekts über dem Schwellenwert liegt, bedeutet dies, dass die semantische Erklärung im aktuellen Gedächtnis weiterhin erhebliche Mehrdeutigkeit aufweist und weitere Beobachtungsnachweise eingeholt werden müssen. In diesem Fall verteilt das System das zusätzliche Abfragebudget nicht gleichmäßig auf alle Objekte, sondern priorisiert Objekte mit höherer Unsicherheit.
Theoretisch kann die Auswahl zusätzlicher Ansichten als Problem der Bayes-optimalen Versuchsplanung (BOED) modelliert werden: Jede Kandidatenansicht entspricht einem Experiment, der latente semantische Zustand des Objekts ist die zu inferierende Größe, und die vom visuellen Sprachmodell in der neuen Ansicht generierte Beschreibung ist das Experimentresultat. Idealerweise sollte das System die Ansicht auswählen, die die erwartete Unsicherheit am stärksten reduziert.
② Aggregation von Mehr-Ansicht-Beschreibungen (Multi-view Descriptions Aggregation)
Nach der unsicherheitsbasierten Auswahl der Ansichten ist jedem Objekt eine Gruppe von Textbeschreibungen aus verschiedenen Ansichten zugeordnet. Die Forscher fusionieren diese Beschreibungen durch einen eingeschränkten, auf einem großen Sprachmodell (LLM) basierenden Aggregationsschritt zu einer einheitlichen Objektbeschreibung. Konkret sortiert das System die Beschreibungen nach ihrer Erwerbsphase, d. h., Beschreibungen aus den anfänglichen Ansichten werden zuerst und Beschreibungen aus der aktiven Optimierungsphase danach eingeordnet. Bei Konflikten zwischen verschiedenen Beschreibungen wird das LLM angewiesen, nachträglich erworbene Beschreibungen (d. h. in der Optimierungsphase generierte Beschreibungen) bevorzugt zu übernehmen.
Wenn Abweichungen nur zwischen Beschreibungen aus den anfänglichen Ansichten bestehen, verwendet die fusionierte Beschreibung vorsichtige Formulierungen, um verschiedene Möglichkeiten beizubehalten, anstatt die Mehrdeutigkeit voreilig aufzulösen. Darüber hinaus wurden dem LLM weitere Einschränkungen auferlegt: Das Fusionsergebnis darf nur Informationen verwenden, die bereits in mindestens einer Quellbeschreibung enthalten sind, um zu verhindern, dass das Modell halluzinierte Informationen erzeugt.
UQ-DAAAM erreicht bessere räumlich-zeitliche Frage-Antwort-Leistung
Die Studie bewertete UQ-DAAAM anhand mehrerer Aspekte, darunter die Downstream-Leistung bei räumlich-zeitlichen Frage-Antwort-Aufgaben, die Wirksamkeit der Unsicherheitsreduktion, Modul-Ablationen und die Laufzeiteffizienz.
① Bewertung der OC-NaVQA-Aufgabe
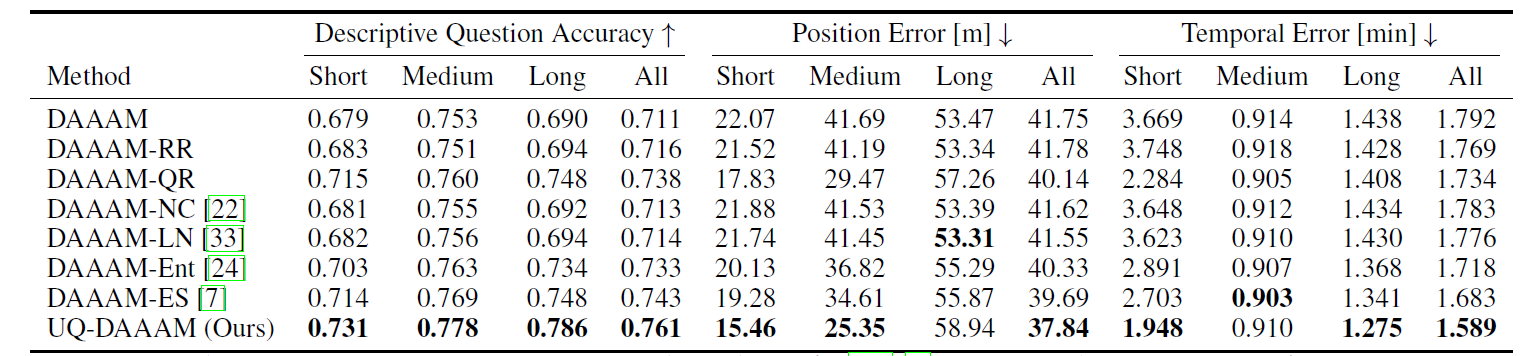
Bei der OC-NaVQA-Aufgabe verglich die Studie UQ-DAAAM mit dem ursprünglichen DAAAM sowie mit mehreren Baselines für aktive Optimierung und Unsicherheitsquantifizierung. Dabei weist DAAAM-RR das zusätzliche Budget für Ansichtsabfragen zufällig zu; DAAAM-QR weist das Budget anhand der ursprünglichen Ansichtsqualitätsscores Objekten mit geringerer Qualität zu. Zusätzlich wurden Methoden verglichen, die auf verschiedenen Unsicherheitssignalen basieren, wie Nachbarschaftskonsistenz, Log-Likelihood des nächsten Tokens, Entropie und Evidenz-Scores.
Die Ergebnisse in der folgenden Tabelle zeigen, dass UQ-DAAAM in allen drei Bewertungsmetriken anderen Baseline-Methoden überlegen ist, wobei die deutlichsten Verbesserungen bei der Fragegenauigkeit und beim Positionsfehler erzielt werden. Dies zeigt, dass eine unsicherheitsbewusste aktive Optimierung das feste semantische Abfragebudget wirksamer zuteilen kann und somit die Gedächtnisqualität verbessert.
② Bewertung der Unsicherheitsreduktion (Uncertainty Reduction)
Neben der Leistung in Downstream-Aufgaben bewertete die Studie direkt, ob die aktive Optimierung ihr unmittelbares Ziel erreicht, nämlich die objektbezogene semantische Unsicherheit zu reduzieren. Die in der Studie verwendete Hauptmetrik ist die Unsicherheitsreduktionsrate (URR), definiert als Anteil der Objekte, die in der Anfangsphase als unsicher eingestuft wurden und deren Unsicherheit nach der aktiven Optimierung unter den Schwellenwert fiel, an der Gesamtzahl der anfangs unsicheren Objekte.
Die im folgenden Diagramm gezeigten Ergebnisse zur Unsicherheitsreduktion weisen darauf hin, dass UQ-DAAAM gegenüber zwei aktiven Optimierungs-Baselines, die nicht auf Unsicherheit basieren, einen deutlichen Vorteil hat. Bei einem festen Budget für die aktive Optimierung von (B=2) erreicht UQ-DAAAM eine URR von 92,3 %; die ansichtsqualitätsbasierte Optimierungsmethode (DAAAM-QR) erreicht 34,2 %, und die zufällige Optimierungsmethode (DAAAM-RR) nur 5,6 %. Darüber hinaus verschiebt UQ-DAAAM die Unsicherheitsverteilung nach der aktiven Optimierung deutlich nach links, was zeigt, dass die Methode bei mehr Objekten eine größere und stabilere Reduktion der Unsicherheit erreicht.
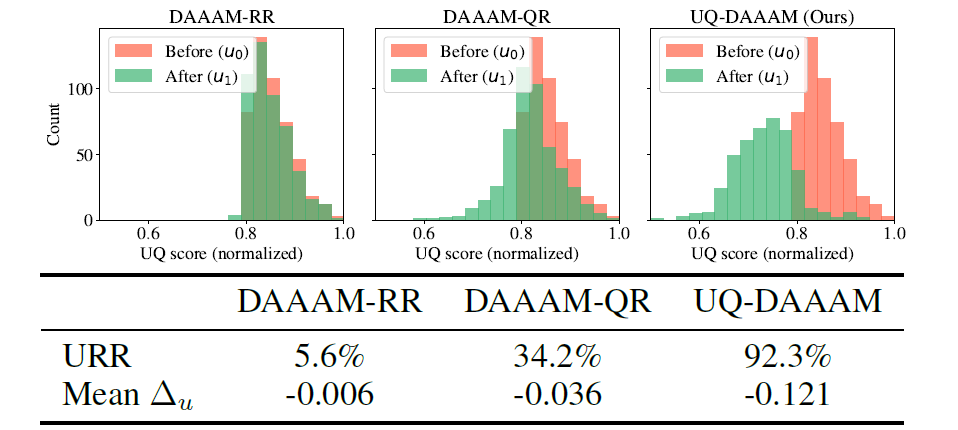
Diese Ergebnisse zeigen, dass die in dieser Arbeit vorgeschlagene unsicherheitsbewusste aktive Optimierungsmethode eine deutlich höhere Optimierungseffizienz besitzt.
③ Ablationsexperimente (Ablations)
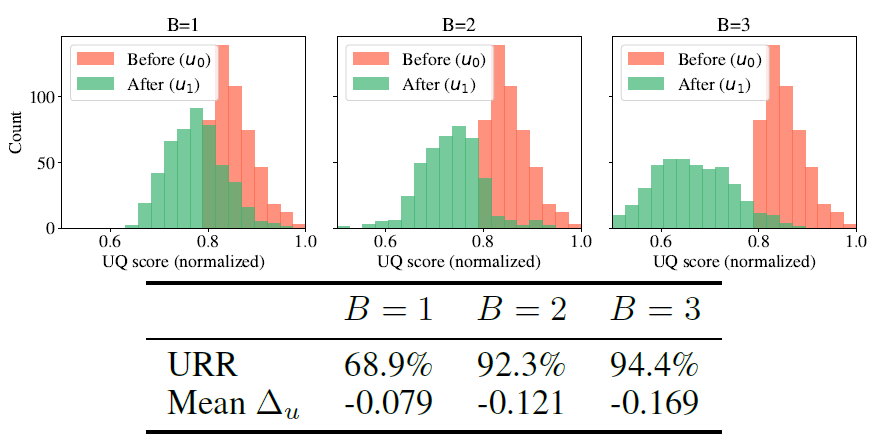
Die Studie zerlegt die Leistungsquellen von UQ-DAAAM zusätzlich anhand mehrerer Ablationsexperimente weiter: Erstens verbessert sich die Reduktion der Unsicherheit mit steigendem zusätzlichen Optimierungsbudget pro Objekt von (B=1) auf (B=3) kontinuierlich, jedoch mit abnehmendem Grenznutzen. Wie in der folgenden Abbildung gezeigt, wird der Großteil des Nutzens bereits bei (B=2) erreicht; auch die Leistung des nachgelagerten OC-NaVQA zeigt denselben Trend, was darauf hindeutet, dass wenige zusätzliche Ansichten in der Regel ausreichen, um die semantische Mehrdeutigkeit der meisten Objekte zu lösen.
Zweitens ist bei der Auswahl der zu optimierenden Objekte die vollständige Unsicherheitsmetrik besser als Ansätze, die nur die Diskrepanz der Beschreibungen über verschiedene Ansichten hinweg verwenden oder die Gewichtung der Inkohärenz einzelner Ansichten ignorieren; dies zeigt, dass die gleichzeitige Berücksichtigung semantischer Unterschiede zwischen Ansichten und der Qualität einzelner Beschreibungen eine wirksamere Unsicherheitsbewertung ermöglicht. Bei der Auswahl der Optimierungsperspektiven senkt eine zufällige Auswahl die Systemleistung deutlich; eine auf der Beobachtungsrichtung des Objekts basierende Strategie schneidet ähnlich ab wie eine Strategie auf Basis von Qualitätsbewertungen der Ansichten, während eine qualitätsgewichtete Bewertung die Kandidatenansichten weiter filtern kann.
Experimente zur Fusion von Beschreibungen aus mehreren Ansichten zeigen, dass auch die Fusionsstrategie die endgültige Gedächtnisqualität beeinflusst. Im Vergleich zur Verwendung nur einer einzigen besten Beschreibung, zur Fusion ausschließlich der ursprünglichen oder der im Optimierungsprozess entstandenen Beschreibungen sowie zu einer gewöhnlichen LLM-Fusion ohne Regeln zur Konfliktbehandlung erzielt die im Paper vorgeschlagene eingeschränkte, phasenbewusste Fusionsmethode die besten Ergebnisse. Das bedeutet, dass die aktive Beschaffung weiterer Beobachtungen nicht alles ist; wie Informationen aus verschiedenen Phasen unterschieden und widersprüchliche Beschreibungen verarbeitet werden, entscheidet ebenso darüber, ob neue Hinweise wirksam in zuverlässiges Gedächtnis überführt werden können.
Bezüglich der Schwellenwerte für die aktive Optimierung verglichen die Experimente Einstellungen, die verschiedenen Quantilen der objektweisen Unsicherheitsverteilung entsprechen. Die Ergebnisse zeigen, dass die Leistung deutlich steigt, wenn der Schwellenwert vom 10. zum 20. Perzentil angepasst wird; eine weitere Anpassung auf das 30. Perzentil bringt noch Verbesserungen, während der zusätzliche Nutzen des 40. Perzentils bereits begrenzt ist. Daraus schließen die Forscher, dass der Standard-Schwellenwert ein gutes Gleichgewicht zwischen den Kosten semantischer Abfragen und den Nutzen für nachgelagerte Aufgaben herstellt.
Fazit
UQ-DAAAM bietet einen unsicherheitsbewussten Ansatz für das langfristige räumlich-zeitliche Gedächtnis von Robotern: Das System betrachtet von vision-sprachlichen Modellen generierte Beschreibungen nicht mehr direkt als zuverlässige Fakten, sondern erkennt potenzielle Mehrdeutigkeiten anhand semantischer Unterschiede zwischen Ansichten und der Qualität einzelner Ansichten, ergänzt Hinweise durch aktive Beobachtungen und bildet durch eingeschränkte Beschreibungsfusion stabilere Objektgedächtnisse. In Zukunft möchten die Forscher UQ-DAAAM nutzen, um verschiedene Robotertypen zu steuern, etwa mobile Roboterarme, und ihre Techniken zur Unsicherheitsquantifizierung auf weitere Bereiche anzuwenden.
Literaturverzeichnis:
https://arxiv.org/pdf/2606.08277 https://news.mit.edu/index%2ephp/2026/clearing-up-robot-fuzzy-memory-1105