Command Palette
Search for a command to run...
Schwierige Annotation Großer Mengen an Bodenmikroben-Daten: BBERT Extrahiert Taxonomische Und Funktionelle Hinweise Aus Kurzen 100-bp-Reads
Das Mikrobiom-Ökosystem weist eine extrem komplexe Zusammensetzung auf. Das Verständnis dieser Komplexität ist entscheidend für die Aufdeckung der verschiedenen Prozesse, die den Betrieb der Biosphäre aufrechterhalten. Diese Arbeit ist untrennbar mit der Analyse großer Sequenzierungsdatensätze verbunden. Heutzutage sind solche Datenressourcen reichlich vorhanden: Tausende öffentlich zugängliche Metagenom-Datensätze, die verschiedene Biome der Erde abdecken, können kostenlos abgerufen und heruntergeladen werden.
Unter diesen Daten haben Boden-Metagenome einen besonders hohen wissenschaftlichen Wert. Shotgun-Metagenom-Sequenzierung in komplexen Umgebungen wie Böden kann eine äußerst reiche biologische Vielfalt aufdecken. Aufgrund des Fehlens ausreichend umfassender Referenzdatenbanken können jedoch die meisten kurzen Reads (Short Reads), die durch Shotgun-Sequenzierung erzeugt werden, nicht genau taxonomisch oder funktionell annotiert werden. Dies macht es schwierig, die tatsächliche Struktur und Funktion mikrobieller Gemeinschaften vollständig zu analysieren.
Vor diesem Hintergrund hat ein Forschungsteam der Hebräischen Universität Jerusalem BBERT vorgeschlagen, ein nukleotidbasierendes großes Sprachmodell, das für die Analyse kurzer Reads optimiert ist. Die Forscher testeten BBERT auf großen Boden-Metagenom-Datensätzen und stellten fest, dass BBERT ohne Abhängigkeit von Referenzdatenbanken die grammatikalischen Merkmale bakterieller Sequenzen identifizieren und direkt aus kurzen Reads mit einer Länge von nur 100 bp die Zuordnung zur taxonomischen Domäne (Taxonomic Domain), das Kodierungspotenzial (Coding Potential) sowie den Leserahmen (Reading Frame) genau bestimmen kann. Darüber hinaus kann das BBERT-Modell kurze metagenomische Reads direkt in bakterielle Aminosäuresequenzen umwandeln und so nachfolgende Forschung und Anwendungen unterstützen. Auch bei der de novo Assemblage von Metagenomen zeigt BBERT Vorteile: Es reduziert Fehlzuordnungen und Lücken während des Assemblageprozesses und verkürzt gleichzeitig die Laufzeit. Die Forscher validierten das Modell weiter mit Metagenom-Daten aus Wurzelknöllchen wilder Leguminosen. Die Ergebnisse zeigen, dass eine Datenfilterung mittels BBERT nicht nur die Qualität des Binning (Binning) erheblich verbessert, sondern auch die Geschwindigkeit der de novo Assemblage stark beschleunigt.
Die Forschungsergebnisse wurden unter dem Titel „Fast and accurate taxonomic domain assignment of short metagenomic reads using BBERT“ in der Fachzeitschrift Nucleic Acids Research veröffentlicht.
Forschungshöhepunkte:
- BBERT überwindet gleichzeitig die bisherigen Einschränkungen großer Sprachmodell-basierter Methoden hinsichtlich Durchsatz und Genauigkeit.
- Die Vorfilterung mit BBERT vor der Metagenom-Analyse kann die Geschwindigkeit der funktionellen Annotation und die Qualität der de novo Assemblage erhöhen, Assemblagefehler reduzieren und die Binning-Qualität verbessern.
- BBERT bietet eine schnelle, referenzdatenbankfreie taxonomische Methode für kurze Reads und könnte das Forschungspotenzial der vorhandenen umfangreichen Metagenom-Datenarchive erschließen.
Link zur Publikation:
https://academic.oup.com/nar/article/54/19/gkag1002/8971853?login=false
Datensätze: Vom Training auf bakteriellen Genomen zur Validierung in komplexen Metagenom-Umgebungen
Während der Entwicklung und Evaluierung von BBERT haben die Forscher zwei Arten von Datensätzen zusammengestellt und erstellt.
- Der erste Datensatz dient der Vor-Training des Modells und enthält Genomdaten von 1416 Bakterienarten. Um die Daten gut über den bakteriellen Evolutionsbaum zu verteilen, wurden aus jeder Bakterienfamilie in der RefSeq-Datenbank zwei Genome zufällig ausgewählt.
- Der zweite Datensatz dient der Kalibrierung und Evaluierung des Modells und umfasst 899 Bakterienarten aus 396 verschiedenen Gattungen sowie 1200 Eukaryotenarten aus 823 verschiedenen Gattungen. Bemerkenswert ist, dass diese beiden Datensätze auf der taxonomischen Ebene der Gattung vollständig getrennt sind, d. h., es gibt keine Überlappungen zwischen den Gattungen.
Gleichzeitig erstellten die Forscher einen kuratierten Referenzgenom-Datensatz, der die eukaryotische Diversität in Bodenökosystemen repräsentiert. Dazu identifizierten sie zunächst eine Liste von Zielgruppen durch die Auswertung von 18S-rRNA- und ITS-Amplicon-Metabarcoding-Studien (Amplicon Metabarcoding Studies) zu mikrobiellen Bodengemeinschaften. Zu den relevanten Studien gehören das Earth Microbiome Project, die pan-europäische LUCAS-Bodeninventur sowie Untersuchungen zur globalen Diversität von Boden-Protozoen und Pilzen.
Durch eine umfassende Analyse der genannten Literatur wurden acht Hauptlinien von Eukaryoten identifiziert, die in mikrobiellen Bodengemeinschaften konstant eine hohe Häufigkeit aufweisen. Diese sind:
- Cercozoa (Fadenbeiner)
- Ciliophora (Wimperntierchen)
- Oomycota (Eipilze, heterokontische Gruppe)
- Glomeromycota (Arbuskuläre Mykorrhizapilze)
- Mucoromycota (Mucor-Pilze)
- Ascomycota (Schlauchpilze)
- Freilebende Nematoda (Fadenwürmer)
- Amoebozoa (Amöben)
Zusätzlich wurden in den Datensatz auch die Chlorophyta (Grünalgen), die mit Bodenökosystemen in Verbindung stehen, sowie terrestrische Pflanzengruppen, für die bereits sequenzierte Genomdaten vorliegen, aufgenommen.
Um die mögliche Zufälligkeit während der Gruppierung von Arten zu berücksichtigen, wurden alle Genomeinträge in den Kalibrierungs- und Evaluierungsdatensätzen auf der taxonomischen Ebene der Gattung jeweils in 20 gleich große Gruppen unterteilt, wobei Bakterien und Eukaryoten jeweils in 20 Gruppen eingeteilt wurden. Innerhalb jeder Gruppe wurde die Artenhäufigkeit gemäß einer Log-Normalverteilung (Log-normal Distribution) zufällig zugewiesen. Anschließend wurden die Gruppen beider Datensätze paarweise kombiniert, um 20 kombinierte Teilmengen zu bilden. Jede Teilmenge weist eine unabhängige Zusammensetzung aus Bakterien- und Eukaryoten-Gattungen auf. Die ersten 10 Teilmengen (Datensätze 1–10) wurden für das Feinabstimmens des Modells verwendet, während die verbleibenden 10 Teilmengen (Datensätze 11–20) zur Modellbewertung reserviert wurden.
Das BBERT-Framework: Ermöglicht es Large Language Models, Bakterienmerkmale aus DNA-Sequenzen zu lernen
BBERT ist ein Modell, das auf der BERT-Architektur basiert und für die Out-of-Distribution-Erkennung (OOD) von Nukleotidsequenzen aus bakteriellen Genomen entwickelt wurde. Der Kernansatz besteht darin, das Modell ausschließlich mit bakteriellen Sequenzen zu trainieren, um zu bestimmen, ob eine gegebene Sequenz bakteriellen Ursprungs ist. Um ein Large Language Model zu erstellen, das auf Nukleotidsequenzen basiert und Out-of-Distribution-Erkennungen für bakterielle Genome durchführt, verwendeten die Forscher einen dreistufigen Entwicklungsprozess:
- Vorabtraining der BERT-Architektur ausschließlich mit Bakterien-Genom-Reads;
- Feinabstimmung für die Klassifizierungsaufgabe Bakterien/Nicht-Bakterien;
- Bewertung der Modellleistung bei der Klassifizierungsaufgabe von Bakterien-Reads und Vergleich mit BERTax, Tiara und REMME.
1. Modell-Vorabtraining
Das Vorabtraining von BBERT verwendete einen Bakterien-Datensatz, der synthetische kurze Nukleotidsequenzen enthält, die durch Sampling erzeugt wurden. Jede Sequenz war 100 bp lang, um Metagenom-Sequenzier-Reads und mögliche Sequenzierungsfehler zu simulieren. Während des Trainings verwendeten die Forscher ein Masked Language Model als Optimierungsziel, bei dem 30 % der Tokens in den Eingabesequenzen maskiert wurden, um die Fähigkeit des Modells zu optimieren, diese maskierten Token basierend auf dem Kontext zu inferieren. Durch diesen Prozess lernt das Modell, fehlende Nukleotide basierend auf vorhandenen Read-Informationen zu repräsentieren.
Der Optimierungsprozess des Vorabtrainings wurde in Phasen von jeweils 5–10 Trainings-Epochen (Epochs) fortgesetzt, bis optimale Ergebnisse erzielt wurden, wobei alle Zwischen-Checkpoints (Modellgewichte) gespeichert wurden. In der Regel wurde beobachtet, dass mit dem sinkenden Trainingsverlust auch die Klassifizierungsgenauigkeit kontinuierlich anstieg. Das Training wurde beendet, wenn der Fortschritt stagnierte und die Modellleistung keine weiteren signifikanten Verbesserungen mehr aufwies.
2. Modell-Feinabstimmung
Anschließend fügten die Forscher dem Modell einen leichtgewichtigen Klassifikationskopf (Classification Head) hinzu, damit BBERT die Klassifizierungsaufgabe für Bakterien-Reads ausführen konnte: Eine lineare Schicht wurde über die von dem BBERT-Encoder (Encoder) erzeugten Token-Einbettungen gelegt, um direkt vorherzusagen, ob ein Read bakteriellen Ursprungs ist.
Dieser Klassifikationskopf wurde im überwachten Lernverfahren trainiert. Während des Trainings wurden die Gewichte des vorab trainierten BBERT-Modells nicht eingefroren, sondern Encoder und Klassifikationskopf wurden gemeinsam feinabgestimmt, damit die vom Encoder erlernten Merkmalsrepräsentationen an die aktuelle Klassifizierungsaufgabe angepasst werden. Um instabile Einflüsse auf die vorab trainierten Gewichte zu vermeiden, wurden unterschiedliche Lernraten für den Klassifikationskopf und den Encoder festgelegt: Die Lernrate für den Encoder betrug 1×10⁻⁶, die für den Klassifikationskopf 1×10⁻⁵, und der AdamW-Optimizer wurde verwendet.
Es wurde festgestellt, dass die Strategie, die unteren zwei Schichten des Transformer-Encoders einzufrieren und die übrigen Schichten feinabzustimmen, zu besseren Ergebnissen führt. Das Modell gibt am Ende die Wahrscheinlichkeit aus, dass ein Read bakteriellen Ursprungs ist, bezeichnet als bact_prob; wenn bact_prob größer als 0,5 ist, wird der Read als bakteriellen Ursprungs eingestuft.
3. Modellbewertung und Vergleich
Abschließend berechneten und berichteten die Forscher die gesamten Klassifizierungsleistungsmetriken des Modells auf den Datensätzen und verglichen die Benchmark-Ergebnisse mit BERTax, Tiara und REMME.
Ergebnisse: Die Klassifizierungsgenauigkeit, funktionale Annotation und Assemblierungseffizienz von BBERT wurden validiert
1. BBERT übertrifft bestehende fortschrittliche Deep-Learning-Klassifizierungstools
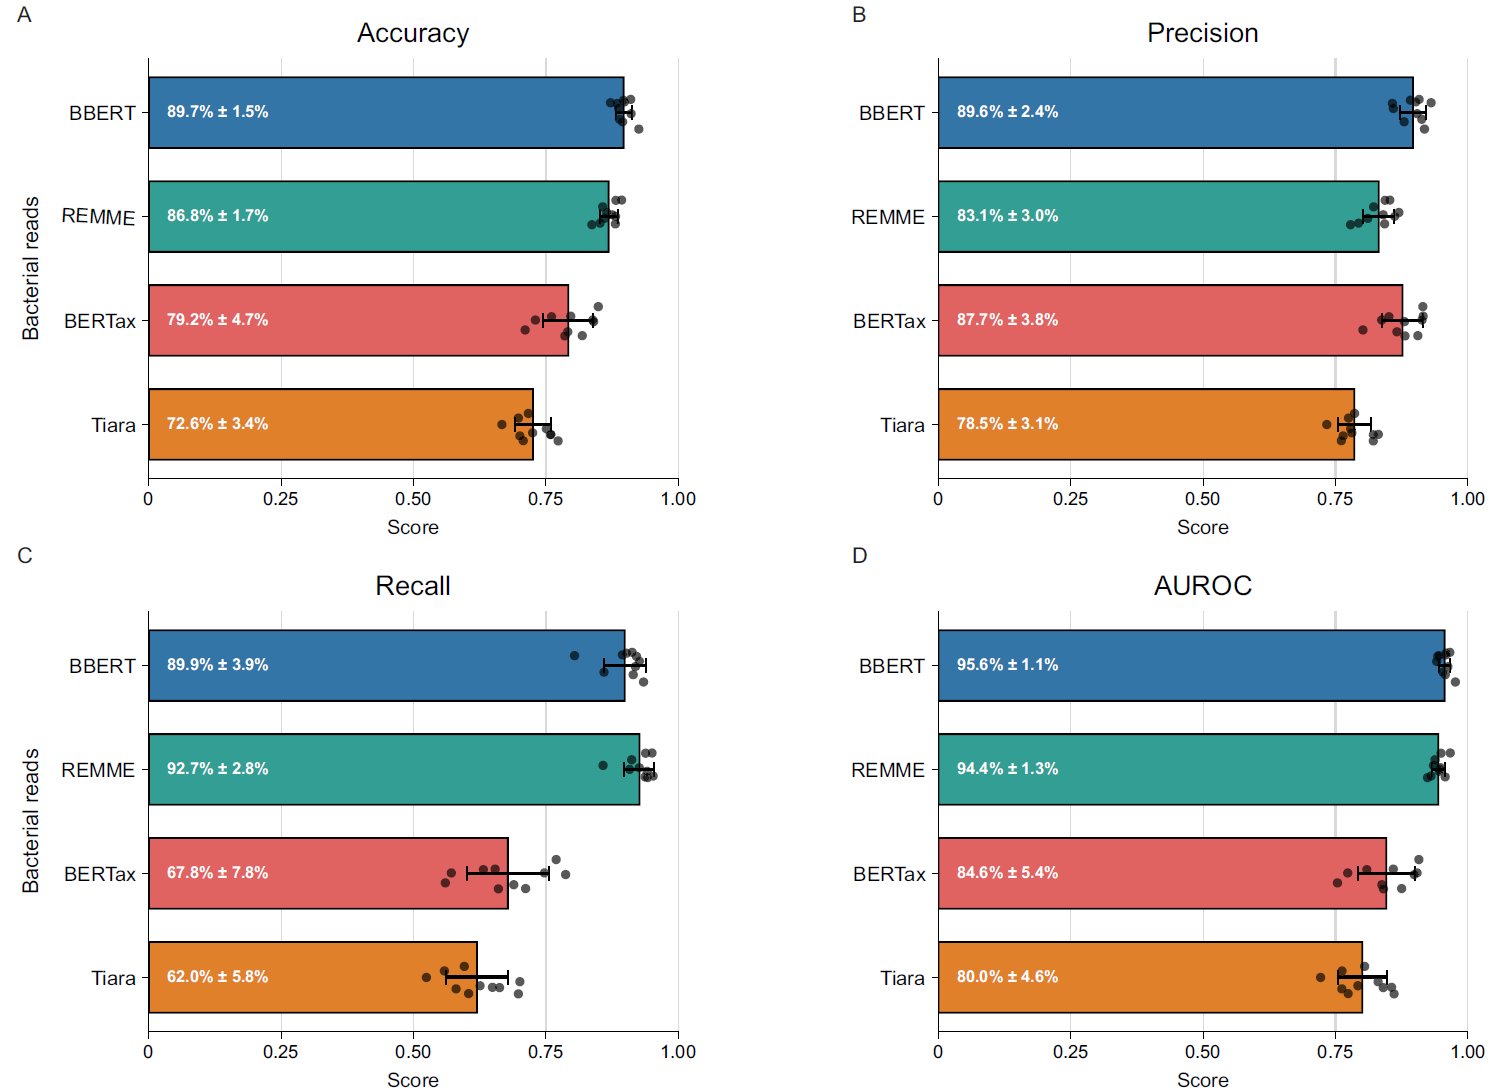
Zunächst zeigte BBERT bei der Klassifizierungsaufgabe von bakteriellen und nicht-bakteriellen Reads eine starke Erkennungsfähigkeit – wie im folgenden Diagramm dargestellt, übertraf BBERT BERTax, Tiara und das optimierte REMME in Standard-Klassifizierungsmetriken wie Genauigkeit, Präzision, Recall (vergleichbar mit REMME) und AUROC. Die durchschnittliche Domänenklassifizierungsgenauigkeit von BBERT über 10 Testsets betrug 89,7 % ± 1,7 %, während REMME 86,8 % ± 1,7 %, BERTax 79,2 % ± 4,7 % und Tiara 72,6 % ± 3,4 % erreichten.
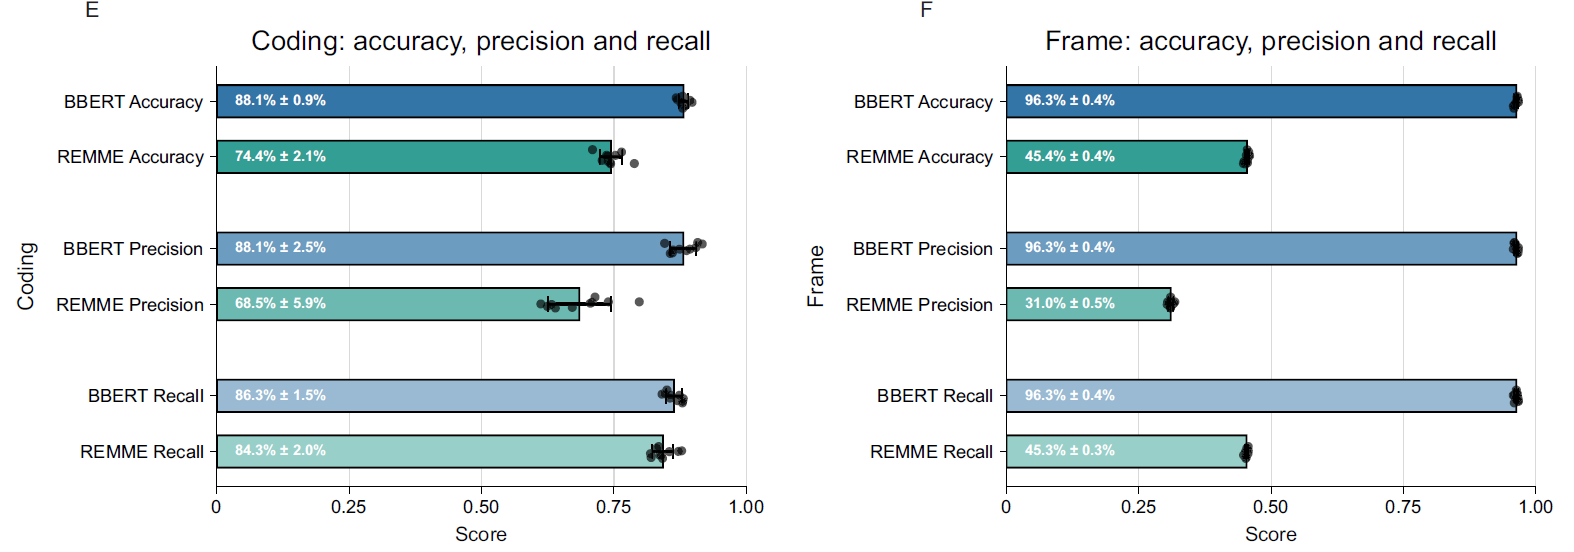
Bei der Identifizierung von kodierenden Sequenzen und deren Leserahmen übertraf BBERT die Leistung von REMME, dem einzigen vergleichbaren Tool mit dieser Funktion (Abbildung unten E, Kodierungsgenauigkeit: BBERT 88,1 % ± 0,9 %, REMME 74,4 % ± 2,1 %; Abbildung unten F, Leserahmen-Genauigkeit: BBERT 96,3 % ± 0,3 %, REMME 45,4 % ± 0,4 %).
Hinsichtlich der Rechenleistung zeigt BBERT ebenfalls eine gute Praktikabilität. Auf einem Rechenknoten mit einer dedizierten NVIDIA H200 GPU kann BBERT 45.912 Reads pro Sekunde (reads per second, rps) verarbeiten, während BERTax und Tiara jeweils 413 rps bzw. 347 rps erreichen. Nach einer Codeoptimierung ist REMME jedoch etwas schneller und erreicht 50.745 rps. Bei der Ausführung auf einem Windows 10-PC mit einer NVIDIA RTX 3090 GPU beträgt die Verarbeitungsrate von BBERT 15.373 rps. Dies bedeutet, dass Benutzer BBERT auch ohne Hochleistungsrechner-Cluster einsetzen können, was bei den meisten vergleichbaren Tools nicht möglich ist.
② BBERT ist ein Werkzeug zur Bakterienidentifikation mit hoher Sensitivität
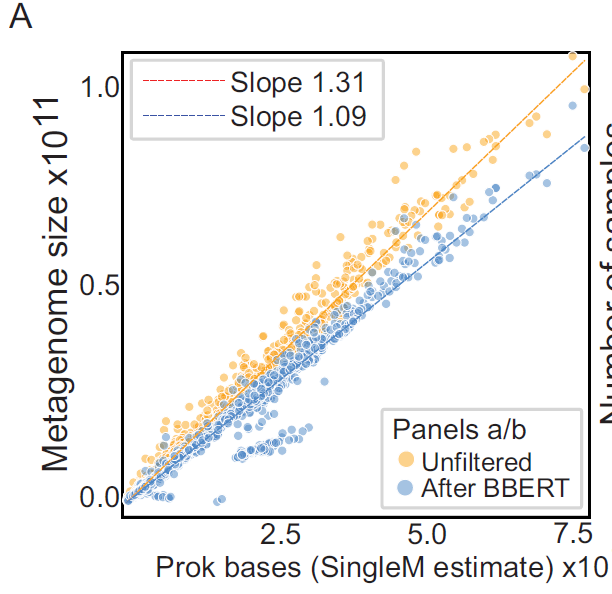
Die Forscher haben BBERT auch auf die zusammengestellten 1.969 öffentlichen Boden-Metagenom-Datensätze angewandt und die von SingleM geschätzte Anzahl der prokaryotischen Basen als Referenz verwendet, um die Leistung auf diesen realen Daten, für die keine wahren Klassifikationsergebnisse vorliegen, weiter zu validieren. Wie in der folgenden Abbildung dargestellt, übersteigt die Gesamtzahl der Basen in den Metagenom-Daten ohne Filterung die von SingleM geschätzte Anzahl der prokaryotischen Basen um 31 % (Steigung 1,31 ± 0,01); nach der Filterung durch BBERT verengt sich diese Differenz auf 9 % (Steigung 1,09 ± 0,01).
Im Gegensatz zu SingleM unterstützt Kraken2 Vergleiche auf Ebene einzelner Reads, daher haben die Forscher BBERT auch direkt mit Kraken2 verglichen. Die Ergebnisse zeigen: Für Reads, die von Kraken2 als bakteriellen Ursprungs identifiziert wurden, stimmt die Klassifikation von BBERT weitgehend damit überein; gleichzeitig kann BBERT einen erheblichen Anteil der Reads identifizieren, die von Kraken2 nicht klassifiziert werden können (siehe folgende Abbildung); umgekehrt sind nur sehr wenige Reads, die von Kraken2 erkannt, aber von BBERT nicht erkannt wurden.
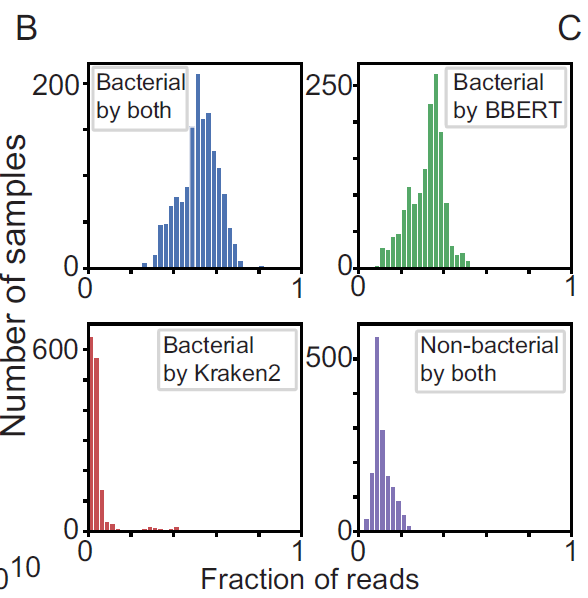
Daher ist BBERT ein Werkzeug zur Bakterienidentifikation mit hoher Sensitivität, das wie Kraken2 eine Klassifikation auf Read-Ebene ermöglicht, ohne durch die unvollständige Abdeckung der Referenzdatenbank eingeschränkt zu sein.
③ BBERT kann kurze DNA-Reads direkt in Aminosäuresequenzen übersetzen
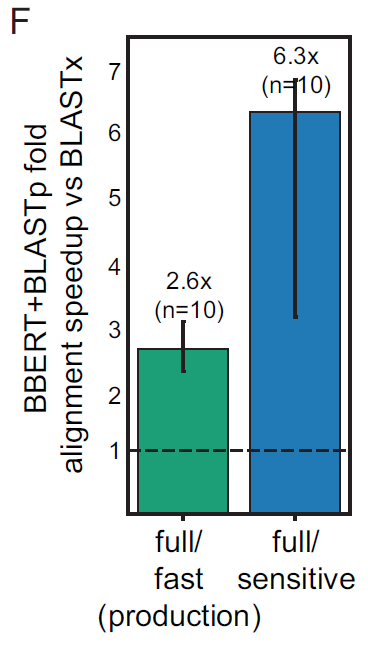
Da BBERT in der Lage ist, kodierende Reads bakteriellen Ursprungs sowie deren Leseraster zu identifizieren, können kurze metagenomische Reads auch direkt in Aminosäuresequenzen übersetzt werden. Die Studie ergab, dass diese Methode im Vergleich zur Annotation ungefilterter DNA-Reads mit BLASTx im Wesentlichen konsistente Annotationsergebnisse liefert, jedoch eine schnellere Verarbeitungszeit aufweist: eine Steigerung um etwa das 2,6-fache im fast-Modus und um etwa das 6,3-fache im sensitive-Modus (siehe folgende Abbildung). Dies bedeutet, dass BBERT nicht nur Forschern bei der Datenvorfilterung helfen kann, sondern auch den Prozess der funktionellen Metagenom-Annotation weiter optimieren könnte.
④ BBERT beschleunigt die de-novo-Assemblierung von Metagenomen und reduziert Assemblierungsfehler
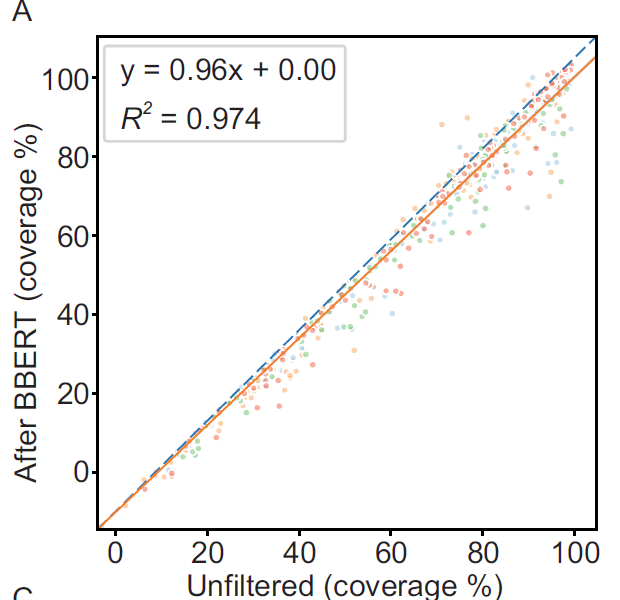
Im Hinblick auf die Metagenom-Assemblierung ist die Wirkung von BBERT noch direkter. Das Forschungsteam stellte fest, dass in ungefilterten Daten eine große Menge an Nicht-Ziel-Sequenzen die Assemblierungslast erhöht und zu fehlerhaften Lücken und Mismatches führen kann. Nach der Filterung von simulierten Metagenom-Daten durch BBERT sank der ungewichtete Durchschnittswert der bakteriellen Genomabdeckung von 68,23 % auf 65,22 %, was einem Abdeckungsverlust von etwa 4,4 % entspricht (siehe folgende Abbildung). Gleichzeitig verkürzte sich die Assemblierungszeit von 66 ± 8 Stunden auf 25 ± 2 Stunden, was einer Effizienzsteigerung von etwa dem 2,7-fachen entspricht.
Die Genauigkeit der Assemblierung wurde ebenfalls verbessert. Bei Berechnung des ungewichteten Durchschnitts über 512 Genome und Normalisierung der einzelnen Metriken auf die Länge des Referenzgenoms zeigt sich Folgendes: Die Anzahl der Gap-Öffnungen pro 100 bp Referenzsequenz sank von 0,51 auf 0,36, eine Abnahme von 0,15 oder einer relativen Reduktion von 29,3 %; die Anzahl der Mismatches sank von 3,31 auf 2,64, eine Abnahme von 0,67 oder einer relativen Reduktion von 20,2 %. Zusammen genommen sanken diese beiden Metriken um etwa 21,4 %.
⑤ Echte Wurzelknöllchen-Metagenom-Daten
Um den potenziellen Nutzen der BBERT-Selektion in realen Datensätzen zu bewerten, wandten die Forscher die Methode zusätzlich auf Wurzelknöllchen-Metagenomdaten von Leguminosen an. Das Volumen der gemeinsamen Assemblierung nach der BBERT-Selektion wurde um 61 % reduziert, von 577,6 Mb auf 222,4 Mb; die Anzahl der Contigs sank um 57 %; der GC-Gehalt stieg von 40,4 % auf 58,5 %.
Diese Veränderungen stimmen mit dem GC-Gehalt von etwa 40 % bei Leguminosen-Genomen und etwa 62 % bei Rhizobiales-Genomen überein, was darauf hindeutet, dass die herausgefilterten Reads überwiegend vom Wirt stammen. Darüber hinaus verdoppelte die BBERT-Selektion den N50-Wert der Assemblierung von 0,9 kb auf 1,8 kb, halbierte die Laufzeit der Assemblierung und reduzierte die maximale Speichernutzung von 188 GB auf 82 GB.
Fazit
BBERT zeigt eine weitere Möglichkeit für die Anwendung großer Sprachmodelle auf kurze DNA-Sequenzen auf: Selbst bei 100-bp-Reads, für die keine Referenzdatenbanken verfügbar sind, kann das Modell durch das Lernen von Sequenzmerkmalen die Klassifikation des Domänenbereichs, die Erkennung des kodierenden Potenzials und die Vorhersage des Leserahmens durchführen. Noch wichtiger ist, dass diese Fähigkeit nicht nur zur Identifizierung von Nicht-Ziel-Sequenzen in Metagenomen genutzt werden kann, sondern auch nachgelagerte Prozesse wie funktionelle Annotation, Genomassemblierung und Binning weiter verbessert.
Die Studie zeigt zudem, dass die Erkennungsverzerrungen von BBERT gegenüber speziellen Sequenzen wie mobilen genetischen Elementen möglicherweise auf unterschiedliche evolutionäre Merkmale im Vergleich zum Wirtsgenom hinweisen. In Zukunft könnte die Empfindlichkeit großer Sprachmodelle gegenüber einzigartigen DNA-Sequenzmustern auch neue Werkzeuge zur Nachverfolgung von horizontalen Gentransfer-Ereignissen bereitstellen. Mit der weiteren Entwicklung entsprechender Modelle könnte ihr Anwendungsbereich von der mikrobiellen Klassifikation auf ein breiteres Spektrum der ökologischen Genomforschung ausgeweitet werden.
Literaturverzeichnis:
https://phys.org/news/2026-10-ai-tool-scientists-bacteria-hidden.html
https://academic.oup.com/nar/article/54/19/gkag1002/8971853?login=false