Command Palette
Search for a command to run...
行业首创!NVIDIA 联手诺奖得主 David Baker 团队发布 RFD4-Proteina,缓解序列-结构-功能解耦难题
近年来,人工智能技术的赋能使得蛋白质工程领域迎来天翻地覆的变化,生物制药、疫苗开发、基因治疗、生物制造等各领域也得益于此而前途一片大好。然而回归计算蛋白设计本身,如何从解决“能否生成”到“更好生成”已成为下一阶段的主要挑战。 此前成果展示了人工设计具备特定结合能力、催化活性的蛋白已不再是难事,但面对需要全局构象动态变化、多套约束耦合的复杂分子机器,却仍难以稳定实现。
通俗而言,蛋白质功能本质上是特定化学基团在特定三维形状里以精准的空间排布与其他分子发生相互作用。因此,在蛋白设计阶段必须同时考虑分子特性(molecular identity)、结构构象(structural conformation)以及相互作用几何(interaction geometry)之间的强耦合关系。现有方法如 RFdiffusion3,可以在多样分子环境下实现全原子结构生成,但无法为生成的结构设计高质量序列;Proteina-Complexa 可以同时生成蛋白序列与结构,并依靠奖励引导搜索扩大搜索范围,但其表征方式专门针对蛋白设计,互作搭档分子构象固定不可变。
针对这一挑战,华盛顿大学蛋白质设计研究所、NVIDIA等机构,联合提出行业首个面向多组分生物大分子复合物、基于潜空间推理的大一统序列-结构联合生成模型 RFD4-Proteina。 该模型将蛋白质设计从「分布采样+事后筛选」的生成范式,推向带内在 / 外在推理的约束搜索范式,突破了传统模型分子类型窄、序列-结构解耦、伴侣刚性假设的瓶颈,并通过大规模湿实验证明了其有效性。
相关成果以「Biomolecular design through latent reasoning with RFD4-Proteina」为题发表。
研究亮点:
- 首创统一隐空间 + 双重推理范式,从根源缓解序列-结构-功能解耦难题
- 单一模型覆盖全链条分子设计工作流程,可代替多款专用工具
- 湿实验验证实现多项里程碑突破,首次实现从头设计酶催化活性药物成分合成
论文地址:
https://rfd4-proteina.org/assets/paper/RFD4-Proteina.pdf
多模态分子数据构建训练与测评基准
训练集
RFD4‑Proteina 训练数据集由多源公共生物结构库、物理模拟生成的合成数据集和蒸馏数据集混合构成,依靠 AtomWorks 工具完成全部数据处理及标注工作。不同训练阶段中各个数据集的采样占比如下图所示:
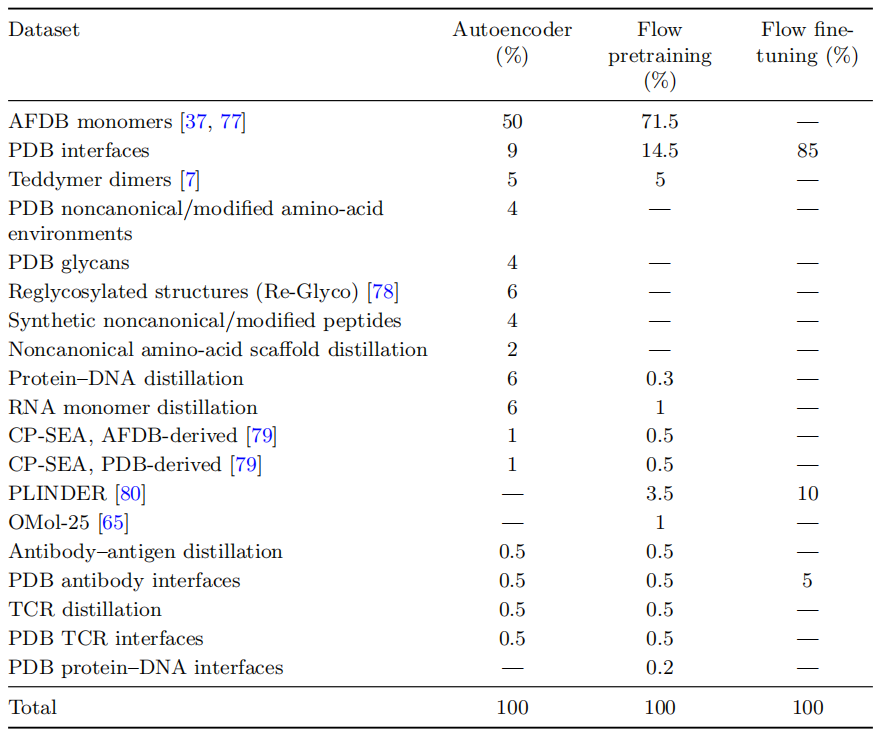
数据集不只包含标准蛋白,还扩充了小分子、核酸、糖、翻译后修饰(非经典氨基酸 NCAA)样本,用以弥补真实实验结构中稀有分子类型样本不足的问题。
训练时在线采样各类约束条件,模拟现实世界蛋白设计任务,提升模型对各类功能约束的理解。
测试集
Side-chain packing 测试集为 PackBench 基准数据集,含 CASP14、CASP15 共 114 个天然蛋白的真实主链骨架; 固定骨干序列设计测试集,包含天然蛋白骨架和从头设计骨架,前者是训练时未见过的、留出来做测试的天然结构,后者是由独立模型 RFD3 生成的人造蛋白骨架; 配体立体化学测试集为 CCD 数据库,含 43 个训练集中未见过的配体; 设计优化任务测试集为此前 RFdiffusion 生成的但未通过 AF3 结构筛选的结合体,共计 102 个; Peptide-MHC 复合物结合测试集,含三个靶点肽:MART-1(肿瘤抗原)、SARS-CoV-1 膜蛋白肽和 Phox2B 肽; Intrinsically disordered regions(IDRs)任务测试集含 8 条 IDR 肽,分为两类:5 条结合后会形成二级结构;3 条即使被结合,本身也不容易形成稳定二级结构; 原肌球蛋白受体激酶(TrkA、TrkB 和 TrkC)任务测试集含 94 个设计编码基因。
统一潜空间 + 双重推理创首个全链条生成范式
RFD4-Proteina 模型的核心设计思路是建立一套统一化学-构象潜空间,通过 Flow-Matching 流匹配生成,同时在潜空间内开展内在/外在双重潜推理,并在可微物理力场监督约束下实现合理的原子重构。
统一化学 - 构象潜空间
首先,研究团队训练了一个自动编码器(Autoencoder),将天然 / 修饰氨基酸、糖类、核苷酸,编码成锚原子坐标(例如,氨基酸用 α-碳)和一个 32 维潜向量(分子身份),如下图所示。当然并非全部都会压进潜向量,一部分分子组分仍保留显式的原子种类与化学键连接信息,确保化学结构不会发生混乱。
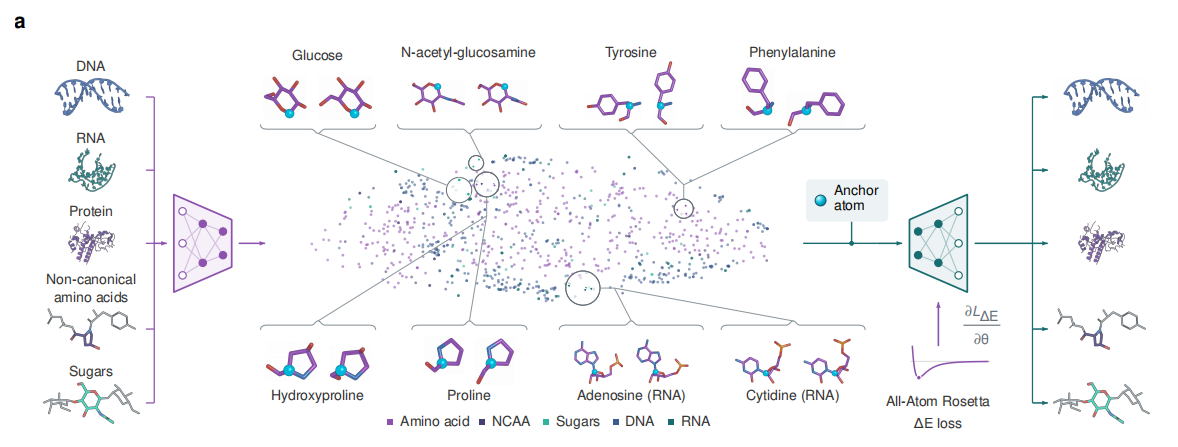
为得到物理上合理的重构结构,微调过程中特别引入基于 Rosetta 能量损失函数,并借助 TMol 对解码坐标求梯度。
Flow-Matching 模型
随后,研究团队训练了一个 Flow-Matching 模型,用以同时生成分子坐标和潜向量,这对 La-Proteina / Proteina-Complexa 提出的部分隐变量框架进行了扩展。
与以往序列-结构协同设计方法相比,研究从四个关键维度对模型进行了升级:
扩充训练数据:引入多模态物理模拟合成数据、结构预测蒸馏数据,覆盖小分子、核酸和蛋白界面;训练过程中对条件信息进行采样时,特意对特征进行调优以贴近真实设计需求,并提升模型对实际有效约束的理解能力,例如在类似酶活性点位的口袋中采样尖端原子位置约束,利用大量仅蛋白质的数据生成逼真原子基序支架任务;强化配对表征:每隔一个 Transformer 块进行一次三角乘法更新(如下图所示),增强单特征到配对特征的信息交互,同时加宽隐层维度;以及内在 / 外在推理。
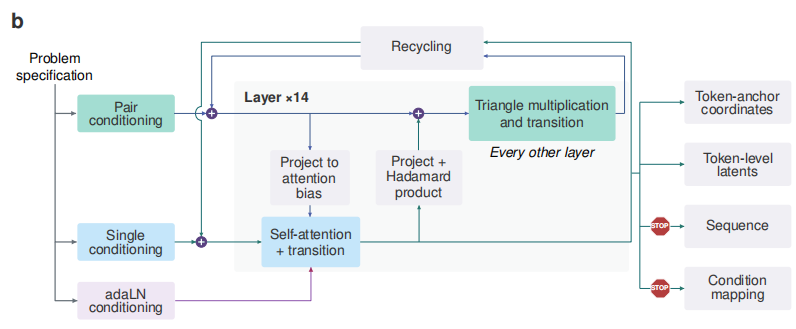
双重推理
内在推理(intrinsic reasoning): 在每个扩散时间步都执行循环精修,而非只在最开始预处理阶段采用。循环传递的次数可随时间步变化,以在生成关键阶段内允许更精细的优化。
外在推理(extrinsic reasoning): 在多条生成轨迹上跨轨迹搜索,把采样结果偏向满足用户自定义指标的设计。与此同时外在推理可采用与特征、时间步绑定方式进行,即在相应分子特征慢慢成型、稳定之后,再去针对性优化各指标,而非全程一股脑优化所有目标。
研究团队用一个测试案例对模型生成过程进行解析:设计一种酶,切断柔性底物中肽链和 DNA 之间的共价键。如下图:
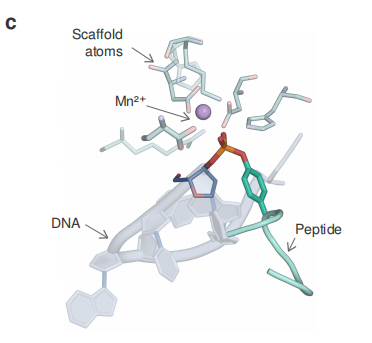
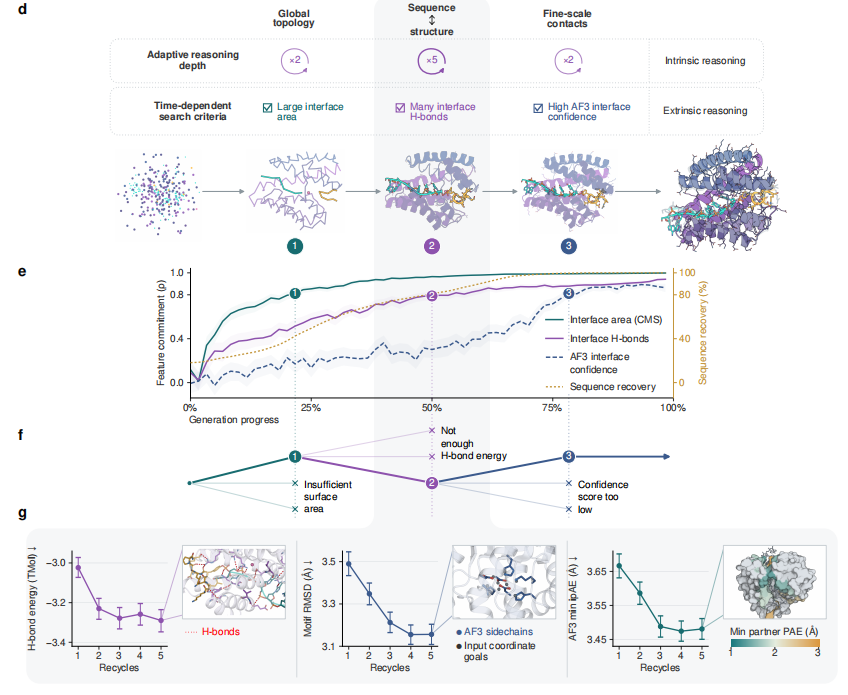
研究发现,不同设计目标会在生成过程的不同时间点逐步达成。具体来说,在 500 条轨迹中,独立推演结果与最终结果的相关性达到了约 0.8 的时间点分别为:
- 界面面积生成进程约 20% 时即可预测;
- 氢键作用约 50% 时即可预测;
- AlphaFold3(AF3)界面置信度约 80% 时可预测。
推理时搜索过程中,依次基于界面面积、氢键作用及 AF3 界面置信度筛选轨迹,在每个检测节点终止偏离当前标准的轨迹,这种时序搜索可以高效遍历潜空间,找到满足所有标准的输出结果(如下图所示)。与简单采样相比,在上述案例中,每 GPU 小时得到的独特合格设计数量是原来的 3 倍。
诸多创新,尤其是内在 / 外在双重推理的引入,使得 RFD4-Proteina 突破了既往传统蛋白生成模型的两大瓶颈——可覆盖的分子化学空间受限、高效搜索满足耦合化学-几何约束的能力不足;将蛋白设计从单纯扩散采样升级为带推理、物理约束、序列-结构联合共优化的大统一生物分子设计范式。
仿真基准与湿实验双重检验模型能力
不同分子场景下的验证
研究团队首先在计算机仿真测试中,将 RFD4-Proteina 与其他生成式、幻构(hallucination)、结构精修类方法进行了对比,测试任务含四大类:蛋白结合子设计(24 个靶点)、小分子结合子设计(77 个靶点)、酶骨架搭建(37 个靶点)、DNA 结合子设计(3 个靶点)。如下图所示:
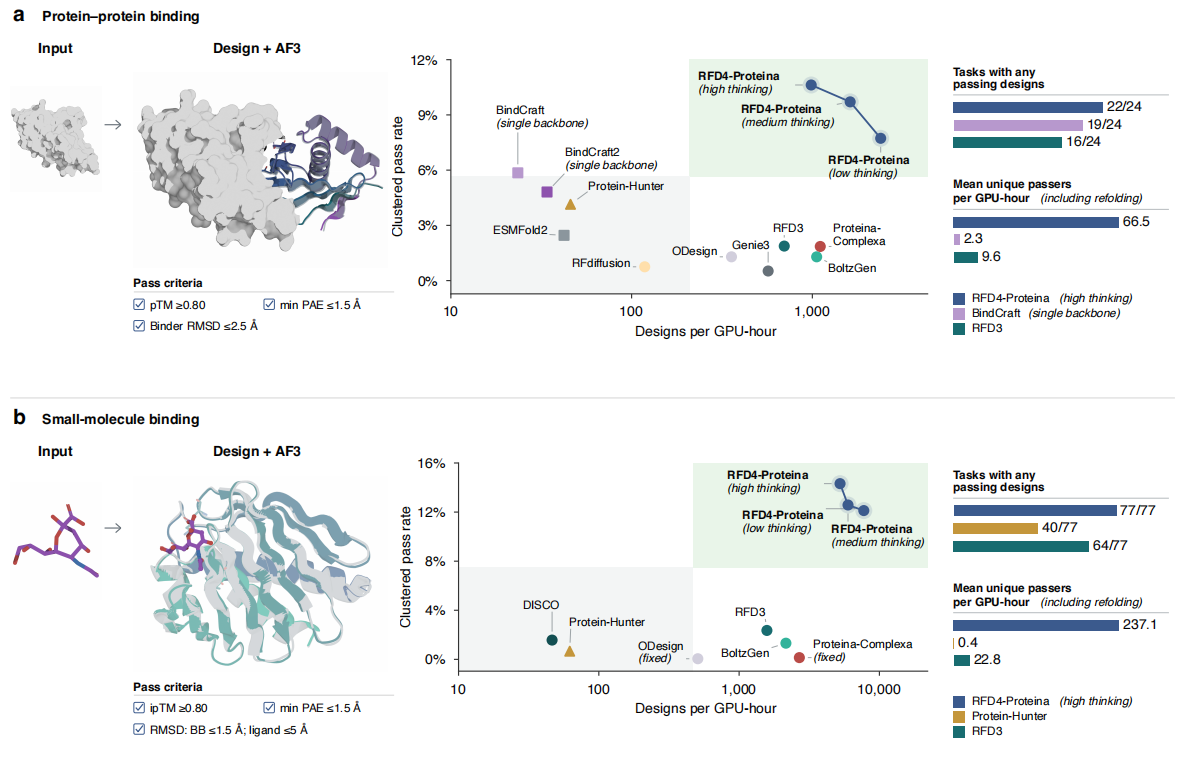
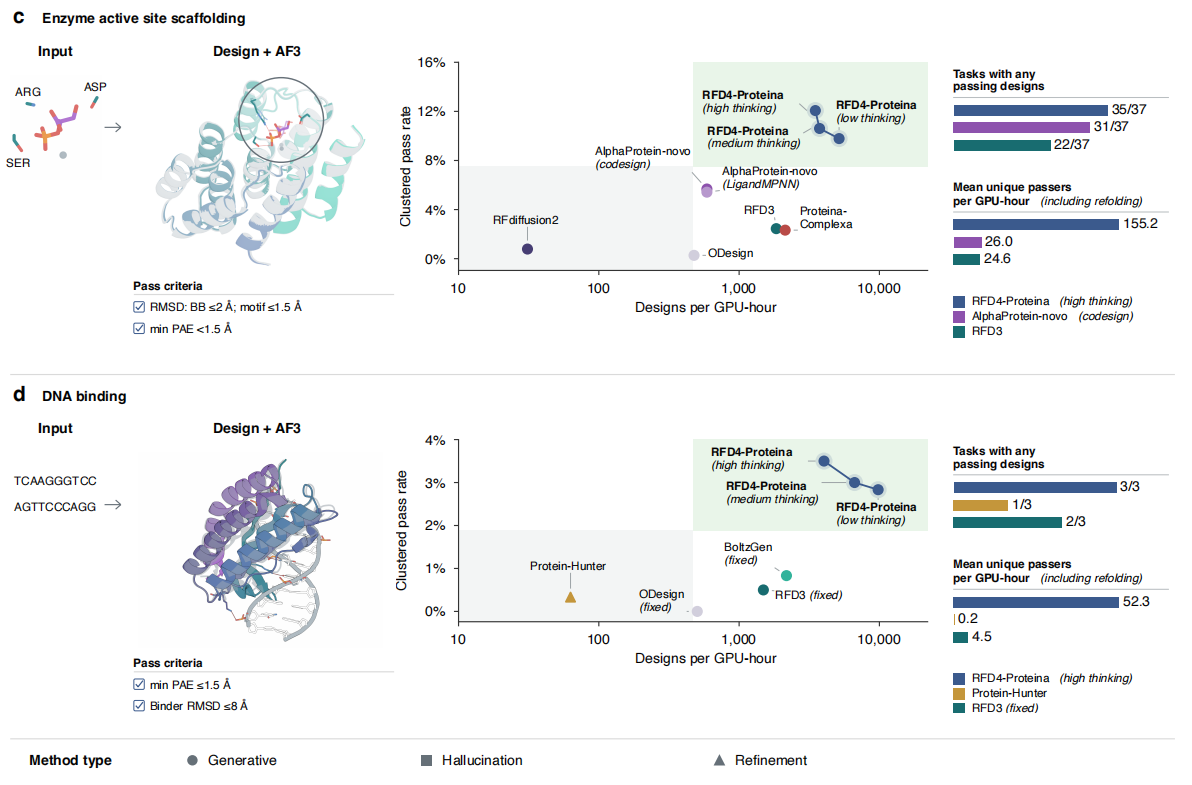
评估方式是通过 AF3 根据设计序列独立预测结构,评估其与目标结构的契合度,以及是否符合任务特定的结构和置信度标准。两个核心指标:
- 生成吞吐量(generation throughput): 每 GPU 小时能产出多少条设计;
- 聚类通过率(clustered pass rate): 每次初始尝试中通过评判标准、且结构互不重复的合格结构占比。
在 high-thinking 条件下,结果显示,蛋白质结合任务中,RFD4-Proteina 聚类通过率达到 10.6%,表现次优的 BindCraft 模型仅为 5.9%,生成吞吐量提升 42 倍;酶骨架搭建任务中,RFD4-Proteina 聚类通过率为 12.1%,AlphaProtein-novo 协同设计模型为 5.7%,生成吞吐量提升 5.9 倍;小分子结合任务中,RFD4-Proteina 聚类通过率为 14.3%,RFD3 为 2.4%,生成吞吐量提升 3.3 倍。且 77 个目标全部通过设计(RFD3 为 64 个);DNA 结合任务中,RFD4-Proteina 聚类通过率为 3.5%,BoltzGen 为 0.8%。
可见,在四个基准测试中,RFD4-Proteina 在生成过程中无需结构预测器反馈的情况下,能解决的设计挑战数量多于所有对比的基线模型,同时聚类通过率更高、生成速度更快。而计入 AF3 评估时间后,high-thinking 下 RFD4-Proteina 每 GPU 小时生成的有效聚类数量,分别比蛋白质结合、小分子结合、酶骨架搭建和 DNA 结合任务中的次优基线模型高出 5 倍、10.4 倍、6 倍 和 5.5 倍。
在测试提升内在推理能力是否能提高设计成功率时,蛋白质结合任务分别在 Low、Medium 和 high-thinking 设置下,聚类通过率从 7.7% 逐步提高到了 10.6%;小分子结合任务从 12.1% 提升到了 14.3%;酶骨架搭建任务从 9.8% 提升到了 12.1%;DNA 结合任务从 2.8% 提升到了 3.5%。不过生成吞吐量随计算量增加反而降低,如在蛋白质结合任务中,每 GPU 小时的设计数量从 2388(Low) 下降到了 986 个(high-thinking)。
在生成过程中允许分子环境改变构象是否能提高设计成功率时,RFD4-Proteina 在 high-thinking 条件下,当允许与设计蛋白共同生成配体构象时,聚类通过率从 8.1% 提升到了 14.3%;允许目标侧链与 DNA 构象发生变化时,蛋白结合的聚类通过率从 9.6% 提升到了 10.6%;DNA 结合的聚类通过率从 2.0% 提升到了 3.5%。
在探究外部推理是否能通过整合来自其他工具的数据提升设计成功率时,发现搜索可以通过借助外部工具,避免在无前景的轨迹上浪费计算资源,在酶骨架搭建任务和小分子结合等高难度任务中,生成合格独特设计的效率分别提升了 22.6% 和 24.6%。
最后消融实验逐个确认,三角更新、Hadamard 积运算、内在推理机制、探索式训练,都是模型性能提升的关键组件,其中三角乘法更新对性能贡献最大,其余组件分别带来不同程度增益,并非单一技巧实现整体提升。
特定分子工作流中的验证
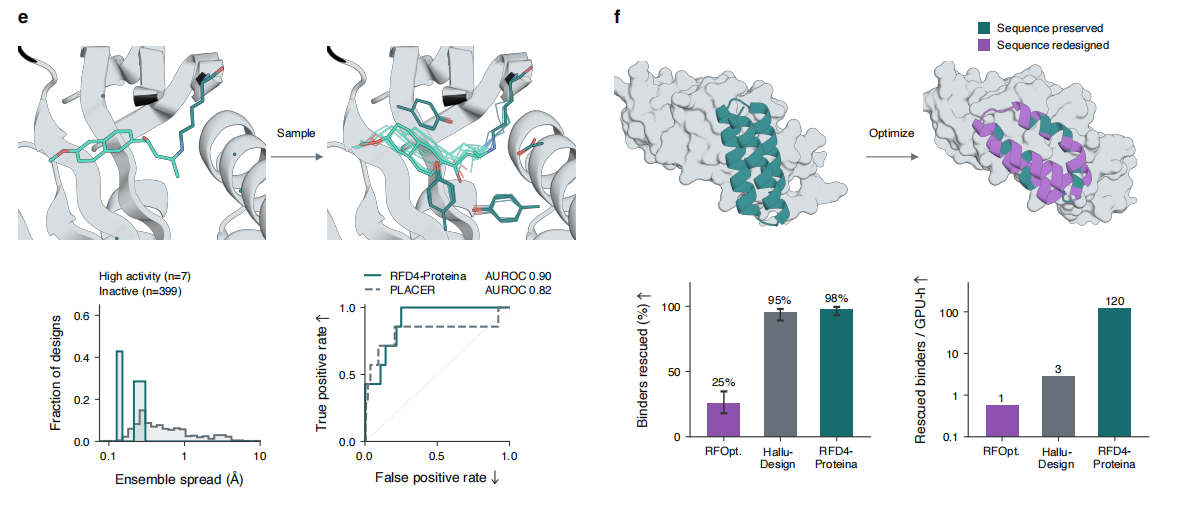
在对新设计的生成进行验证后,研究人员就同一模型是否支持构建、评估和优化设计所需的其他分子流程进行了评估,实验测试了六种用例,涵盖序列分配、构象采集以及现有结构的优化等,如下图所示:
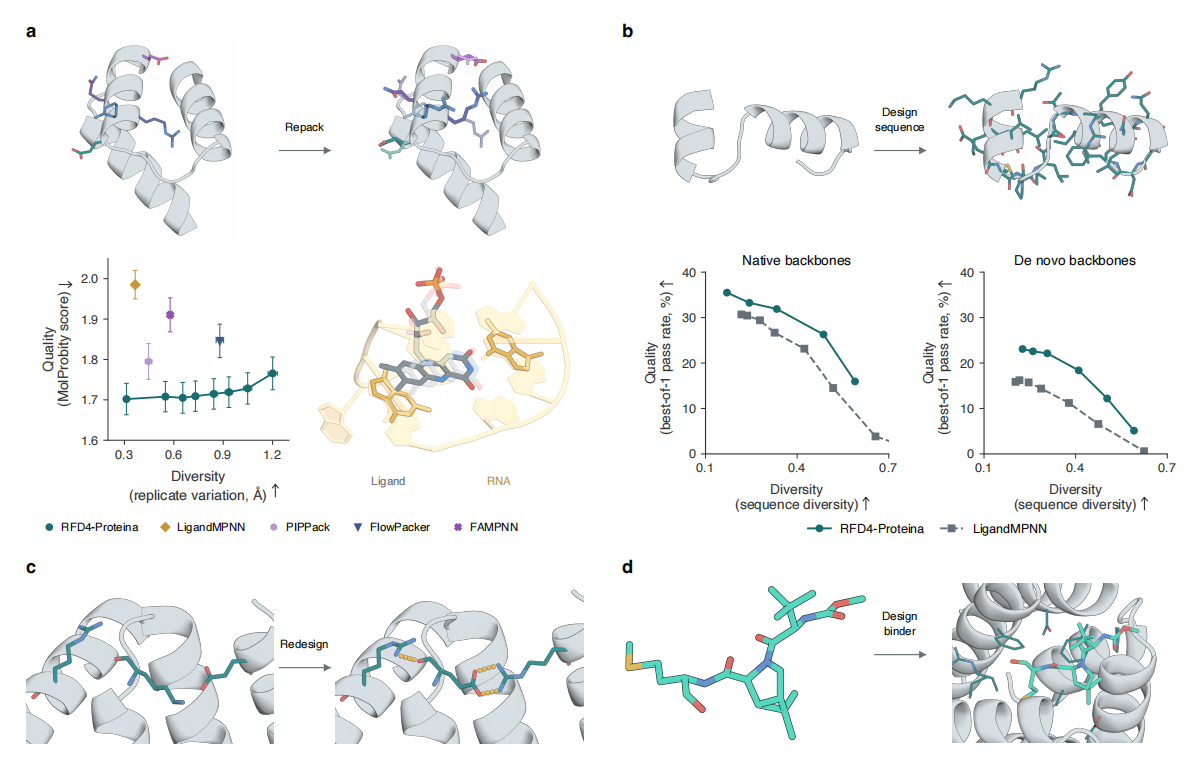
Side-chain packing 任务中,当给定蛋白质序列和主链坐标时,RFD4-Proteina 在相似的构象多样性下,获得比 LigandMPNN 更低的平均 MolProbity 分数,为 1.70 比 1.99。
MolProbity:蛋白结构质检工具,用来查键长、键角、空间冲突、不合理扭转等,是侧链打包任务最常用指标;MolProbity 分数越低,代表结构立体化学质量越好
增大采样噪声,可以将侧链两两之间的平均差异从 0.31 Å 提升到 1.20 Å,表明可以在不影响结构质量情况下产生多样化构象,且 MolProbity 分数只从 1.70 小幅升到 1.77。
固定骨架序列设计任务中,将 RFD4-Proteina 作为逆折叠工具进行评测。结果显示,分别使用天然蛋白骨架和由 RFD3 生成的从头设计骨架两种测试集验证, RFD4-Proteina 在匹配多样性下也始终比 LigandMPNN 的通过率高。
柔性骨架序列设计任务中,在 13 组 HBDesigner 的靶点 / 脱靶测试集上,柔性骨架的 RFD4-Proteina 的平均特异性差 △ipTM 为 0.25,而固定骨架的 RFD4-Proteina 只有 0.18,且该数值在所有对比方法中为最高值。
△ipTM 为靶标与脱靶之间 ipTM 差值;数值越高,代表对目标靶点相对脱靶蛋白的特异性越强
配体立体化学任务,RFD4-Proteina 手性正确性(chirality)为 98.8%;双键立体化学(double-bond stereochemistry)正确性为 92.2%;PoseBusters 打分(整体化学合理性)为 92.3%,均优于 AF3 以及排名第二的生成模型。
设计优化任务中,对于已生成但未通过实验测试的设计是否仍可挽救的探究显示,在每个设计尝试 6 次优化后,RFD4-Proteina 可以成功修复 102 个设计中的 100 个,而 HalluDesign 仅修复了 97 个,RFoprimization 仅修复了 26 个。另需强调的是 RFD4-Proteina 的耗时也极短,短于其他任何模型。
湿实验验证
研究团队测试了 RFD4-Proteina 在多种以特异性为核心约束的设计任务上的表现。
首先针对钙调蛋白(如下图),其存在两种状态:无钙态(一个构象)和结合 Ca²⁺(变为完全不同的构象),研究团队目标是只识别后者这一状态的钙调蛋白。在测试的 18 个设计序列中,12 种表现出钙离子依赖的结合,其测定的表观亲和力区间为 69 pM 至 37 nM。
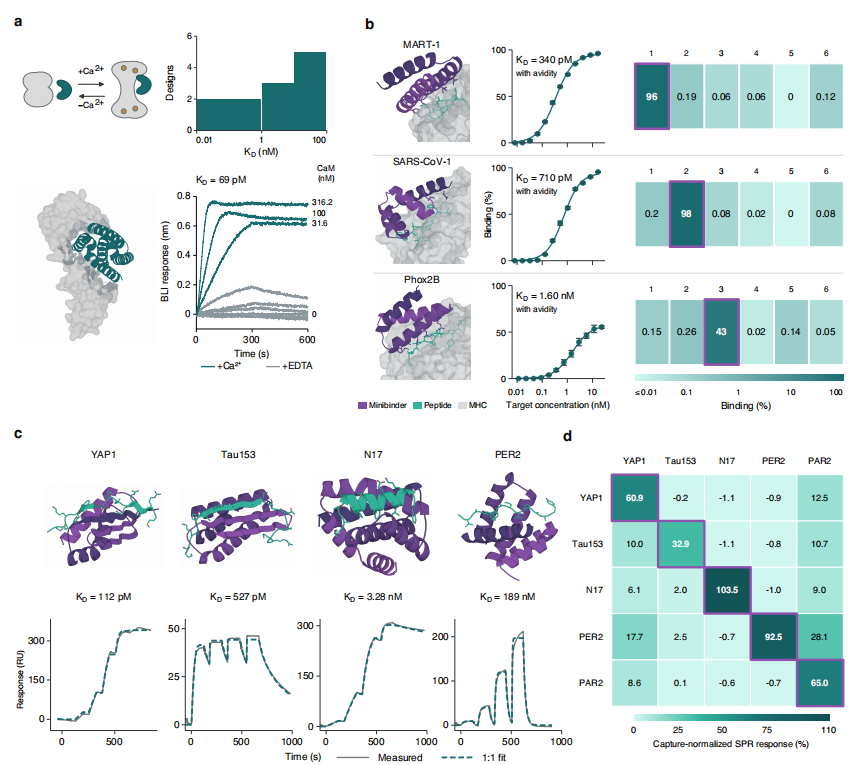
在 pMHC 任务中,研究团队评估了 RFD4-Proteina 与目标肽精准结合的能力,针对 MART-1、SARS-CoV-1 膜蛋白肽和 Phox2B 肽设计结合蛋白。酵母展示滴定实验显示,针对三种肽的结合蛋白,表观半最大结合浓度分别为 340 pM、710 pM 和 1.60 nM,且再拿序列很像的脱靶肽做筛选,结果在所有情况下均实现超过 100 倍的特异性差异。
值得一提的是,一些目标肽与非目标肽十分相似,如 Phox2B 的脱靶肽只和目标肽差 1 个氨基酸;SARS 只相差 2 个氨基酸,体现了 RFD4-Proteina 可以设计高特异性 pMHC 微型结合体。
在 IDRs 任务中,研究团队测试了 RFD4-Proteina 的构象推理能力是否能实现针对 8 种 IDRs 肽的结合体设计,结果显示两类 IDR 肽中各出现 1 个失败,其余 6 个均得到高亲和力结合体,其中首批人工从头设计、靶向 YAP1 和 Tau 表位 IDR 的结合蛋白,最强亲和力分别达到 112 pM 和 527 pM。
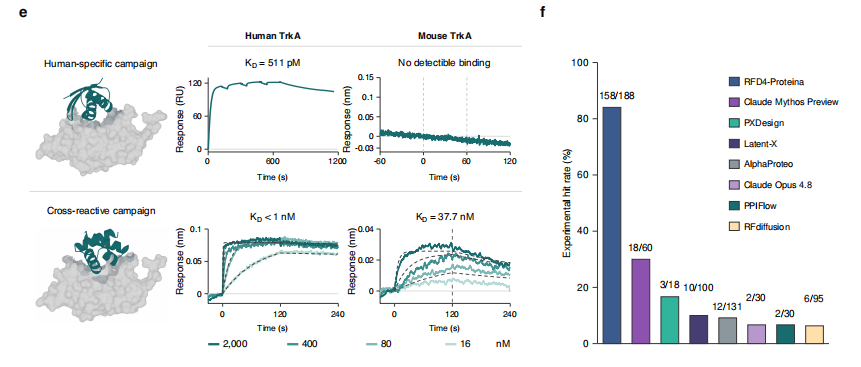
在激酶蛋白设计任务中,研究团队分别设置了两个任务:只结合人 TrkA,不结合小鼠 Trk A,也不结合人 TrkB、TrkC;同时结合人 TrkA 和小鼠 TrkA,但依然不结合 TrkB 和 TrkC。在跨物种交叉反映实验中,94 个设计中有 18 个满足期望模式;最佳的对人TrkA 的亲和力低于 1 nM,对小鼠 TrkA 为 37.7 nM。
在无特殊约束,只要求结合人 TrkA 时,RFD4-Proteina 的 188 个设计中有 158 个达到了低于 1 μM 亲和力,成功率达到 84%。相比之下,Claude Mythos Preview(可使用开源蛋白设计工具)仅为 18 / 60,成功率仅 30%。
研究人员随后测试了 RFD4‑Proteina 能否处理带有翻译后修饰的复合分子体系:糖基化和磷酸化。
在糖基化任务中,过往局限在于只能稳定留住 Man5~Man8 这类短的高甘露糖糖链,无法稳定保住最长的 Man9 或 GlcMan9,此次目标是用 RFD4‑Proteina 设计更小的蛋白,主要保留 Man9 / GlcMan9,同时末端甘露糖依然可接触。
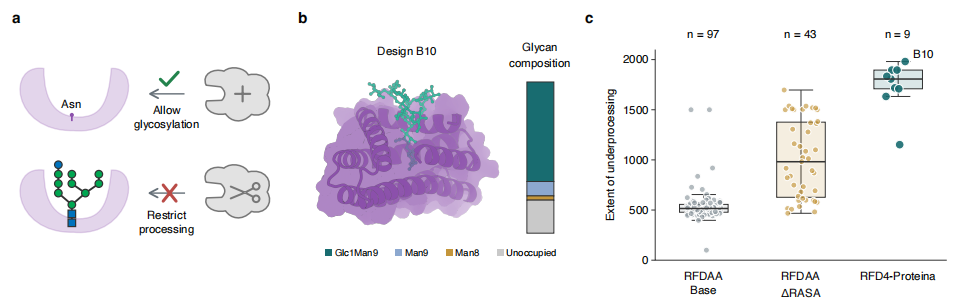
结果显示,RFD4‑Proteina 相比传统的 RFDAA 实现了计算设计通过率大幅提升,在 LC-MS/MS 质谱检测中,9 个设计里有 8 个,修饰位点上 90% 以上都是高甘露糖糖链(没有被修剪),未修剪成功率高于此前所有方法。
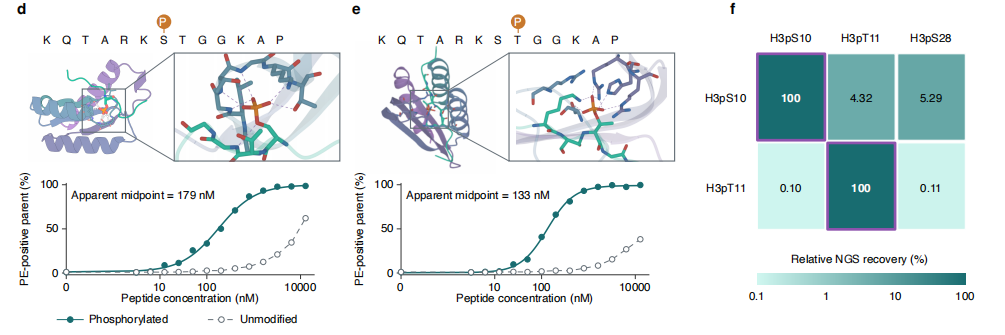
在磷酸化任务中,研究团队挑战组蛋白 H3 尾部相邻的两个位点 —— pS10 和 pT11,分别得到磷酸化依赖的结合蛋白。结果显示,命中序列优先结合其磷酸化靶标,且各自对相邻非靶标位点的磷酸化保持选择性,这凸显了 RFD4‑Proteina 能够识别局部化学微环境的精细差异,而不只是识别一个磷酸基团,还能识别这个磷酸基团接在哪一个氨基酸、在哪个序列上下文里,实现位点级别的精准区分。
酶设计是一项极具前途的研究,可为各种各样的化学反应造出高效、绿色、选择性好的生物催化剂。研究团队选出两类高难度酶任务来验证 RFD4‑Proteina 搭建活性中心的能力,分别是双金属酶和半胱氨酸连接酶。
首先是测试 RFD4‑Proteina 能否设计出可水解对氧磷的磷酸三脂酶。此前团队采用 RFD3 设计在两种金属辅因子和对氧磷底物周围搭建了 6 种催化残基,得到的催化效率相对较低,最高只有 4±3M⁻¹s⁻¹。本实验猜想增加两个催化残基,以提升催化效率。
结果显示在这个含八个残基的模拟酶上,RFD4‑Proteina 的 1000 个设计中,有 15 个(1.5%)通过了常见基序 RMSD 和底物置信度标准;相比之下,RFD3 设计的 1000 个中无一通过。
RMSD 越小代表设计出的活性位点和理想 theozyme 构型越贴近
在后续实验筛选中显示,288 个 RFD4‑Proteina 设计中有 89 个具有活性,涵盖 47 个骨架家族中的 25 个;而 RFD3 设计的 192 个均无活性。
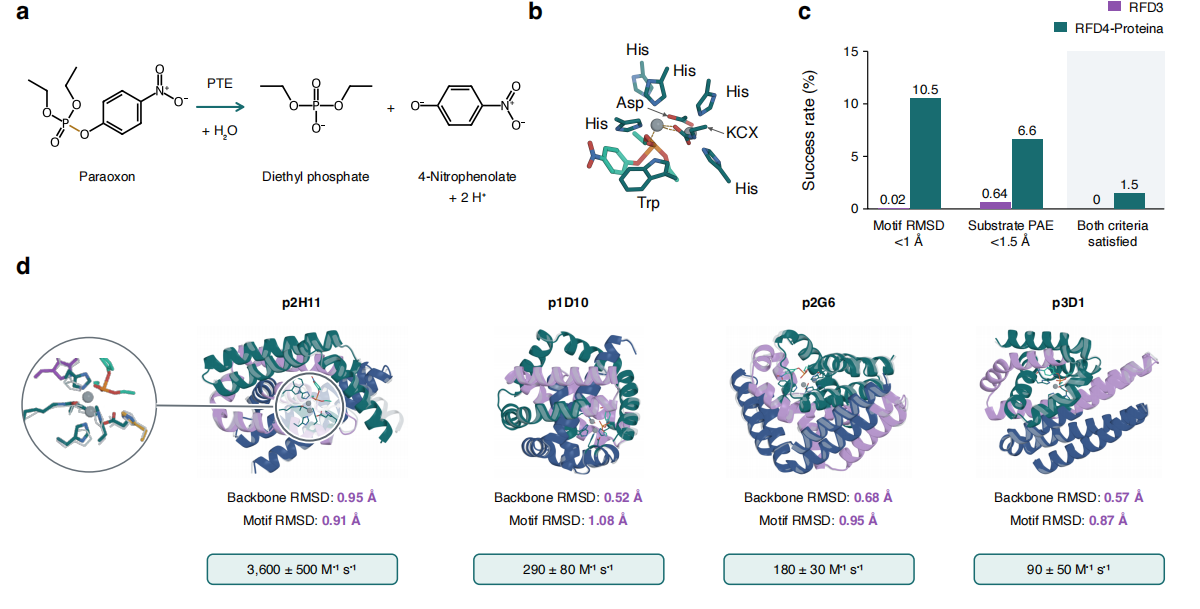
随后团队对 4 个骨架家族的 6 个设计进行了表征,其中最佳设计的催化效率分别达到 kcat / KM = 3600 ± 500 M⁻¹s⁻¹ 和 kcat = 0.9 s⁻¹,相比未催化的水解反应速率提升了 1.5 × 10⁷ 倍;6 个经鉴定的设计,其催化效率均比此前六残基模拟酶磷酸三酯酶高出 10 至 1000 倍。
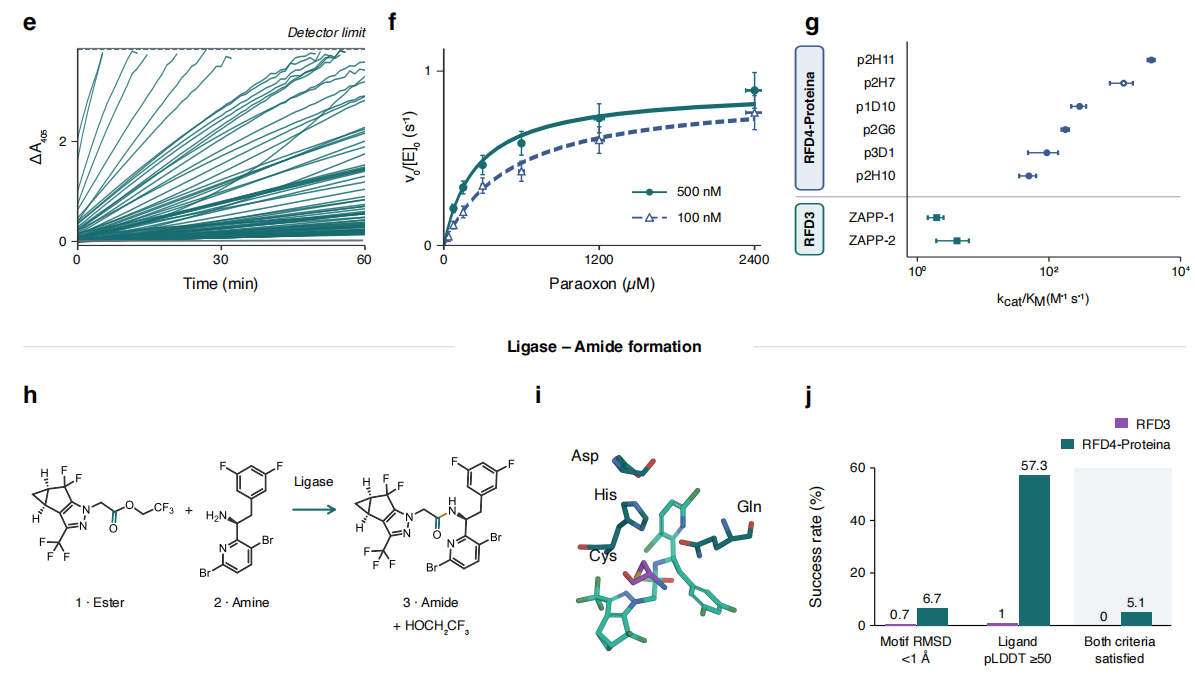
研究团队继续探索了 RFD4‑Proteina 能否设计用于生物制药的成键酶。选择的测试靶点反应为 Lenacapavir 合成路线中的一步,涉及活化酯与空间位阻较大的手性胺连接,形成酰胺键生成反应。
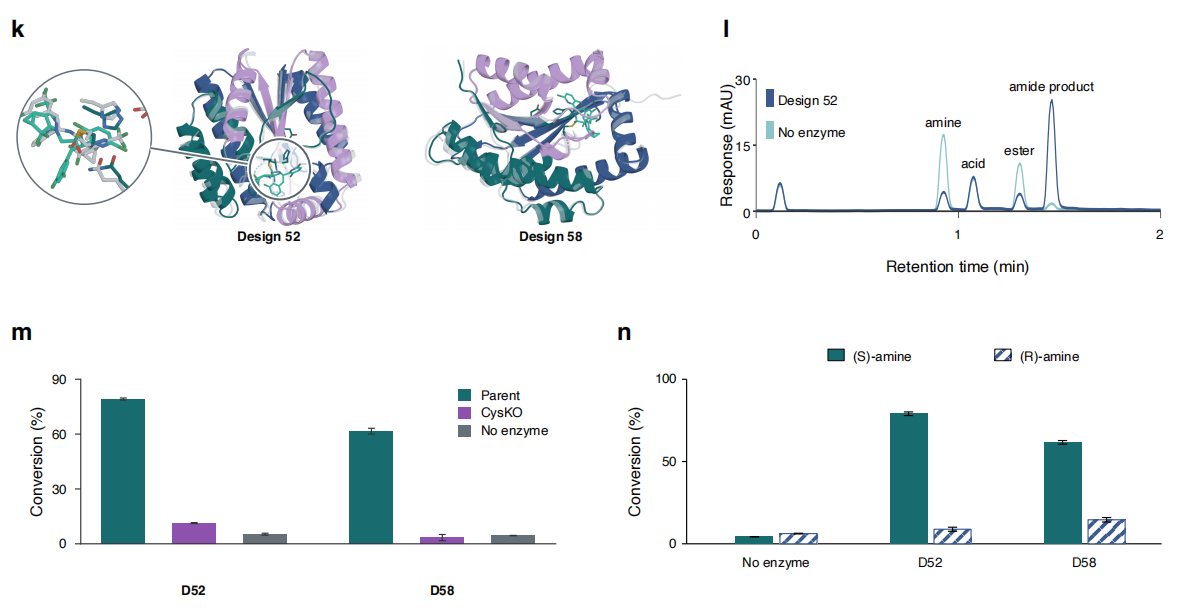
计算筛选结果显示,RFD4‑Proteina 的计算通过率比 RFD3 高出数个数量级;挑出 67 个设计序列的基因用于实验测试,其中有 4 个设计序列成功实现酰胺键的形成,且生成的目标 S-胺产物含量高于背景值;相比之下此前借助 RFD3 设计的 72 个设计均未获得有效结果。
两个最优设计为 52 号和 58 号,分别将 79% 和 61% 的 S 构型胺转化为酰胺;对 R 构型胺的转化率仅为 8.8% 和 14.6%;无酶对照组的转化率分别为 4.3% 和 6.2%。
写在最后
总的来说,RFD4‑Proteina 将物理建模与深度学习深度融合,不再仅仅依赖学习 PDB 数据库里的天然蛋白统计分布,同时额外引入物理模拟合成数据集,并结合可微分的 Rosetta 力场对生成过程进行监督引导。它打破了过去多种专用工具割裂工作的局面,依靠潜空间推理范式,让蛋白质设计从盲目采样生成,转向带评估、迭代优化的约束搜索模式,在计算机基准测试中大幅提升复杂分子设计的成功率与计算效率。
当然模型也并非完美,推理调度参数往往需要小规模预实验摸索调优,复杂任务会带来一定计算开销。但开源的代码与权重为整个领域提供了新起点,它提示我们,将 AI 生成与生物物理规则紧密结合,能够拓展蛋白设计的边界,帮助科研人员更快把计算机设计的分子,转化为湿实验中具备真实功能的结合蛋白、全新人工酶,为药物开发、合成生物学带来更多可能性。