Command Palette
Search for a command to run...
在线教程丨覆盖40种语言/处理1小时录音,英伟达开源Nemotron 3.5 Transcribe,实现指令控制的语音识别、翻译与音频问答

一段会议录音转成文字后,仍可能留下不少问题:多人发言该如何区分?专业术语有没有听错?如果还要制作字幕或翻译,能否直接从录音得到所需结果?
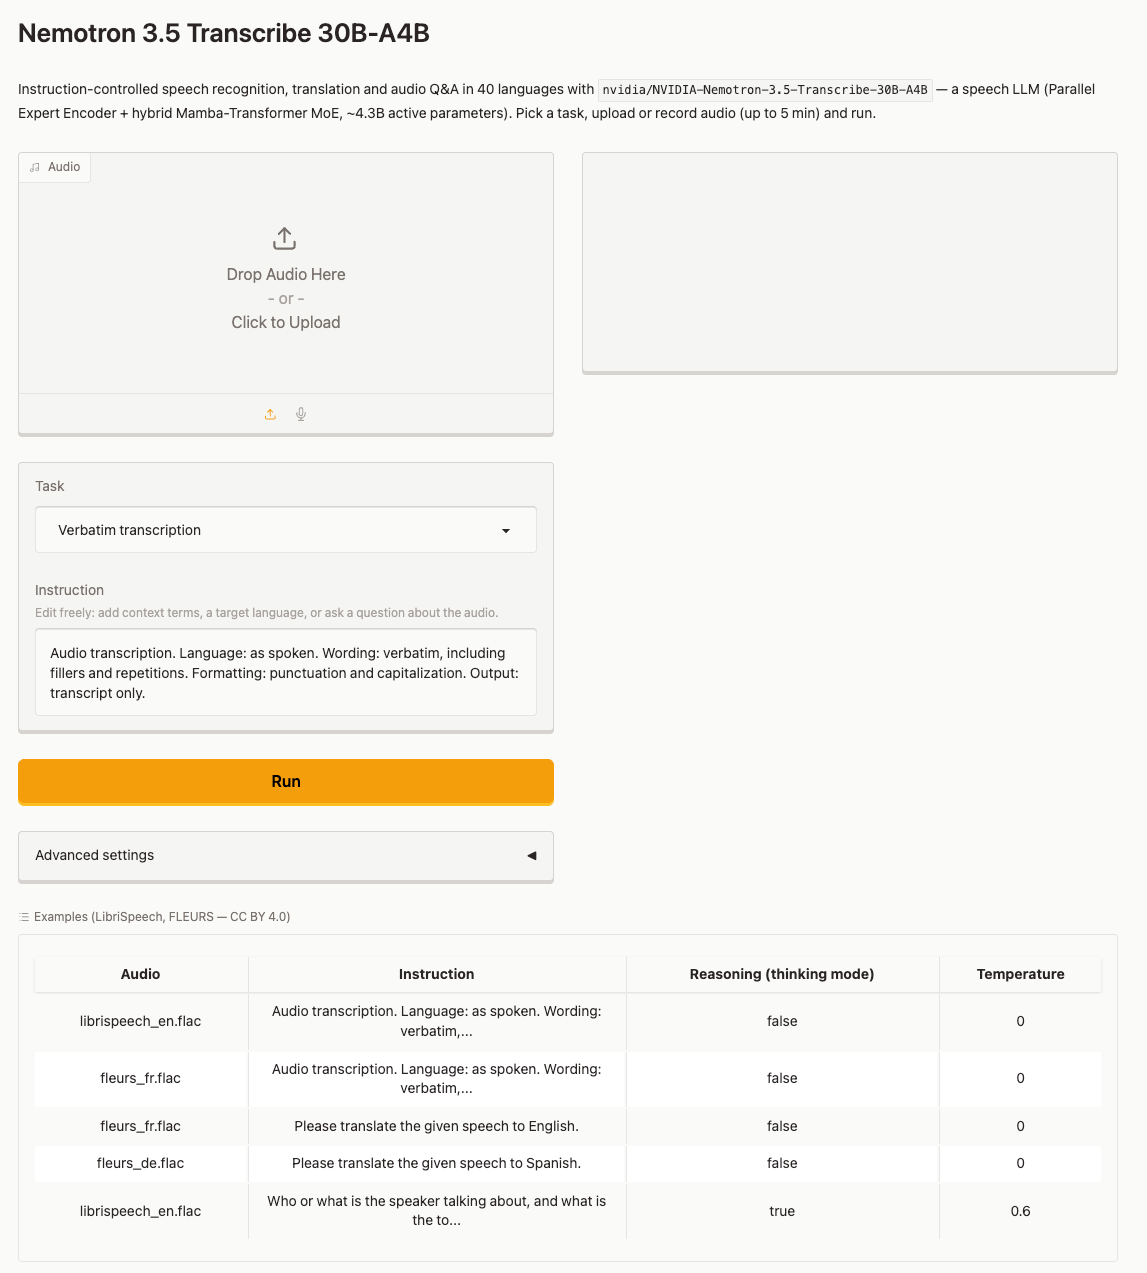
NVIDIA 推出的 Nemotron 3.5 Transcribe 试图用指令处理这些不同需求。用户可以要求模型保留口头填充词和重复,生成逐字稿;也可以让它整理表达,输出更易阅读的文本。模型还支持说话人标注、语音翻译、语言识别和音频问答。 根据官方模型卡,它覆盖 40 种语言,可处理最长约 1 小时的录音;不同语言和任务的支持程度有所区别。
Nemotron 3.5 Transcribe 采用 Mamba-2 与 Transformer 混合的 MoE 架构,总参数量约 34B,处理每个 Token 时约激活 4.3B 参数,包含音频编码器。NVIDIA 公布的评测显示,模型在英语、长音频和多语言语音识别基准上取得了有竞争力的成绩。它面向离线音频处理,不能因内部采用分块机制就将其视为实时流式转录模型。
目前,HyperAI 已上线「NVIDIA-Nemotron-3.5-Transcribe-30B-A4B:指令控制的语音识别、翻译与音频问答」,完成环境配置,极大降低部署门槛 ⬇️
在线运行:
更多在线教程:
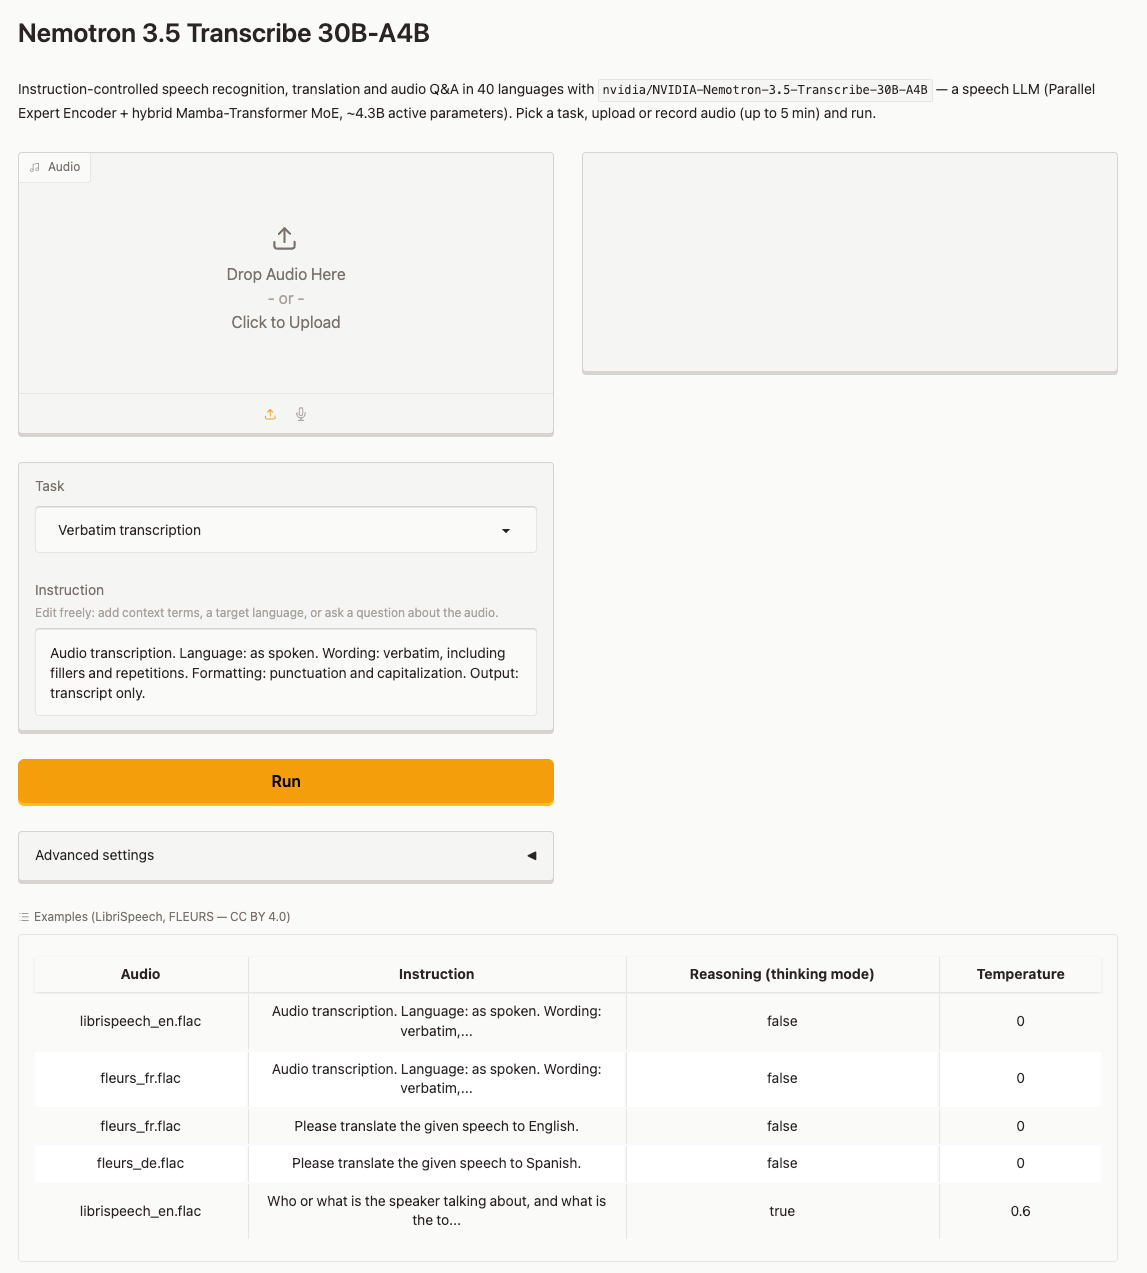
Demo 运行
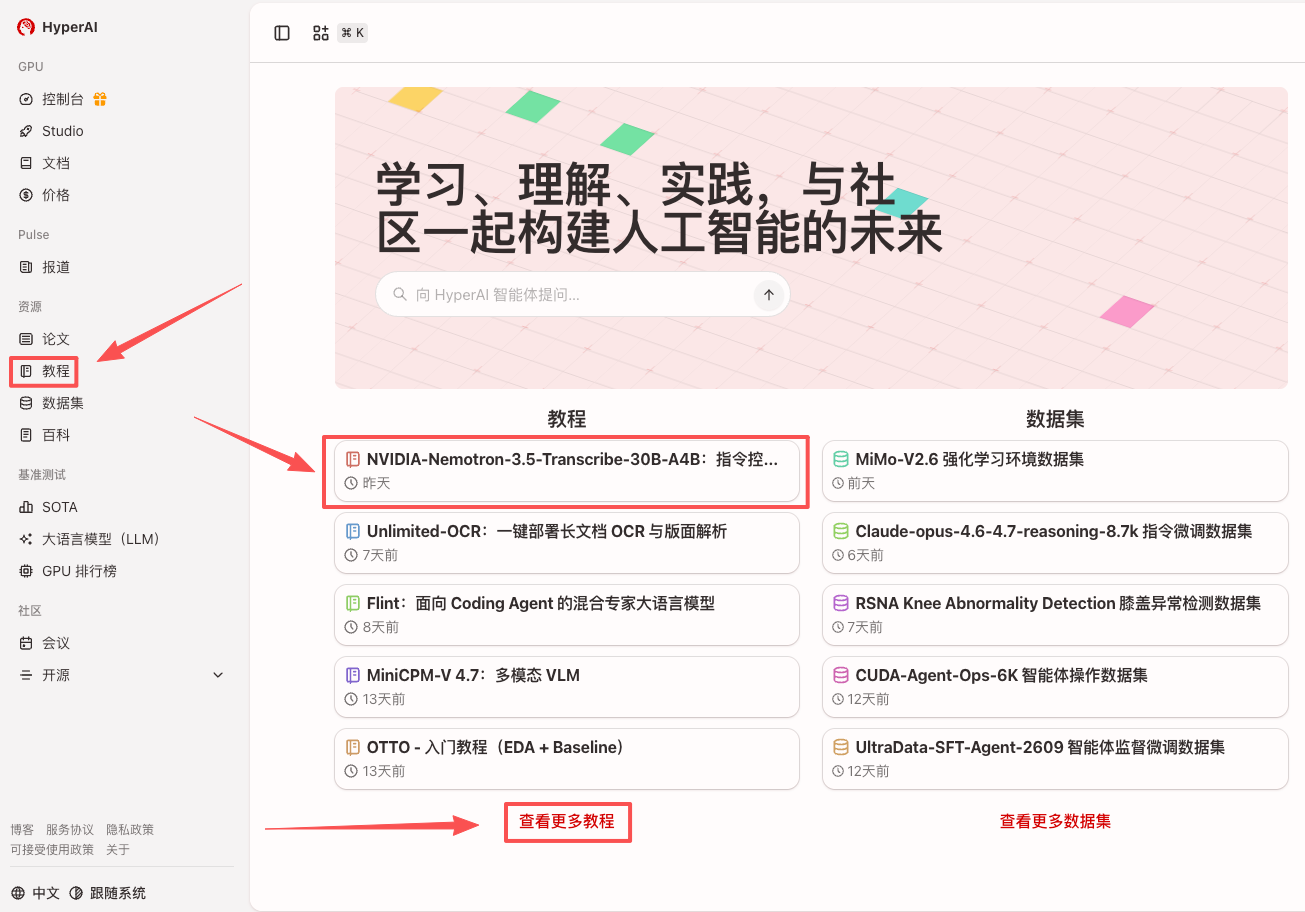
- 进入 hyper.ai 首页后,选择「教程」页面,或点击「查看更多教程」,选择「NVIDIA-Nemotron-3.5-Transcribe-30B-A4B:指令控制的语音识别、翻译与音频问答」,点击「运行此教程」。
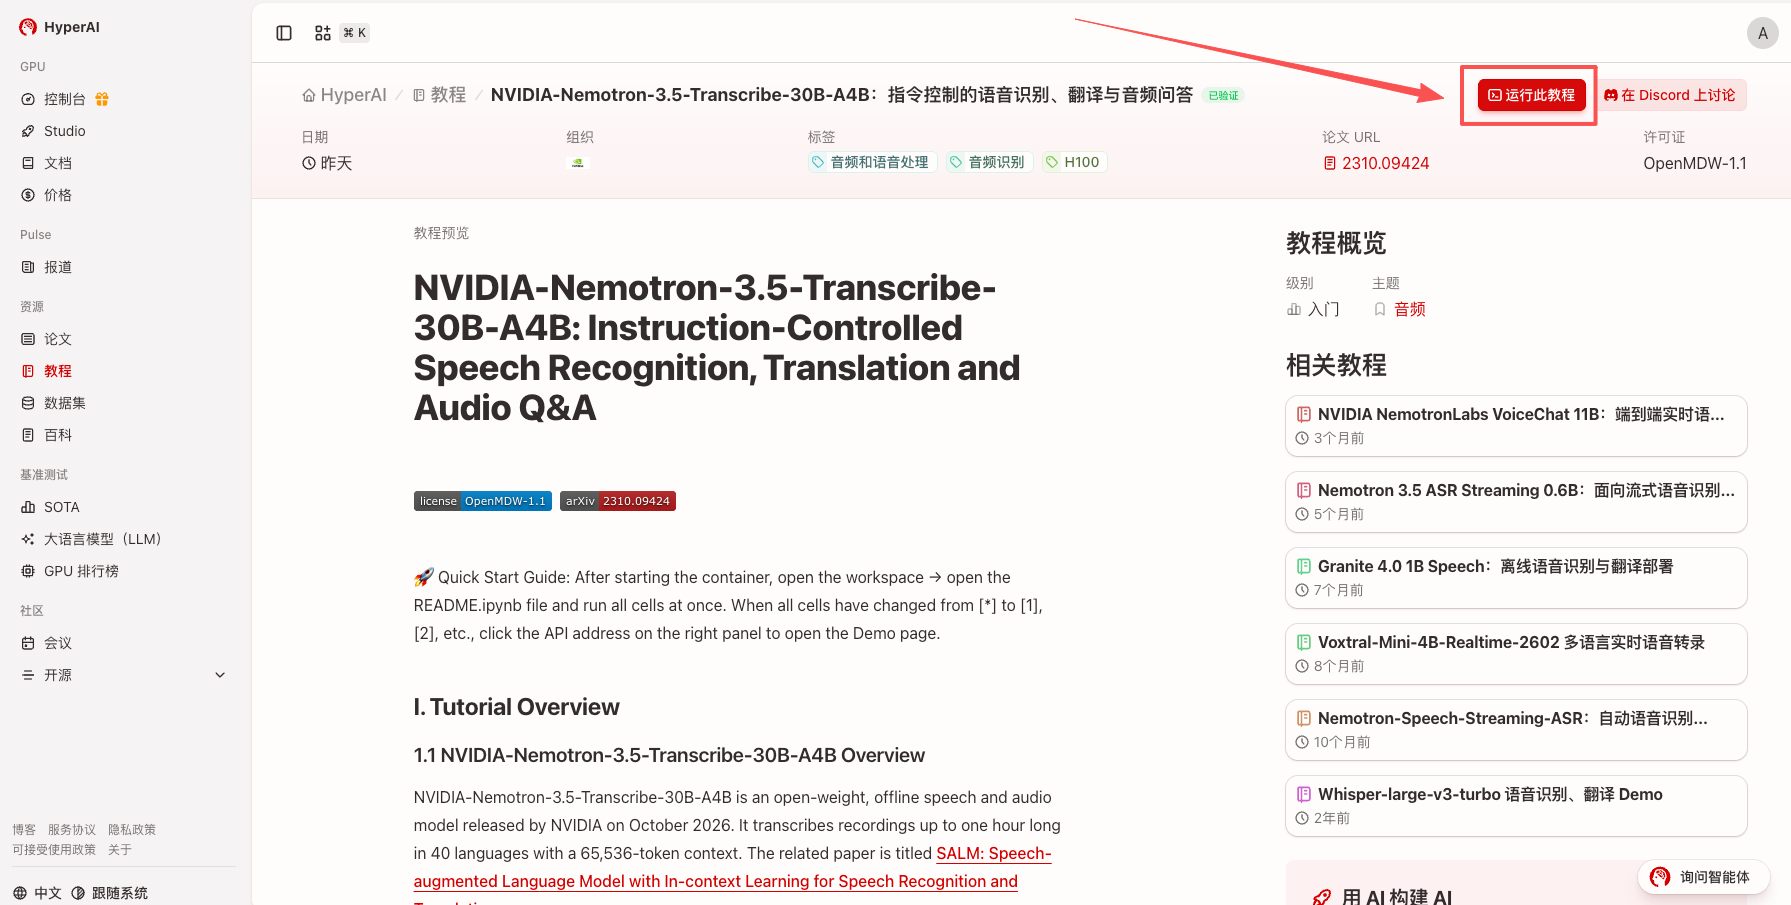
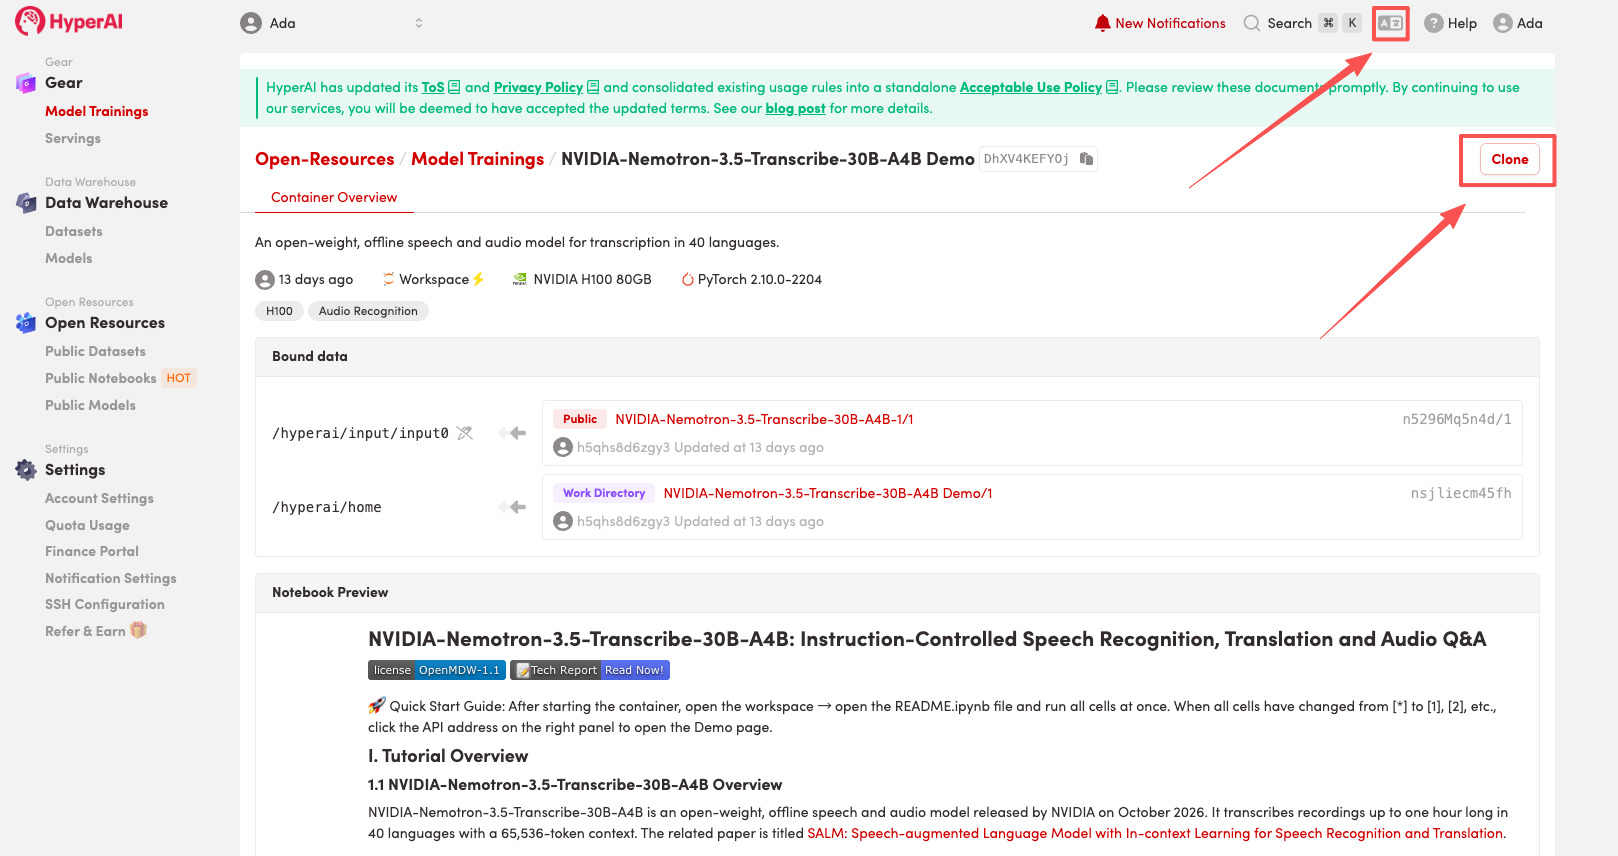
2.页面跳转后,点击右上角「Clone」,将该教程克隆至自己的容器中。
注:页面右上角支持切换语言,目前提供中文及英文两种语言,本教程文章以英文为例进行步骤展示。
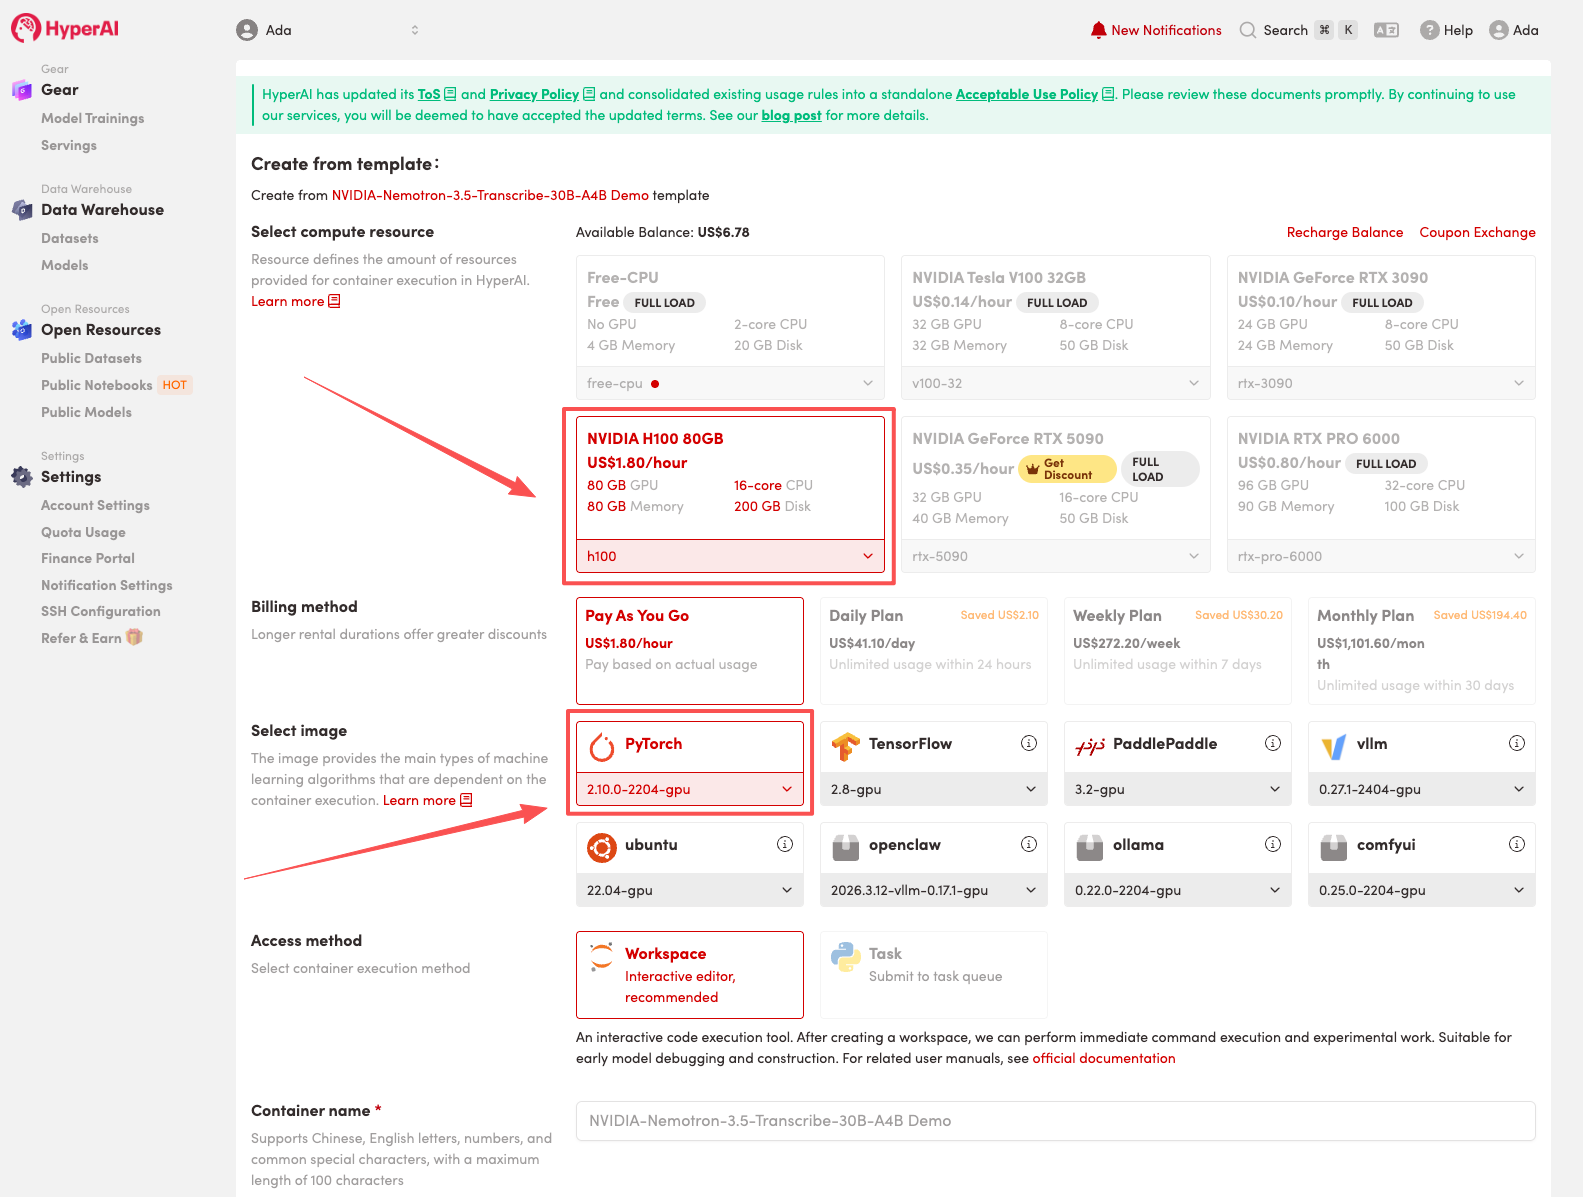
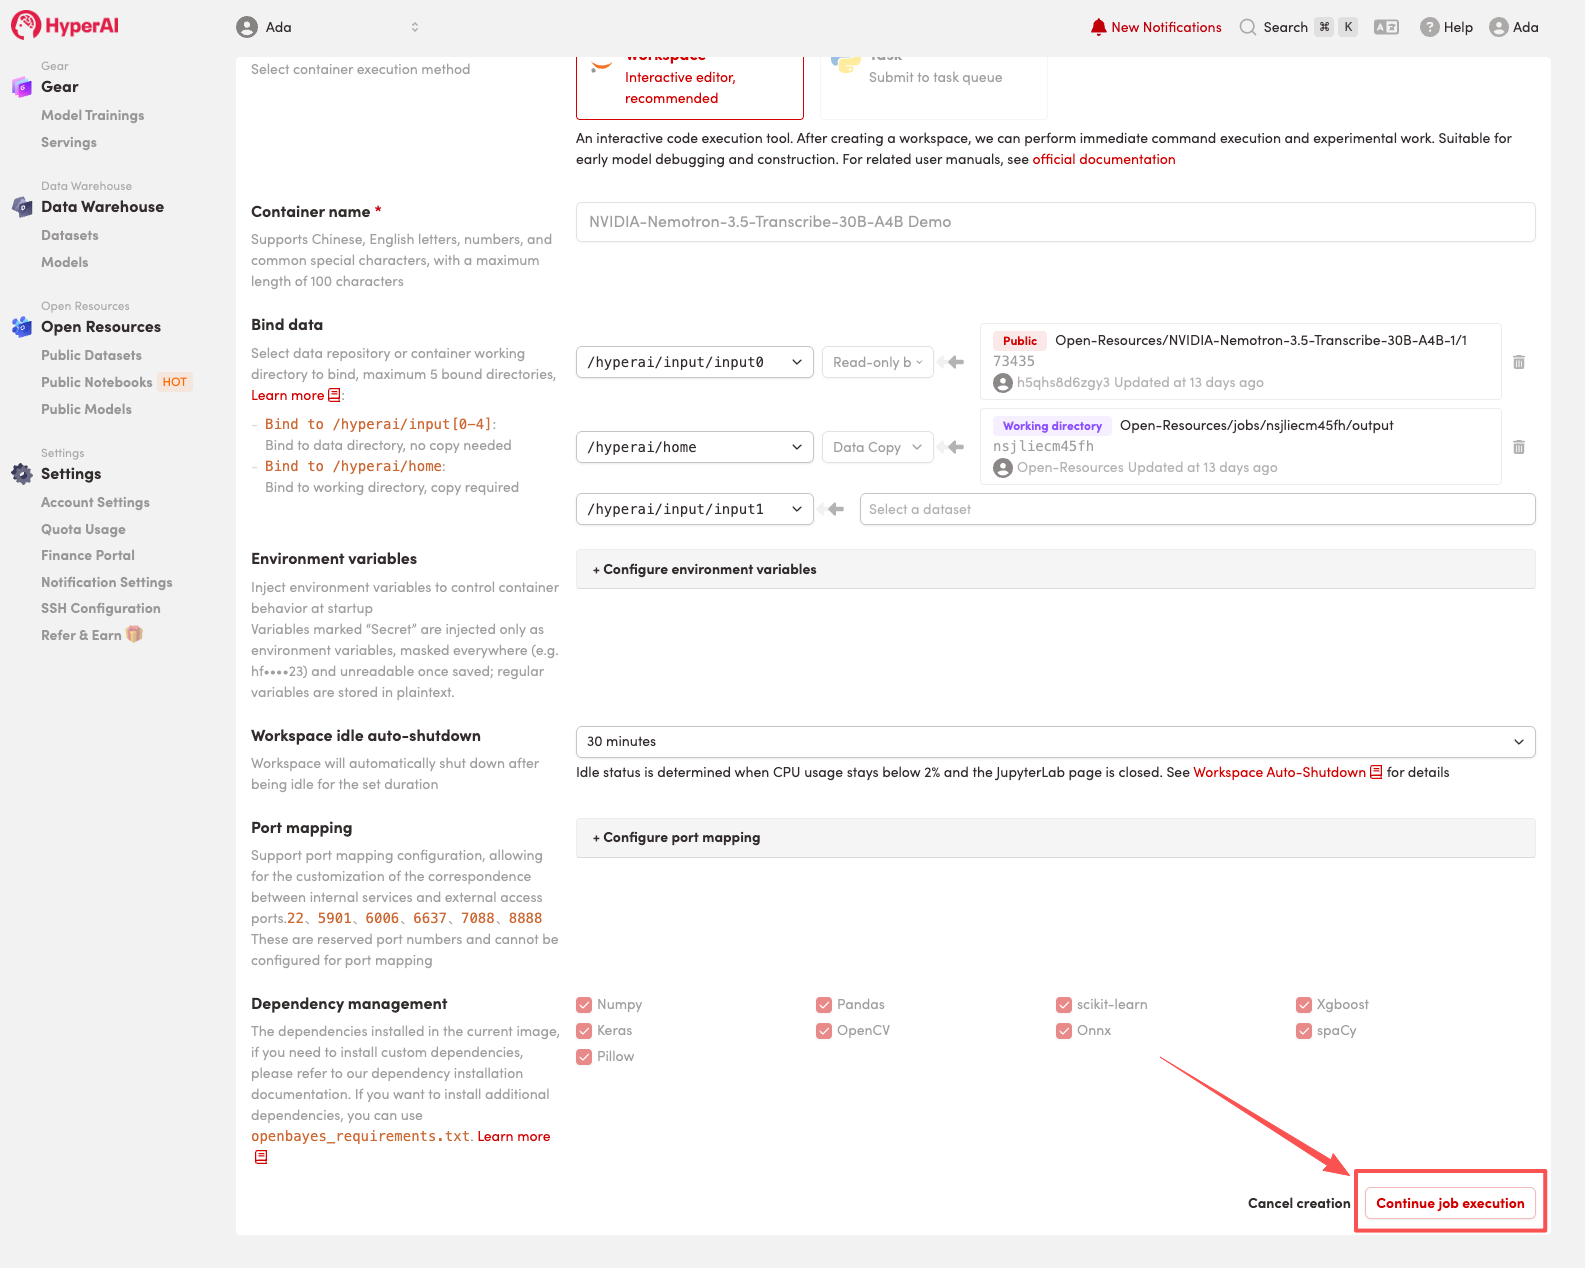
- 选择「NVIDIA H100」以及对应镜像,点击「Continue job execution(继续执行)」。
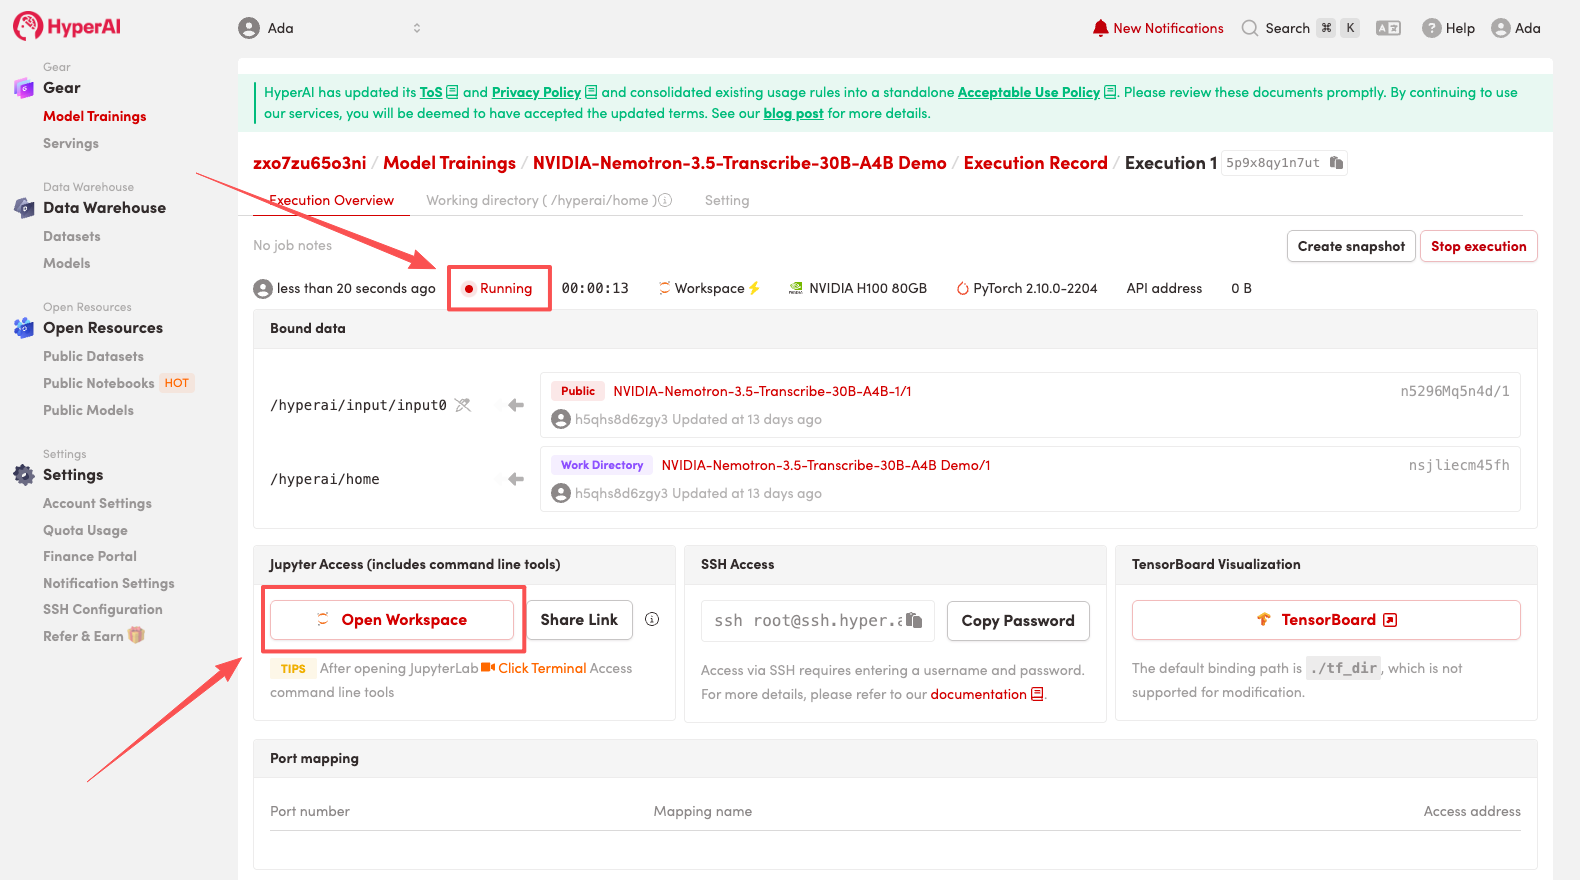
4.等待分配资源,当状态变为「Running(运行中)」后,点击「Open Workspace」进入 Jupyter Workspace。
效果展示
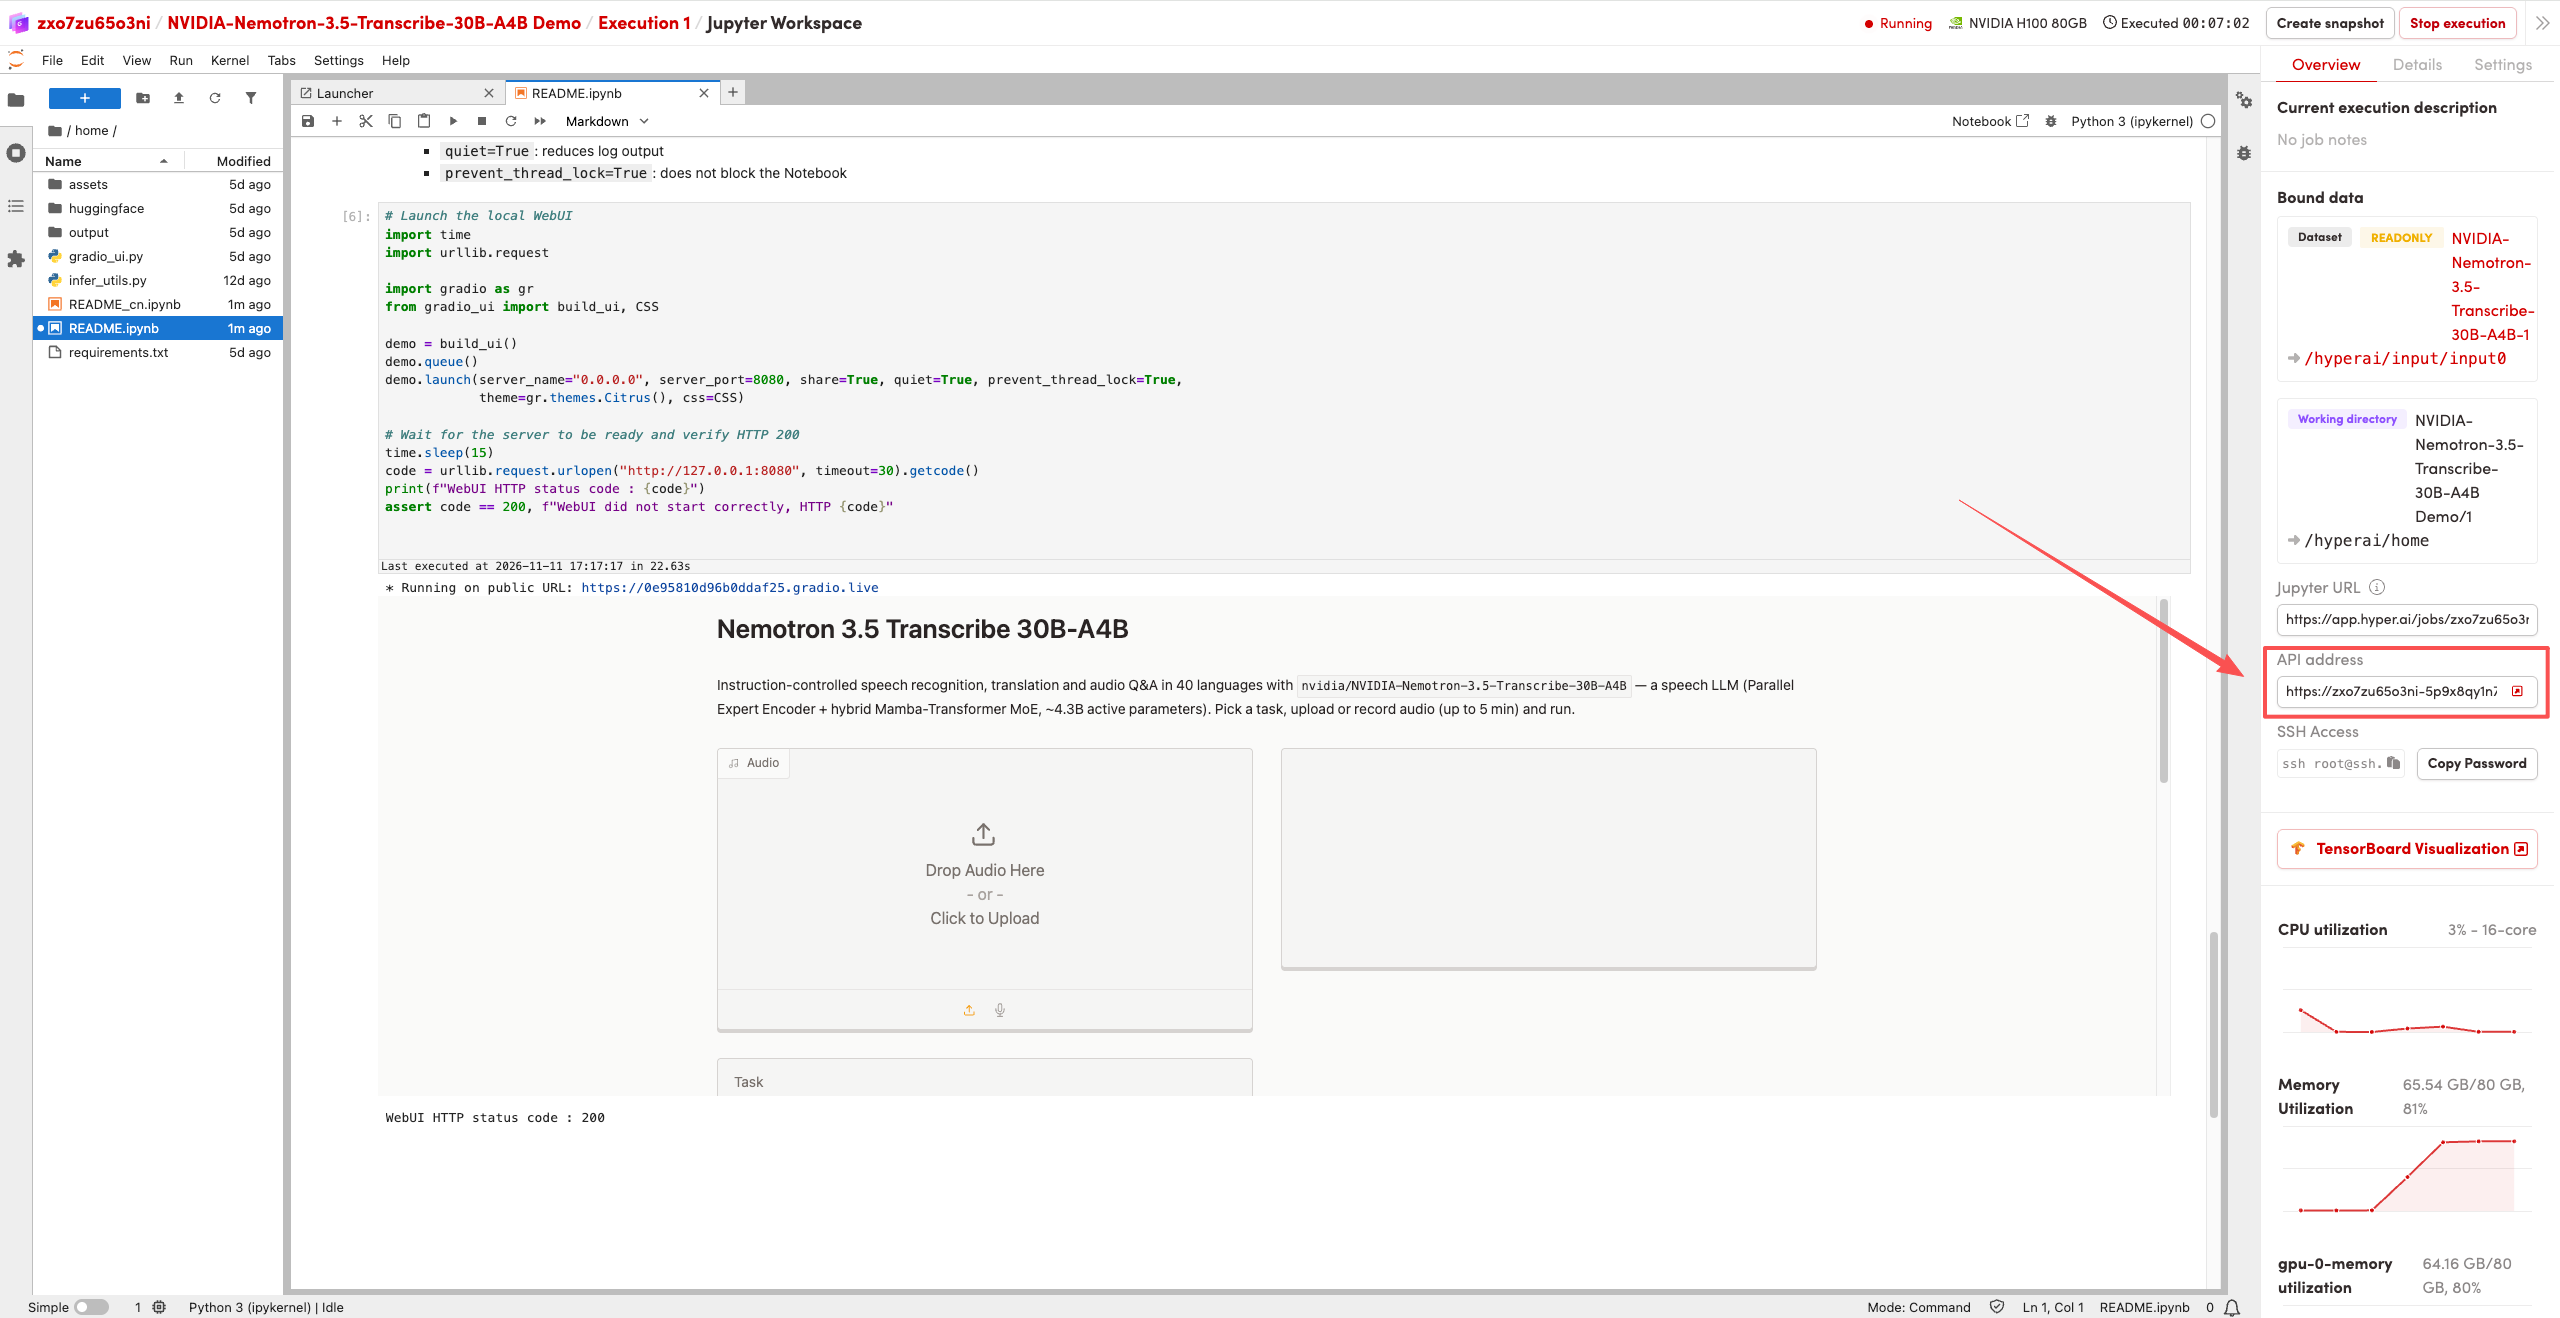
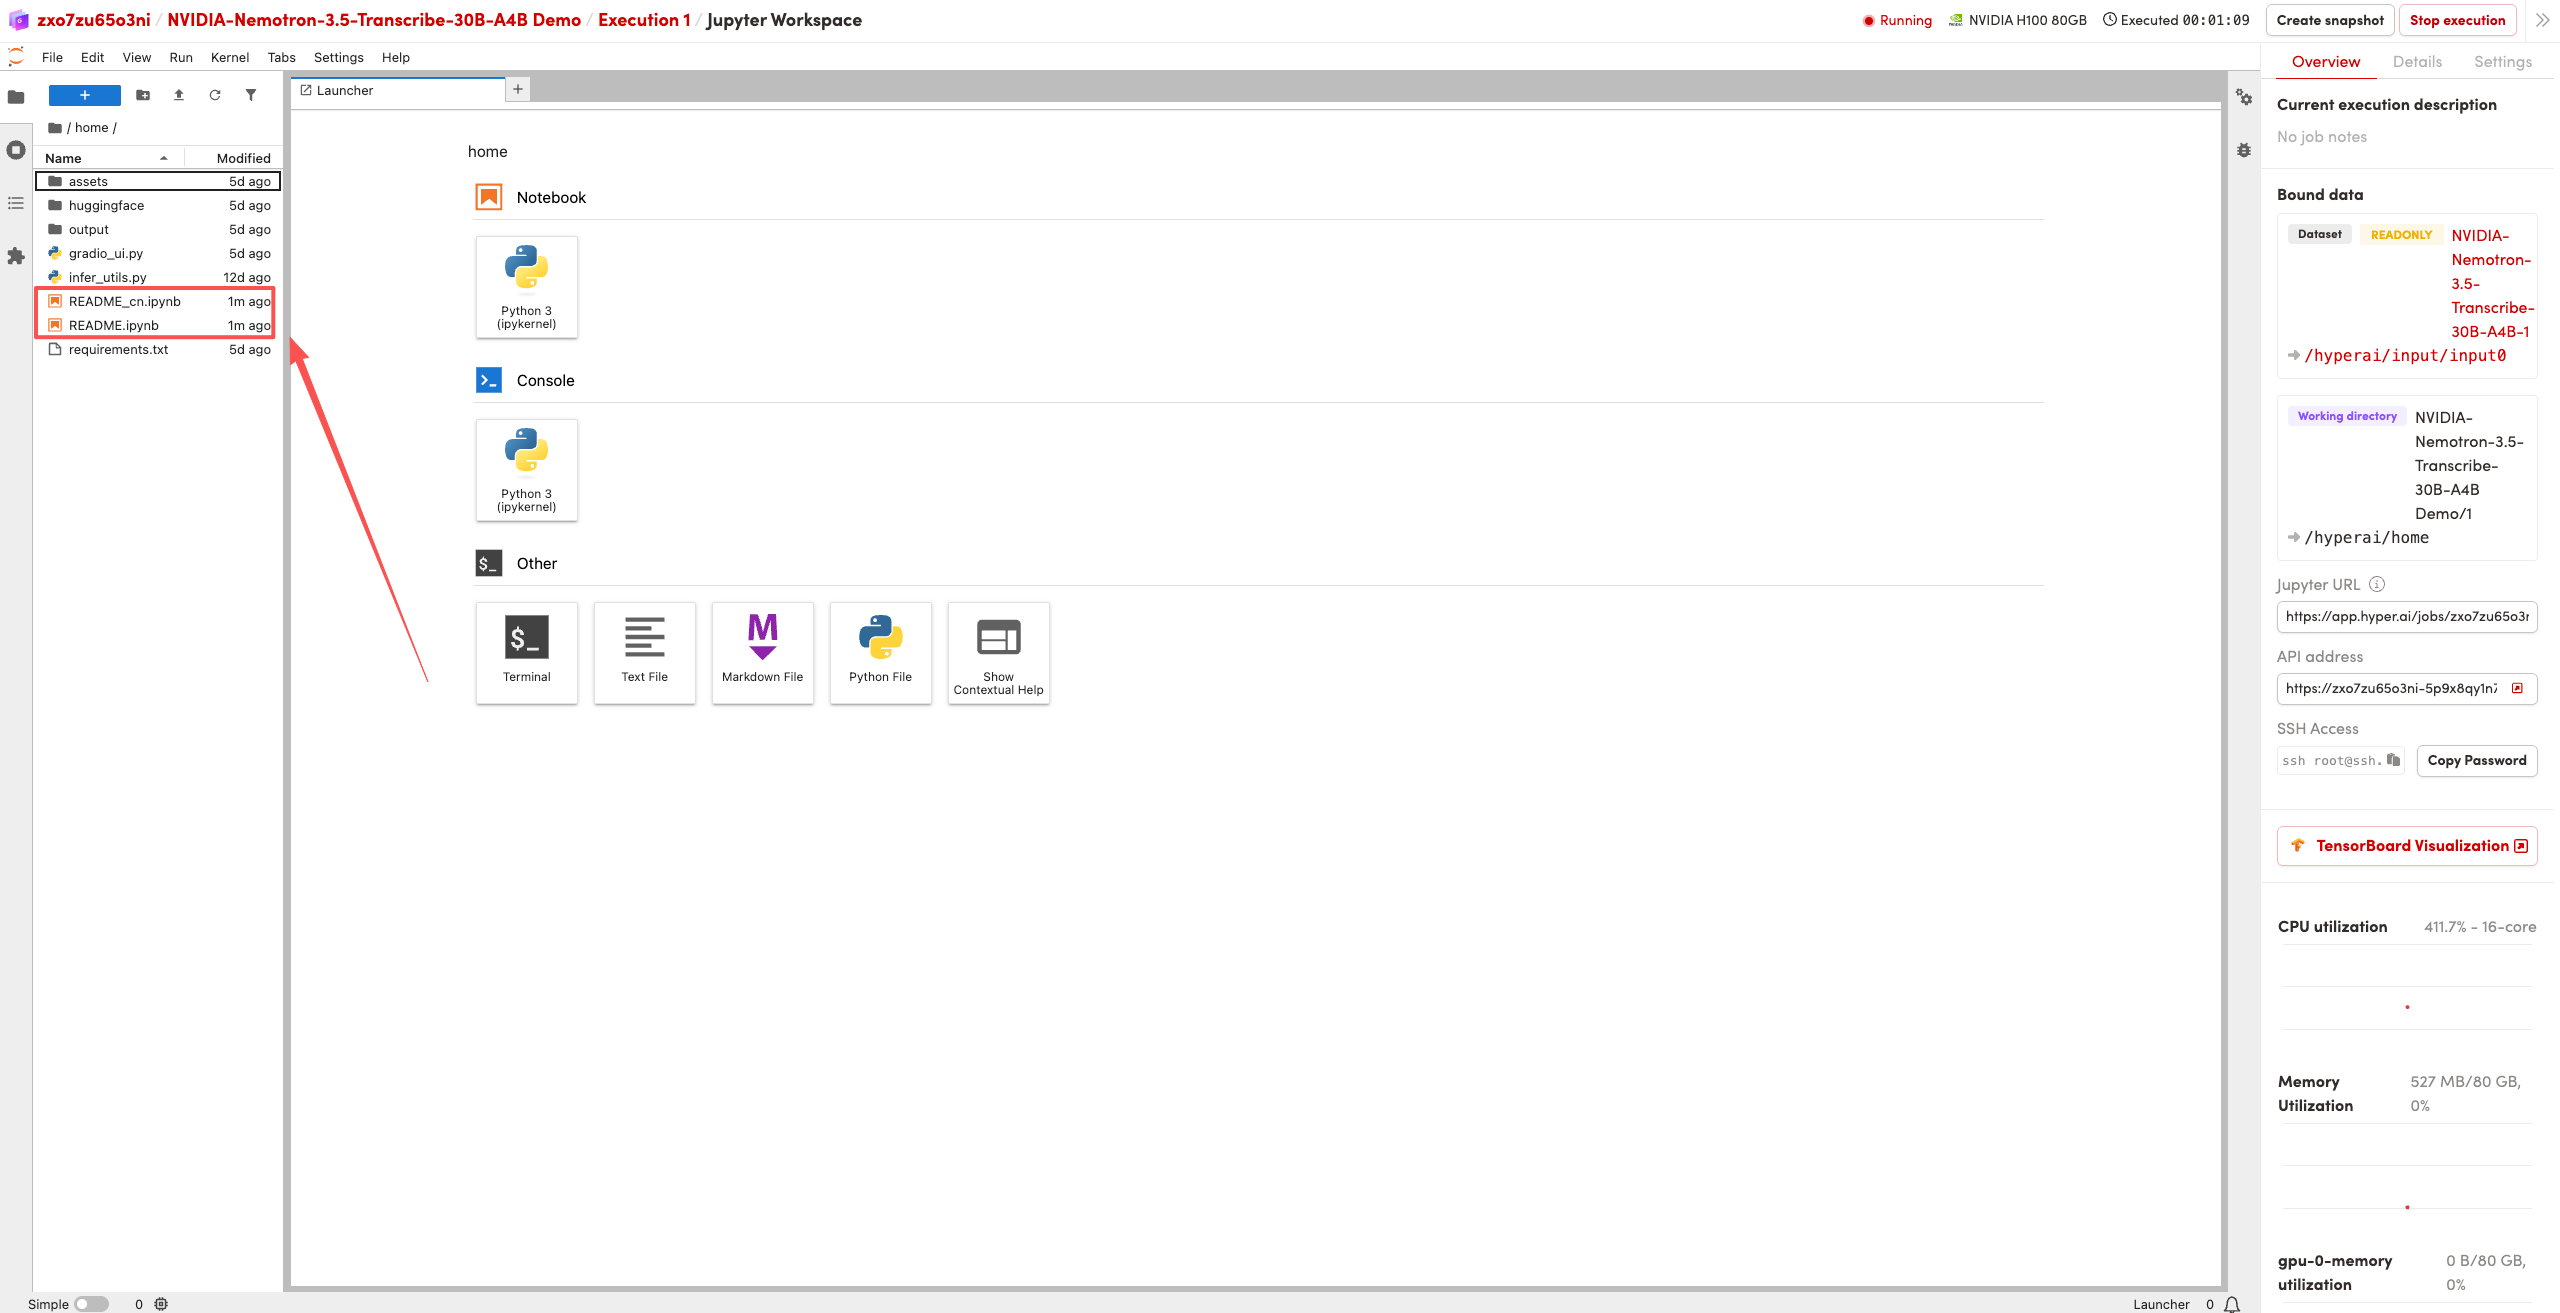
1.页面跳转后,点击左侧 README 文件,进入后点击上方 Run(运行)。
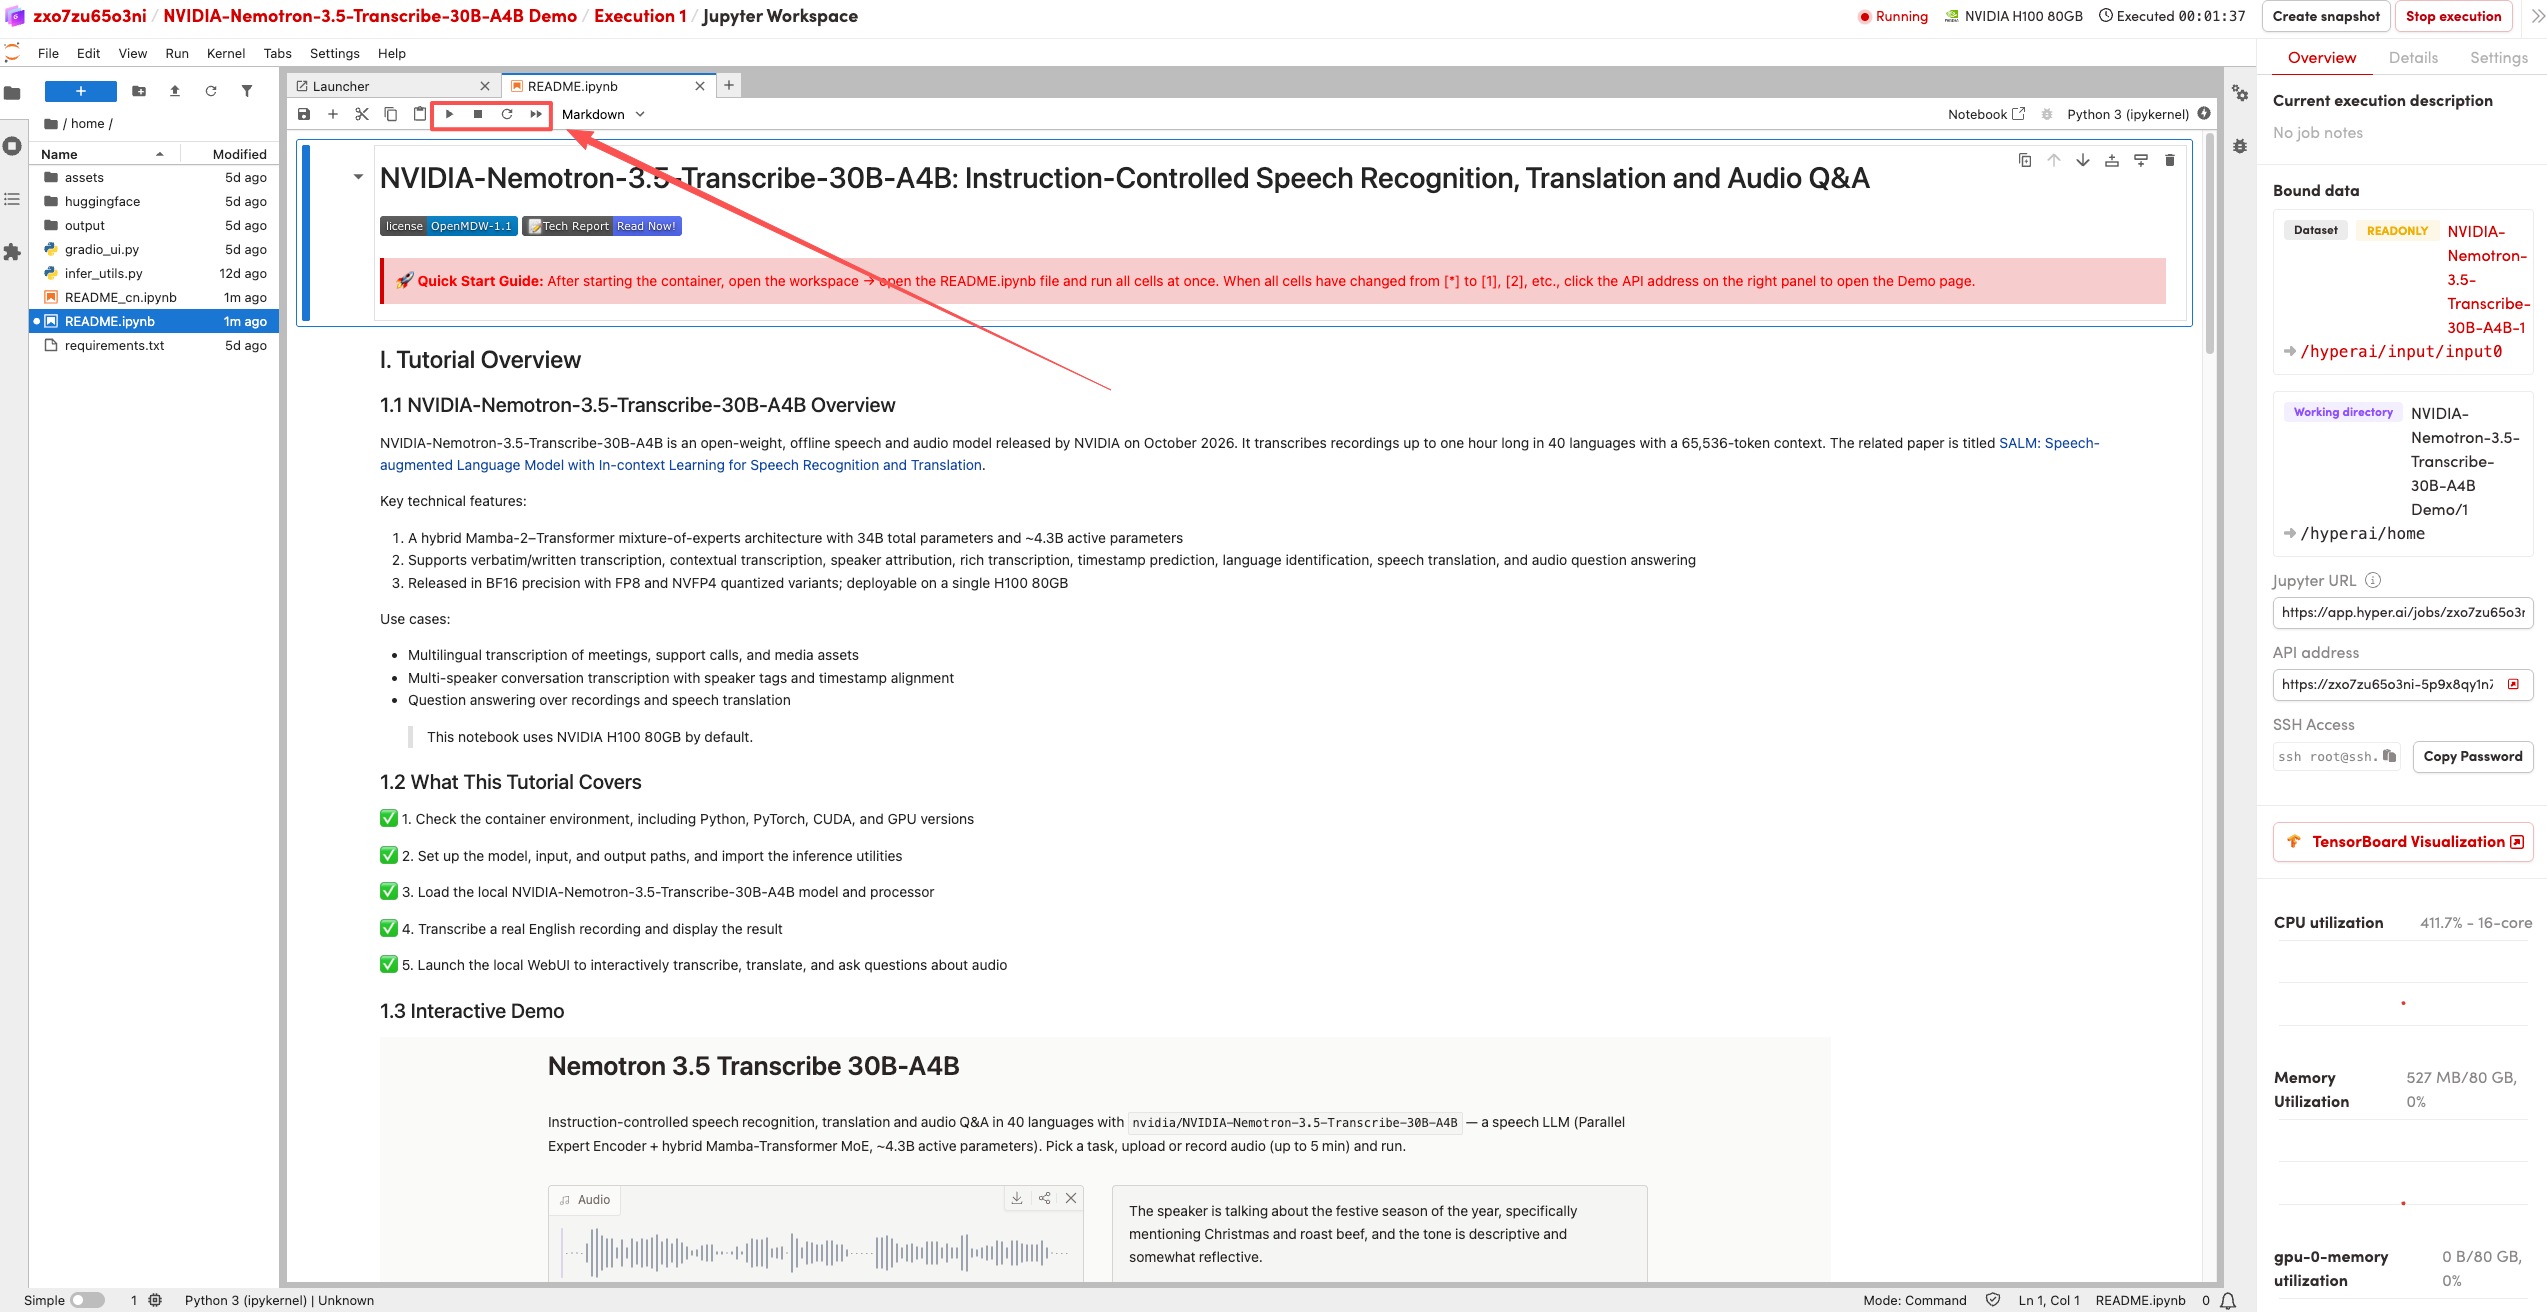
2.待运行完毕后,点击右侧 API 地址即可访问 demo 页面。