Command Palette
Search for a command to run...
شاركت شركة الذكاء الاصطناعي التي تقف وراء "Instant Universe" في تطوير Stable Diffusion وحصلت على تمويل بقيمة 50 مليون دولار العام الماضي.
تم نشر هذه المقالة لأول مرة على الحساب الرسمي لـ HyperAI WeChat~
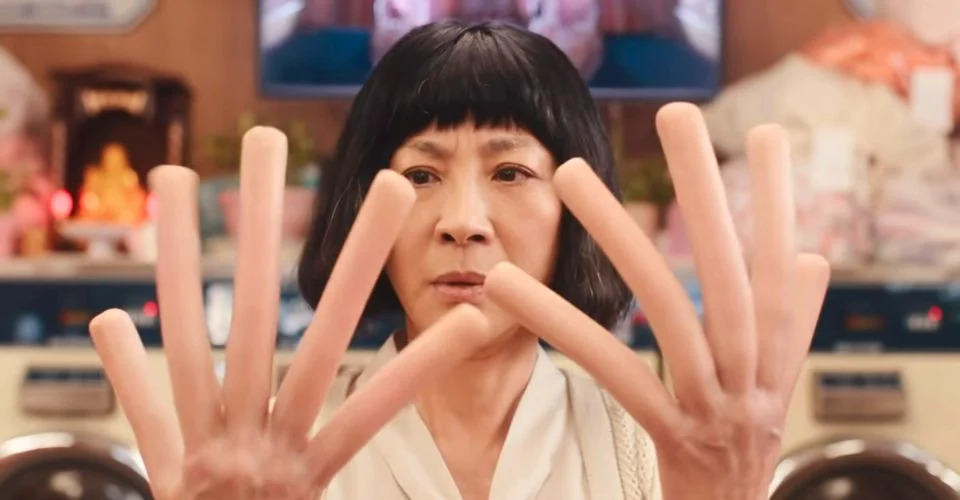
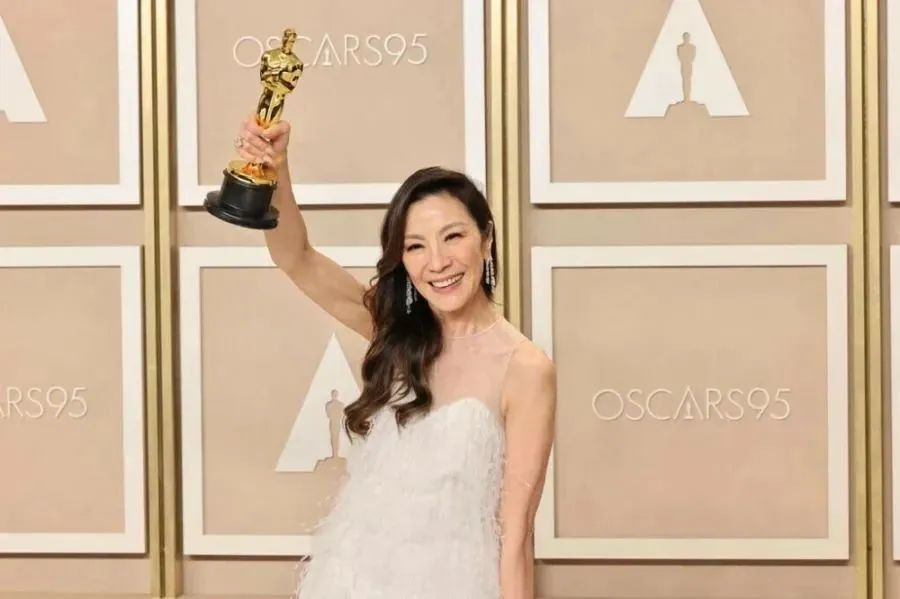
في صباح يوم 13 مارس/آذار بتوقيت بكين، أقيم حفل توزيع جوائز الأوسكار لعام 2023 في لوس أنجلوس.**فاز فيلم "غمضة عين" بسبع جوائز دفعة واحدة، ليصبح الفائز الأكبر.**كما فازت الممثلة الرئيسية ميشيل يوه بجائزة الأوسكار لأفضل ممثلة عن هذا الفيلم، لتصبح أول ممثلة صينية تفوز بهذه الجائزة في تاريخ الأوسكار.
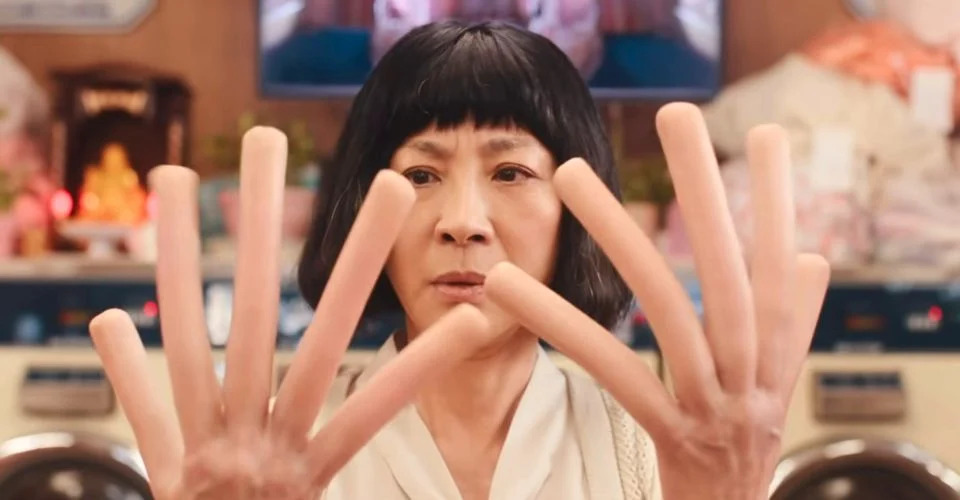
وقال المخرج وكاتب السيناريو إيفان هاليك في مقابلة: "بضع نقرات فقط توفر لي ساعات، يمكنني استغلالها لتجربة ثلاثة أو أربعة تأثيرات مختلفة لتحسين الفيلم".
المدرج: شارك في تطوير الجيل الأول من Stable Diffusion
**في نهاية عام 2018، أسس كريستوبال فالينزويلا وأعضاء آخرون Runway.**هو مزود برامج تحرير الفيديو بالذكاء الاصطناعي ملتزم باستخدام أحدث التطورات في الرسومات الحاسوبية والتعلم الآلي لخفض عتبة إنشاء المحتوى للمصممين والفنانين والمطورين وتعزيز تطوير المحتوى الإبداعي.
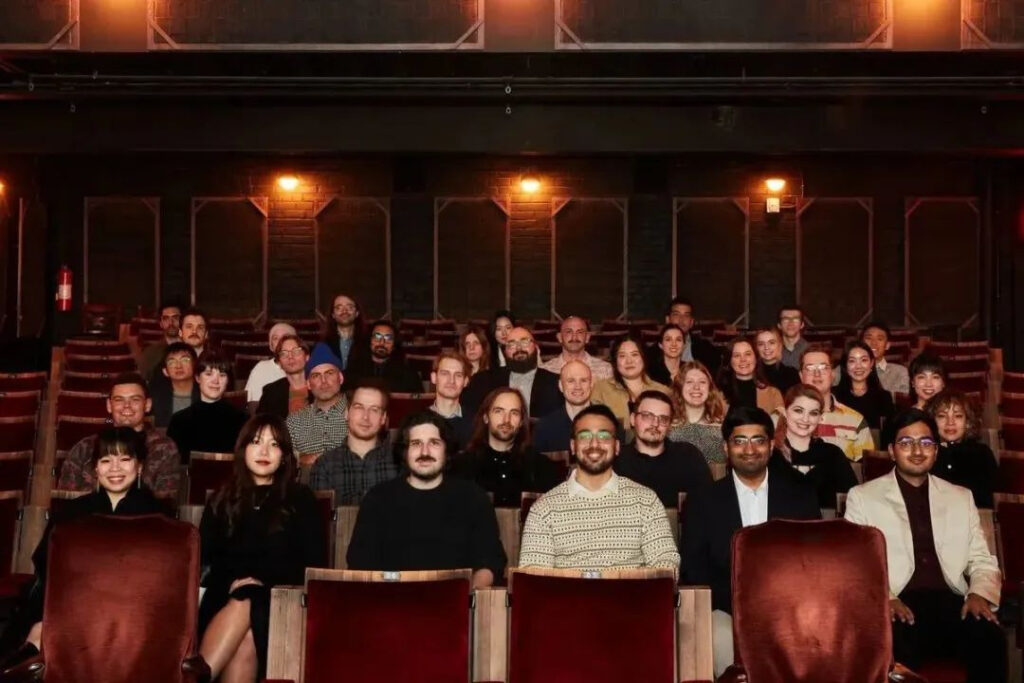
في عام 2021، دخلت Runway في شراكة مع جامعة ميونيخ في ألمانيا لبناء النسخة الأولى من Stable Diffusion. وبعد ذلك، قامت شركة Stability AI البريطانية الناشئة "بجلب رأس المال إلى المجموعة" وزودت Stable Diffusion بمزيد من موارد الحوسبة والأموال اللازمة لتدريب النموذج. ومع ذلك، فإن الذكاء الاصطناعي الخاص بالمدرج والاستقرار لم يعد يتعاون.
في ديسمبر 2022، حصلت Runway على 50 مليون دولار أمريكي في تمويل السلسلة C. بالإضافة إلى فريق "Blink"، يشمل عملاؤها أيضًا مجموعات الوسائط CBS وMBC، وشركات الإعلان Assembly وVaynerMedia، وشركة التصميم Pentagram.
**في 6 فبراير 2023، أصدر الحساب الرسمي لـ Runway على تويتر طراز Gen-1.**بإمكانك تحويل مقطع فيديو موجود إلى مقطع فيديو جديد من خلال تطبيق أي نمط محدد بواسطة الإشارات النصية أو الصور المرجعية.
الجيل الأول: البنية + المحتوى
واقترح الباحثون نموذجًا لنشر الفيديو موجهًا بالبنية والمحتوى - الجيل الأول، والذي يمكنه تحرير مقاطع الفيديو استنادًا إلى الوصف المرئي أو النصي للإخراج المتوقع.
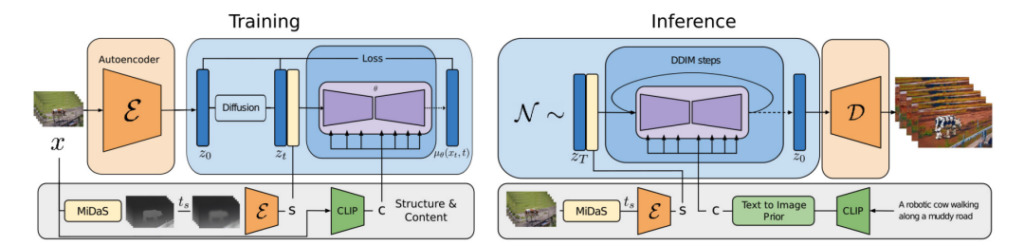
يشير الهيكل إلى وصف خصائصه الهندسية والديناميكية، مثل الشكل والموضع والتغيرات الزمنية للكائن المستهدف.
الهدف من نموذج Gen-1 هو تحرير محتوى الفيديو مع الحفاظ على بنية الفيديو.
خلال عملية تدريب النموذج، استخدم الباحثون مجموعة بيانات واسعة النطاق تتكون من مقاطع فيديو غير مصحوبة بتعليقات توضيحية وأزواج من النصوص والصور. وفي الوقت نفسه، تم استخدام تقديرات عمق المشهد أحادية العين لتمثيل الهيكل، وتم استخدام التضمينات المتوقعة بواسطة شبكة عصبية مدربة مسبقًا لتمثيل المحتوى.
يوفر هذا النهج عدة طرق قوية للتحكم في عملية التوليد:
1. ارجع إلى نموذج تركيب الصورة وقم بتدريب النموذج بحيث يتطابق محتوى الفيديو المستنتج (مثل العرض أو الأسلوب) مع الصورة أو المطالبة التي قدمها المستخدم.
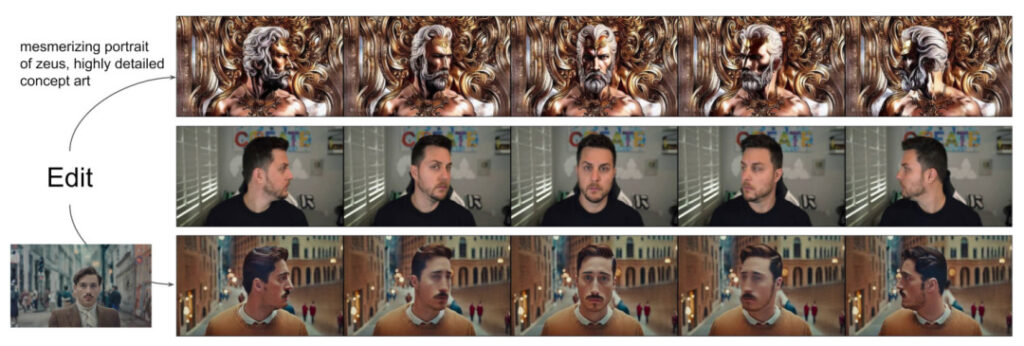
3. ارجع إلى الإرشادات الخالية من التصنيف واستخدم طرق التوجيه المخصصة لضبط عملية الاستدلال للتحكم في الاتساق الزمني للمقاطع المولدة.
في هذه التجربة، قام الباحثون بما يلي:
-
نقوم بتوسيع نموذج الانتشار الكامن إلى توليد الفيديو من خلال إدخال طبقة زمنية في نموذج الصورة المدرب مسبقًا وتدريب الصور ومقاطع الفيديو بشكل مشترك.
-
نقترح نموذجًا يعتمد على البنية والمحتوى ويمكنه تعديل مقاطع الفيديو تحت إشراف صور أو نصوص نموذجية. يتم إجراء تحرير الفيديو بالكامل في مرحلة الاستدلال، دون الحاجة إلى تدريب أو معالجة مسبقة لكل فيديو على حدة.
-
السيطرة الكاملة على الاتساق الزمني والمحتوى والبنية. تظهر التجارب أن التدريب المشترك على بيانات الصور والفيديو يمكن أن يتحكم في الاتساق الزمني أثناء الاستدلال. لتحقيق الاتساق الهيكلي، فإن التدريب على مستويات مختلفة من التفاصيل في التمثيل يسمح للمستخدم باختيار الإعداد المطلوب أثناء الاستدلال.
-
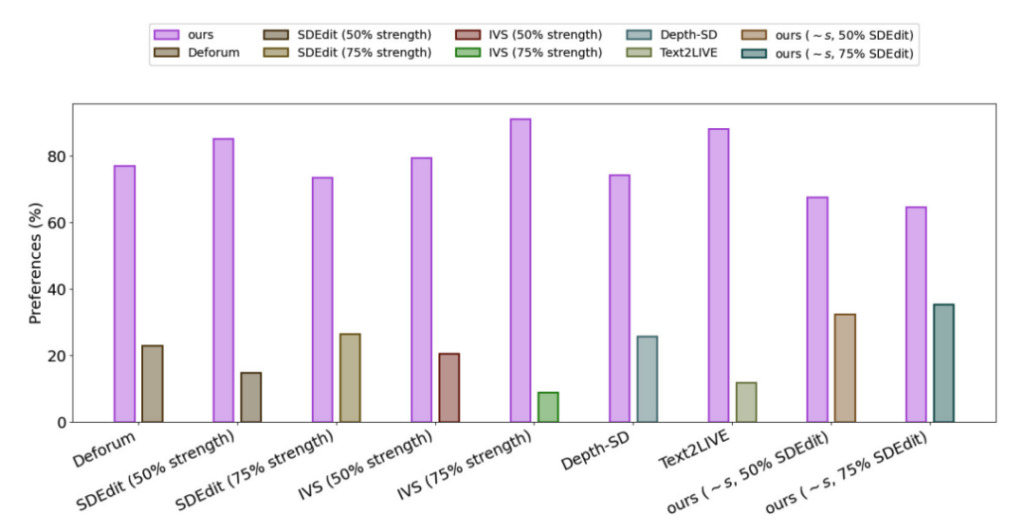
وأظهر استطلاع رأي المستخدمين أن هذه الطريقة كانت أكثر شعبية من العديد من الطرق الأخرى.
-
من خلال الضبط الدقيق لمجموعة فرعية صغيرة من الصور، يمكن تخصيص النموذج المدرب بشكل أكبر لتوليد مقاطع فيديو أكثر دقة لموضوعات محددة.
**لتقييم أداء Gen-1، استخدم الباحثون مقاطع فيديو من مجموعة بيانات DAVIS ومجموعة متنوعة من المواد الأخرى.**لإنشاء مطالبات التحرير تلقائيًا، قام الباحثون أولاً بتشغيل نموذج الترجمة التوضيحية للحصول على وصف لمحتوى الفيديو الأصلي، ثم استخدموا GPT3 لإنشاء مطالبات التحرير.
AIGC: المضي قدمًا وسط الجدل
في عام 2022، أصبحت الذكاء الاصطناعي التوليدي التكنولوجيا الأكثر لفتًا للانتباه منذ ظهور الحوسبة المحمولة والسحابية قبل أكثر من عقد من الزمان، ونحن محظوظون لنشهد ظهور طبقة تطبيقها.تظهر العديد من النماذج الكبيرة بسرعة كبيرة من المختبرات ويتم تطبيقها على سيناريوهات مختلفة في العالم الحقيقي.
ومع ذلك، وعلى الرغم من فوائده العديدة مثل تحسين الكفاءة وتوفير التكاليف، فإننا نحتاج أيضًا إلى إدراك أن الذكاء الاصطناعي التوليدي لا يزال يواجه العديد من التحديات، بما في ذلك كيفية تحسين جودة الناتج وتنوع النموذج، وكيفية زيادة سرعة توليده، بالإضافة إلى القضايا الأمنية والخصوصية والأخلاقية والدينية أثناء عملية التطبيق.
لقد تساءل بعض الناس عن إنشاء الذكاء الاصطناعي للفن، ويعتقد البعض الآخر أنه "غزو" للفن من قبل الذكاء الاصطناعي. في مواجهة هذا الصوت، يعتقد كريستوبال فالينزويلا، المؤسس المشارك والرئيس التنفيذي لشركة Runway، أن الذكاء الاصطناعي هو مجرد أداة في صندوق الأدوات تستخدم لتلوين أو تعديل الصور والمحتوى الآخر، ولا يختلف عن Photoshop أو LightRoom.على الرغم من أن الذكاء الاصطناعي التوليدي لا يزال مثيرًا للجدل، إلا أنه يفتح الباب أمام الإبداع للأشخاص غير التقنيين والأشخاص المبدعين، وسوف يقود مجال إنشاء المحتوى إلى إمكانيات جديدة.
روابط مرجعية: