Command Palette
Search for a command to run...
DeepMind が一般的な強化学習アルゴリズムである DreamerV3 をリリースし、AI が自らダイヤモンドを選ぶことを学習できるようになりました
Minecraft をプレイするのは人間だけではありません。有名な AI テクノロジー企業 DeepMind も、Minecraft をプレイするための専用 AI を開発しました。
内容の概要:強化学習の本質は、自動意思決定を実現し、継続的な意思決定を行うことです。この記事では、DeepMind の最新の研究開発成果、強化学習の適用範囲を拡大する汎用アルゴリズム DreamerV3 について紹介します。 キーワード:強化学習 DeepMind 一般アルゴリズム
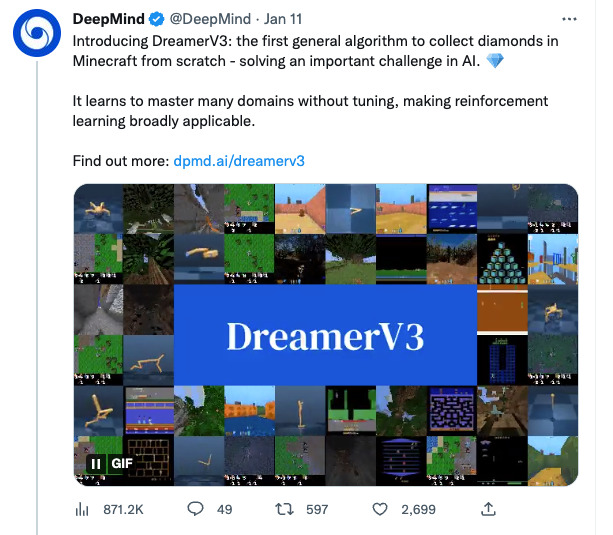
北京時間1月12日、DeepMindの公式ツイッターは次のように投稿した。DreamerV3が正式発表されましたが、これは、人間のデータを参照せずにゲーム「Minecraft」内でダイヤモンドをゼロから収集できる初の一般的なアルゴリズムであり、AI 分野におけるもう 1 つの重要な課題を解決します。

強化学習の拡張が課題、開発には汎用アルゴリズムが必要
強化学習により、コンピュータは対話を通じて特定のタスクを解決できます。たとえば、AlphaGo は囲碁ゲームで人間を破り、OpenAI Five は Dota 2 でアマチュアの人間のプレイヤーを破りました。
これには、アルゴリズムを微調整するためのかなりの専門知識とコンピューティング リソースが必要です。これはモデルの拡張を大きく妨げます。チューニングなしで新しい領域を学習して習得できる一般的なアルゴリズムを作成することは、強化学習の適用範囲を拡大し、意思決定の問題を解決するための重要な方法となっています。
その結果、DeepMind とトロント大学が共同開発した DreamerV3 が誕生しました。
DreamerV3: ワールドモデルに基づくユニバーサルアルゴリズム
DreamerV3 は、ワールド モデルに基づいた一般的でスケーラブルなアルゴリズムです。固定ハイパーパラメータを前提として幅広い領域に適用でき、特殊なアルゴリズムよりも優れています。
これらのドメインには、連続アクションと離散アクション、視覚入力と低次元入力、2D 世界と 3D 世界、さまざまなデータ予算、報酬頻度と報酬スケールなどが含まれます。

1.世界モデル:潜在的なアクションの将来の結果を予測する
2. 批評家:それぞれの状況の価値を判断する
3.俳優: 貴重な状況を可能にする方法を学びましょう

俳優と批評家は、世界モデルによって予測される抽象表現の軌跡から学びます。
クロスドメインのタスクにうまく適応するために、これらのコンポーネントは、さまざまな信号の大きさに適応し、ターゲット内の項のバランスを確実にとる必要があります。
エンジニアは、150 を超える固定パラメーターを使用したタスクで DreamerV3 をテストし、文献に記録されている最良の方法と比較しました。実験の結果、DreamerV3 はさまざまなドメインのタスクに対して高い汎用性と拡張性を備えていることがわかりました。
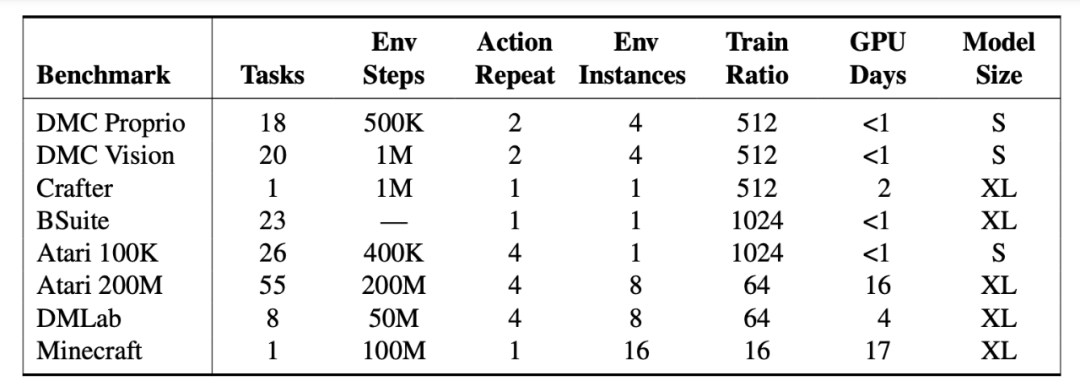
ただし、DreamerV3 には依然として一定の制限があります。たとえば、環境ステップが 1 億以内の場合、アルゴリズムは人間のプレイヤーのようにすべてのシナリオでダイヤモンドを拾うことはできませんが、ごくたまにしか拾えません。
巨人の肩の上に立って、ドリーマーファミリーの発展の歴史を振り返りましょう
世代: ドリーマー
発売時期:2019年12月
参加機関:トロント大学、DeepMind、Google Brain
**用紙のアドレス:**https://arxiv.org/pdf/1912\.01603\.pdf
アルゴリズムの紹介:
Dreamer は、潜在的な想像力だけを使用して、画像から長期的なタスクを解決できる強化学習エージェントです。
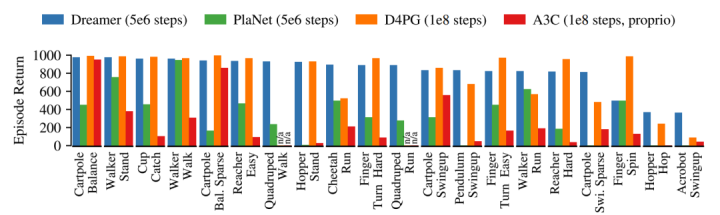
これは、ワールド モデルを使用して効率的な行動学習を達成するためのモデル予測の逆伝播に基づいています。 Dreamer は、20 の困難な視覚制御タスクにわたって、データ効率、計算時間、最終パフォーマンスの点で当時の主流の手法を上回りました。
第二世代:DreamerV2
発売時期:2020年10月
**参加機関:**Google Research、DeepMind、トロント大学
**用紙のアドレス:**https://arxiv.org/pdf/2010\.02193\.pdf
アルゴリズムの紹介:
DreamerV2 は、ワールド モデルのコンパクトな潜在空間内の予測から動作を学習できる強化学習エージェントです。
注: このワールド モデルは離散表現を使用し、ポリシーとは別にトレーニングされます。
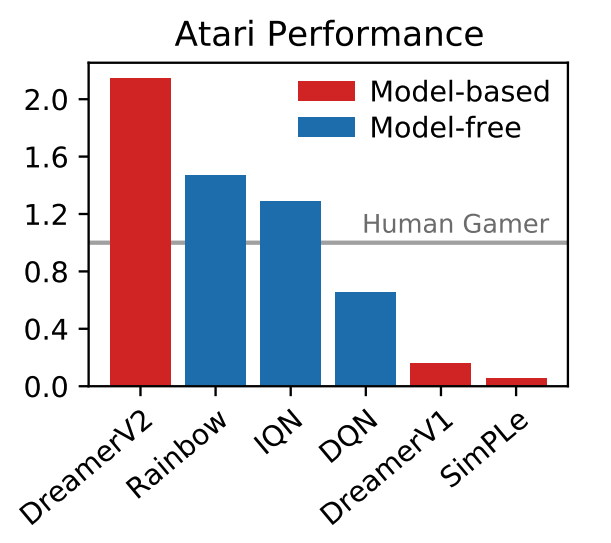
DreamerV2 は、個別にトレーニングされたワールド モデルで動作を学習することにより、Atari ベンチマークの 55 のタスクで人間レベルのパフォーマンスを達成した最初のエージェントです。同じコンピューティング予算と実時間の下で、DreamerV2 は 2 億フレームに達し、トップのシングル GPU エージェント IQN と Rainbow の最終パフォーマンスを上回りました。
さらに、DreamerV2 は、複雑なヒューマノイド ロボットの世界モデルを学習し、ピクセル入力のみで立ったり歩いたりする問題を解決します。
Twitter ネチズンは率先してコメント セクションでミームを作成しました
DreamerV3 の誕生に関しては、DeepMind の Twitter メッセージ領域でも多くのネチズンが警戒を強めました。


近年、ゲーム「Minecraft」が強化学習の研究の焦点となっており、「Minecraft」におけるダイヤモンド収集を巡る国際大会が数多く開催されています。
人間のデータを使用せずにこの課題を解決することは、人工知能のマイルストーンであると広く考えられています。この手続き的に生成されたオープンワールド環境では、報酬が少なく、探索が難しく、時間が長いため、これらの障害が存在するため、以前の方法は人間のデータやチュートリアルに基づく必要がありました。
DreamerV3 は、「Minecraft」でダイヤモンドを収集する方法をゼロから完全に学習する最初のアルゴリズムです。強化学習の適用範囲をさらに拡大し、ネチズンが言っているように、DreamerV3 はすでに成熟した汎用アルゴリズムです。自分でモンスターと戦うために電話を切ってアップグレードする方法を学び、究極のボスであるエンダー ドラゴンに立ち向かう時が来ました。
HyperAI に従って、より興味深い AI アルゴリズムとアプリケーションを学び、一緒に学び、進歩するための定期的に更新されるチュートリアルもあります。