Command Palette
Search for a command to run...
Comment Rendre La Mémoire Des Robots Plus Fiable Sous Un Budget De Requêtes Limité ? MIT Propose UQ-DAAAM Pour Introduire L’évaluation De L’incertitude Dans La Mémoire spatio-temporelle
À mesure que les robots passent progressivement de tâches courtes et uniques à une manipulation autonome à long horizon dans des environnements ouverts, ils doivent établir une mémoire à long terme capable de conserver les objets et leurs relations spatiales à travers le temps et les points de vue, afin de soutenir des tâches telles que la navigation, la recherche d’objets et les questions-réponses spatio-temporelles.
Ces dernières années, les descriptions de scènes basées sur les modèles vision-langage (VLM) ont ouvert une nouvelle voie pour la construction de mémoires sémantiques par les robots, mais les sorties des VLM sont souvent bruitées et peuvent présenter des incohérences sémantiques selon les points de vue d’observation — lorsque les objets sont éloignés, masqués par l’angle de vue, ou placés dans des environnements à éclairage complexe, un VLM peut générer un texte qui semble très confiant mais décrit en réalité incorrectement les attributs des objets. Prenons l’exemple d’un système de mémoire tel que DAAAM : si le point de vue choisi est justement de mauvaise qualité, l’entrée de mémoire finalement formée peut contenir des informations erronées, sans que le système puisse le détecter.
Face à ce défi, une équipe de recherche du MIT a introduit un score d’incertitude dans un système avancé de mémoire sémantique spatiale, et l’a nommé UQ-DAAAM. Sous la contrainte d’un budget de requêtes fixe, UQ-DAAAM utilise ce score pour optimiser activement les objets présentant une incertitude élevée : en sélectionnant des points de vue de haute qualité pour obtenir de nouvelles descriptions, puis en fusionnant les descriptions générées à partir de plusieurs points de vue afin de former une description unifiée de l’objet. Les résultats expérimentaux montrent que la quantification de l’incertitude améliore la fiabilité et l’efficacité des systèmes de mémoire 4D pour l’intelligence incarnée. Sur le benchmark OC-NaVQA, par rapport aux méthodes de base, UQ-DAAAM réduit significativement l’incertitude et obtient de meilleures performances en questions-réponses spatio-temporelles.
Les travaux de recherche associés, intitulés « Remember with Confidence: Uncertainty Quantification for Spatio-temporal Memory with Probabilistic Guarantees », seront publiés à NeurIPS.
Points forts de la recherche :
- Proposition d’une méthode de score d’incertitude au niveau des objets : établir une métrique d’incertitude sémantique au niveau des objets pour les descriptions d’images multi-points de vue
- Proposition d’une stratégie d’optimisation active et de fusion sous contrainte de budget : lorsque le budget de requêtes VLM supplémentaires est limité, optimiser en priorité les objets à incertitude élevée et fusionner les descriptions issues de plusieurs points de vue.
- Fournir des garanties probabilistes pour la stratégie de sélection des points de vue : établir théoriquement le lien entre la méthode d’évaluation de la qualité des points de vue de DAAAM et la réduction de l’incertitude en une étape, et dériver la formule de mise à jour en forme fermée correspondante
Lien de l’article :
https://arxiv.org/pdf/2606.08277
Prétraitement des données, reconstruction de scène, segmentation et suivi
Jeu de données et prétraitement
Les chercheurs ont évalué les performances de UQ-DAAAM sur la tâche de questions-réponses spatio-temporelles sur le jeu de données de conduite en extérieur CODa. Ce jeu de données fournit des images stéréo à 30 Hz, des cartes de profondeur générées par projection LiDAR, ainsi que des informations de pose globalement cohérentes.
Toutes les expériences utilisent les images capturées par la caméra frontale (cam0), avec un recadrage central et un redimensionnement des images, pour une résolution finale de 480×640 pixels. Les données de profondeur proviennent de la projection LiDAR d’estimations 3D brutes et sont filtrées, en ne conservant que les données dont la profondeur est comprise dans l’intervalle [0.05, 20.0] mètres. Les images vidéo sont traitées à une fréquence de 10 Hz, cohérente avec la fréquence de publication des données des capteurs.
Reconstruction de scène
Les chercheurs utilisent Khronos pour la construction en temps réel de graphes de scène 3D. La taille de voxel du TSDF (champ de distance signée tronqué) est fixée à 0,2 mètre, et la distance de troncature à 0,6 mètre.
Les paramètres d’extraction des fragments d’objets (Object Fragments) sont les suivants : volume minimal de 0,005 mètre cube, volume maximal de 50 mètres cubes ; chaque fragment d’objet doit recevoir au moins 8 observations, et la confiance d’attribution ne doit pas être inférieure à 0,5.
La largeur des zones praticables (Traversability Places) est définie entre 0,4 et 2,0 mètres, et la projection des étiquettes sur le plan du sol est activée.
Segmentation et suivi
Les chercheurs utilisent FastSAM pour la segmentation d’instances en vocabulaire ouvert et le compilent en moteur TensorRT, avec une résolution d’image d’entrée de 480×640 pixels et une aire minimale des masques de segmentation fixée à 400 pixels.
Le suivi d’objets utilise ByteTrack, et la correspondance des caractéristiques d’apparence est réalisée par un modèle de réidentification d’apparence (ReID) basé sur CLIP, lui aussi déployé sur un moteur TensorRT. Concernant les paramètres de suivi, le seuil de confiance des nouvelles trajectoires (new track) est fixé à 0,6, et la longueur du tampon de trajectoire (track buffer) est fixée à 30 images. Une trajectoire d’objet doit accumuler au moins 8 observations avant de passer à l’étape d’annotation sémantique.
Cadre UQ-DAAAM : de l’identification de l’incertitude à l’observation active et à la fusion sémantique
Les recherches de cet article s’appuient sur DAAAM, qui peut construire en temps réel des graphes de scène 4D à partir de flux de données RGB-D. La figure ci-dessous présente le cadre global de UQ-DAAAM ; le processus de construction comprend trois étapes principales : la quantification de l’incertitude, la sélection active des points de vue et l’agrégation des descriptions multi-points de vue :
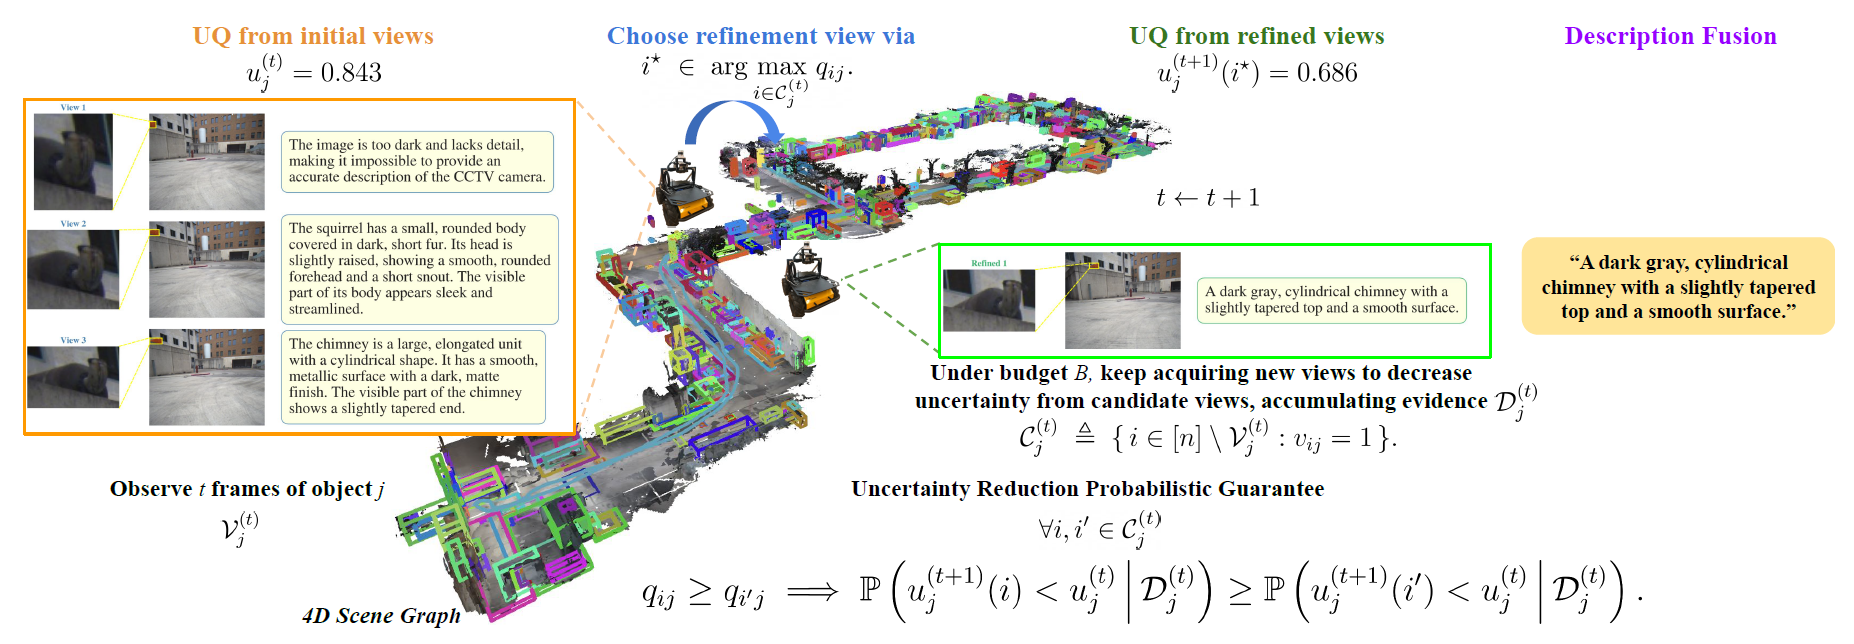
① Quantification de l’incertitude (Uncertainty Quantification)
Afin de quantifier l’incertitude sémantique centrée sur les objets, les chercheurs ont introduit la méthode de mesure sémantique volumétrique (Volumetric Semantic Measurement) dans le scénario de construction de mémoire robotique multi-angles de DAAAM.
Dans le scénario étudié, chaque objet est observé depuis plusieurs points de vue sélectionnés, et un VLM génère une description en langage naturel pour chaque point de vue. Lorsque les descriptions générées depuis différents points de vue présentent des incohérences sémantiques, ou lorsqu’une description individuelle manque de cohérence interne, l’incertitude du système doit augmenter en conséquence. Par conséquent, la méthode de calcul de cette étude prend en compte deux aspects : la dispersion sémantique inter-angles (Cross-view Semantic Scatter) et l’incohérence par point de vue (Per-view Incoherence).
Plus les descriptions issues de différents points de vue divergent dans leur direction sémantique, ou plus une description individuelle est incohérente, plus l’incertitude calculée est généralement élevée. Ainsi, le système ne se repose plus uniquement sur le niveau de confiance d’une description, mais examine de manière intégrée la cohérence entre les informations multi-angles ainsi que la fiabilité propre à chaque description.
① Sélection active des points de vue (Active View Selection)
Après l’évaluation initiale de l’incertitude, le système compare l’incertitude au niveau de l’objet avec un seuil prédéfini. Lorsque l’incertitude d’un objet dépasse le seuil, cela signifie que l’interprétation sémantique présente dans la mémoire actuelle comporte encore une forte ambiguïté et qu’il est nécessaire d’obtenir des preuves d’observation supplémentaires. À ce moment, le système ne répartit pas uniformément le budget de requêtes supplémentaires entre tous les objets, mais traite en priorité les objets à incertitude élevée.
Théoriquement, la sélection de points de vue supplémentaires peut être modélisée comme un problème de conception expérimentale bayésienne optimale (BOED) : chaque point de vue candidat correspond à une expérience, l’état sémantique latent de l’objet est la variable à inférer, et la description générée par le modèle vision-langage depuis le nouveau point de vue constitue le résultat de l’expérience. Idéalement, le système devrait choisir le point de vue capable de réduire au maximum l’incertitude attendue.
② Agrégation des descriptions multi-angles (Multi-view Descriptions Aggregation)
Après la sélection des points de vue basée sur l’incertitude, chaque objet est associé à un ensemble de descriptions textuelles provenant de différents points de vue. Les chercheurs fusionnent ces descriptions en une description unifiée de l’objet grâce à une étape d’agrégation contrainte, basée sur un grand modèle de langage (LLM). Plus précisément, le système ordonne les descriptions selon la phase d’acquisition : les descriptions générées depuis les points de vue initiaux sont placées en premier, et celles obtenues lors de la phase d’optimisation active sont placées ensuite. Lors de la résolution des conflits entre différentes descriptions, le LLM est incité à privilégier les descriptions obtenues ultérieurement (c’est-à-dire les descriptions générées pendant la phase d’optimisation).
Si les divergences n’existent qu’entre les descriptions des points de vue initiaux, la description fusionnée adopte un langage prudent qui préserve différentes possibilités, plutôt que d’éliminer prématurément l’ambiguïté. De plus, l’étude impose des contraintes supplémentaires au LLM : le résultat de la fusion ne peut utiliser que des informations déjà présentes dans au moins une description source, afin d’empêcher le modèle de générer des informations hallucinées.
##UQ-DAAAM permet d’obtenir de meilleures performances en question-réponse spatio-temporelle
L’étude évalue UQ-DAAAM sous plusieurs aspects : les performances en question-réponse spatio-temporelle en aval, la réduction de l’incertitude, l’ablation des modules et l’efficacité opérationnelle.
③ Évaluation de la tâche OC-NaVQA
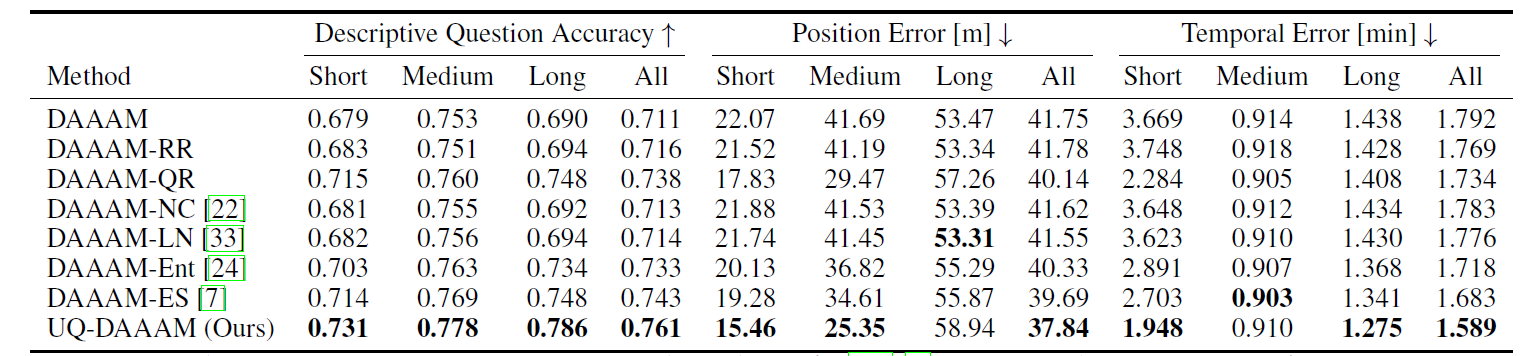
Dans la tâche OC-NaVQA, l’étude compare UQ-DAAAM à DAAAM original ainsi qu’à plusieurs méthodes de référence pour l’optimisation active et la quantification de l’incertitude. DAAAM-RR répartit aléatoirement le budget de requêtes de points de vue supplémentaires ; DAAAM-QR alloue le budget aux objets de plus faible qualité en se fondant sur les scores de qualité des points de vue initiaux ; en outre, des méthodes construites à partir de différents signaux d’incertitude, tels que la cohérence de voisinage, la log-vraisemblance du token suivant, l’entropie et le score de preuve, ont également été comparées.
Les résultats du tableau ci-dessous montrent que UQ-DAAAM surpasse les autres méthodes de référence sur les trois métriques d’évaluation, avec les améliorations les plus marquées en précision de question et en erreur de localisation. Cela indique que l’optimisation active consciente de l’incertitude permet d’allouer plus efficacement un budget fixe de requêtes sémantiques, améliorant ainsi la qualité de la mémoire.
④ Évaluation de la réduction de l’incertitude (Uncertainty Reduction)
Outre les performances sur les tâches en aval, l’étude évalue directement si l’optimisation active atteint son objectif immédiat, à savoir réduire l’incertitude sémantique au niveau des objets. La métrique d’évaluation principale utilisée est le taux de réduction de l’incertitude (URR), défini comme la proportion d’objets considérés comme incertains lors de la phase initiale et dont l’incertitude est passée sous le seuil après l’optimisation active, par rapport au nombre total d’objets initialement incertains.
Les résultats de réduction de l’incertitude dans la figure ci-dessous montrent que UQ-DAAAM présente un avantage net par rapport aux deux méthodes de référence d’optimisation active non fondées sur l’incertitude. Lorsque le budget d’optimisation active est fixé à (B=2), l’URR de UQ-DAAAM atteint 92,3 % ; la méthode d’optimisation basée sur la qualité des points de vue (DAAAM-QR) obtient 34,2 %, et la méthode d’optimisation aléatoire (DAAAM-RR) seulement 5,6 %. De plus, UQ-DAAAM déplace nettement la distribution de l’incertitude après optimisation active vers la gauche, ce qui indique que la méthode parvient à réaliser une réduction de l’incertitude plus importante et plus stable sur un plus grand nombre d’objets.
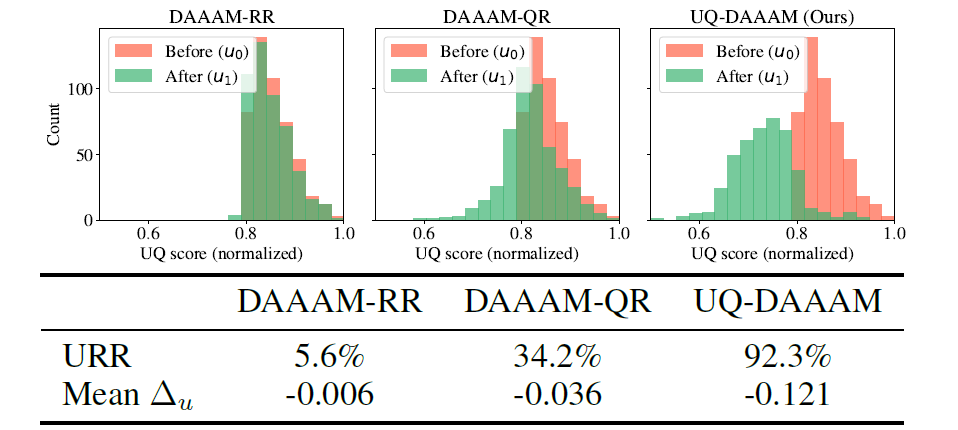
Ces résultats montrent que la méthode d’optimisation active consciente de l’incertitude proposée dans cet article offre une efficacité d’optimisation nettement supérieure.
③ Expériences d'ablation (Ablations)
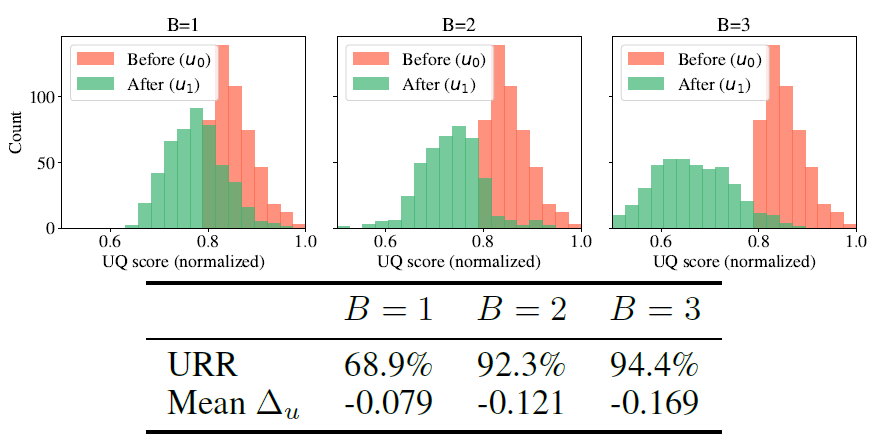
Les recherches ont également décomposé les sources de performance d'UQ-DAAAM grâce à plusieurs séries d'expériences d'ablation : Premièrement, à mesure que le budget d'optimisation supplémentaire par objet augmente de (B=1) à (B=3), la réduction de l'incertitude s'améliore continuellement, mais les gains marginaux diminuent progressivement. Comme le montre la figure ci-dessous, la majeure partie des gains est déjà atteinte à (B=2) ; les performances de la tâche en aval OC-NaVQA présentent la même tendance, ce qui indique que quelques points de vue supplémentaires suffisent généralement à résoudre les ambiguïtés sémantiques de la plupart des objets.
Deuxièmement, concernant le choix des objets à optimiser, la métrique d'incertitude complète est supérieure aux approches utilisant uniquement la dispersion des descriptions entre points de vue ou ne tenant pas compte du poids de l'incohérence mono-vue, ce qui montre que prendre en compte à la fois les divergences sémantiques entre points de vue et la qualité de chaque description permet une évaluation plus efficace de l'incertitude. Concernant la sélection des points de vue d'optimisation, une sélection aléatoire dégrade nettement les performances du système ; la stratégie basée sur la direction d'observation des objets est proche de celle basée sur la notation de la qualité des points de vue, tandis que la notation pondérée par la qualité permet de filtrer davantage les points de vue candidats.
Les expériences de fusion des descriptions multi-angles montrent que la stratégie de fusion influence également la qualité finale de la mémoire. Par rapport à l'utilisation d'une seule meilleure description, à la fusion uniquement des descriptions initiales ou des descriptions de la phase d'optimisation, ainsi qu'à une fusion LLM ordinaire sans règle de résolution des conflits, la méthode de fusion contrainte et sensible aux phases proposée par l'article obtient les meilleurs résultats. Cela signifie que l'obtention active d'observations supplémentaires n'est pas suffisante en soi : la manière de distinguer les informations des différentes phases et de gérer les descriptions contradictoires détermine également si les nouvelles preuves peuvent être effectivement converties en une mémoire fiable.
Concernant le seuil d'optimisation active, les expériences comparent des configurations correspondant à différents quantiles de la distribution d'incertitude au niveau des objets. Les résultats montrent que lorsque le seuil passe du 10e au 20e percentile, les performances s'améliorent nettement ; un ajustement supplémentaire au 30e percentile apporte encore des améliorations, tandis que le 40e percentile n'offre plus que des gains marginaux limités. Les chercheurs en concluent que le seuil par défaut atteint un bon équilibre entre le coût des requêtes sémantiques et les gains pour les tâches en aval.
Conclusion
UQ-DAAAM propose une approche sensible à l'incertitude pour la mémoire spatio-temporelle à long terme des robots : le système ne considère plus directement comme des faits fiables les descriptions générées par les modèles vision-langage, mais identifie les ambiguïtés potentielles grâce aux différences sémantiques entre points de vue et à la qualité des descriptions mono-vue, complète ensuite les preuves par des observations actives, et forme une mémoire d'objets plus stable grâce à une fusion contrainte des descriptions. À l'avenir, les chercheurs souhaitent utiliser UQ-DAAAM pour guider différents types de robots, par exemple des bras robotiques mobiles, et appliquer leur technique de quantification de l'incertitude à d'autres domaines.
Références :
https://arxiv.org/pdf/2606.08277 https://news.mit.edu/index%2ephp/2026/clearing-up-robot-fuzzy-memory-1105