Command Palette
Search for a command to run...
Les Données Massives De Microbiomes Du Sol Sont Difficiles À Annoter ; BBERT Extrait Des Indices Taxonomiques Et Fonctionnels À Partir De Courtes Lectures De 100 Pb
Les écosystèmes microbiens présentent une structure compositionnelle d’une complexité extrême. Comprendre cette complexité est essentiel pour élucider les divers processus qui maintiennent le fonctionnement de la biosphère, et ce travail ne peut se faire sans l’analyse de vastes jeux de données de séquençage. Aujourd’hui, ces ressources de données sont abondantes : des milliers de jeux de données métagénomiques publics, couvrant divers biomes de la Terre, sont disponibles gratuitement et téléchargeables.
Parmi ces données, les métagénomes de sol revêtent une importance particulière pour la recherche. Le séquençage métagénomique par approche « shotgun » (Shotgun Metagenomics) dans des environnements complexes tels que les sols permet de révéler une biodiversité extrêmement riche. Cependant, en raison de l’absence de bases de données de référence suffisamment exhaustives, la plupart des courtes lectures (Short Reads) générées par le séquençage shotgun ne peuvent pas être correctement annotées sur le plan taxonomique ou fonctionnel, ce qui empêche une analyse complète de la structure et des fonctions réelles des communautés microbiennes.
Dans ce contexte, une équipe de recherche de l’Université hébraïque de Jérusalem a présenté BBERT, un grand modèle de langage basé sur les nucléotides, optimisé pour l’analyse des courtes lectures. Les chercheurs ont effectué des tests sur de vastes jeux de données métagénomiques de sol et ont découvert que BBERT peut identifier les caractéristiques syntaxiques des séquences bactériennes sans dépendre de bases de données de référence, et déterminer avec précision, à partir de courtes lectures de seulement 100 pb, leur domaine taxonomique (Taxonomic Domain), leur potentiel codant (Coding Potential) et leur cadre de lecture (Reading Frame). De plus, le modèle BBERT peut convertir directement les courtes lectures métagénomiques en séquences d’acides aminés bactériens, soutenant ainsi les recherches et applications futures. En matière d’assemblage de novo métagénomique, BBERT démontre également des avantages : il réduit les mésappariements et les lacunes lors de l’assemblage, tout en raccourcissant le temps d’exécution. Les chercheurs ont ensuite validé leurs résultats à l’aide de données métagénomiques issues des nodosités racinaires de légumineuses sauvages, montrant que le filtrage des données via BBERT permet non seulement d’améliorer considérablement la qualité du binning (Binning), mais aussi d’accélérer significativement la vitesse d’assemblage de novo.
Les résultats de cette recherche, intitulés « Fast and accurate taxonomic domain assignment of short metagenomic reads using BBERT », ont été publiés dans Nucleic Acids Research.
Points forts de la recherche :
- BBERT surmonte simultanément les limites antérieures des méthodes basées sur les grands modèles de langage en termes de débit et de précision
- L’utilisation de BBERT comme pré-filtre avant l’analyse métagénomique améliore la vitesse d’annotation fonctionnelle et la qualité de l’assemblage de novo, réduit les erreurs d’assemblage et améliore la qualité du binning
- BBERT offre une méthode rapide, sans nécessiter de base de données de référence, pour la classification des courtes lectures, promettant de libérer la valeur de recherche des vastes archives existantes de données métagénomiques
Adresse du papier :
https://academic.oup.com/nar/article/54/19/gkag1002/8971853?login=false
Jeu de données : De l’entraînement sur des génomes bactériens à la validation dans des environnements métagénomiques complexes
Lors du développement et de l’évaluation de BBERT, les chercheurs ont organisé et construit deux types de jeux de données.
- Le premier type est destiné au pré-entraînement du modèle et comprend des données génomiques provenant de 1416 espèces bactériennes. Pour que les données couvrent mieux l’arbre de l’évolution de la vie bactérienne, deux génomes ont été sélectionnés aléatoirement dans chaque famille bactérienne de la base de données RefSeq.
- Le second type est destiné au calibrage et à l’évaluation du modèle, comprenant 899 espèces bactériennes appartenant à 396 genres différents, ainsi que 1200 espèces eucaryotes appartenant à 823 genres différents. Il est à noter que ces deux types de jeux de données sont totalement séparés au niveau taxonomique du genre, sans aucun chevauchement de genres entre eux.
Parallèlement, pour construire un jeu de données de génomes de référence filtré, représentatif de la diversité eucaryote dans les environnements du sol, les chercheurs ont d’abord établi une liste de taxons cibles en consultant des études de métabarcoding par amplicons (Amplicon Metabarcoding Studies) ciblant l’ARNr 18S et l’ITS dans les communautés microbiennes du sol. Ces études comprenaient le projet Earth Microbiome Project, le projet d’enquête sur les sols LUCAS à l’échelle pan-européenne, ainsi que des enquêtes sur la diversité mondiale des protistes et des champignons du sol.
Par une analyse synthétique de la littérature mentionnée ci-dessus, huit principaux lignages eucaryotes, montrant constamment une abondance élevée dans les communautés microbiennes du sol, ont été identifiés :
- Cercozoaires (Cercozoa)
- Ciliés (Ciliophora)
- Oomycètes (Oomycota, groupe hétérokonté)
- Gloméromycètes (Glomeromycota, c’est-à-dire les champignons mycorhiziens à arbuscules)
- Mucoromycètes (Mucoromycota)
- Ascomycètes (Ascomycota)
- Nématodes à vie libre (Free-living Nematoda)
- Amibes (Amoebozoa)
De plus, le jeu de données inclut également des groupes de Chlorophytes (algues vertes) liés aux environnements du sol, ainsi que des taxons de plantes terrestres pour lesquels des données de séquençage génomique sont déjà disponibles.
Pour prendre en compte la stochasticité potentielle lors du regroupement des espèces, l'ensemble des entrées d'accès génomiques des ensembles de données d'étalonnage et d'évaluation ont été divisés en 20 groupes égaux selon le niveau taxonomique du genre, les bactéries et les eucaryotes étant chacun répartis en 20 groupes. Au sein de chaque groupe, l'abondance des espèces a été attribuée aléatoirement selon une distribution log-normale (Log-normal Distribution). Ensuite, les groupes des deux types d'ensembles de données ont été combinés deux par deux pour former 20 sous-ensembles combinés. Chaque sous-ensemble possède une composition indépendante en genres de bactéries et d'eucaryotes. Parmi ces 20 sous-ensembles, les 10 premiers (ensembles de données 1–10) ont été utilisés pour le réglage fin du modèle, tandis que les 10 autres (ensembles de données 11–20) ont été réservés pour l'évaluation du modèle.
Cadre BBERT : Apprendre les caractéristiques bactériennes à partir de séquences d'ADN avec des grands modèles de langage
BBERT est un modèle développé sur l'architecture BERT, conçu pour la détection hors distribution (OOD) de séquences nucléotidiques issues de génomes bactériens. Son idée centrale consiste à entraîner le modèle exclusivement sur des séquences bactériennes, afin de déterminer si une séquence donnée est d'origine bactérienne. Pour construire un grand modèle de langage capable de détecter les génomes bactériens hors distribution sur la base de séquences nucléotidiques, les chercheurs ont adopté un processus de développement en trois étapes :
- Pré-entraînement de l'architecture BERT en utilisant uniquement des lectures de génomes bactériens ;
- Réglage fin pour la tâche de classification bactérien/non-bactérien ;
- Évaluation des performances du modèle dans la tâche de classification des lectures bactériennes, avec comparaison à BERTax, Tiara et REMME.
① Pré-entraînement du modèle
Le pré-entraînement de BBERT a utilisé un ensemble de données bactériennes contenant des séquences nucléotidiques courtes synthétiques générées par échantillonnage, chaque séquence ayant une longueur de 100 pb, visant à simuler les lectures de séquençage métagénomique et les erreurs de séquençage potentielles. Lors de l'entraînement, les chercheurs ont adopté le modèle de langage masqué comme objectif d'optimisation, en masquant 30 % des jetons (Tokens) des séquences d'entrée et en optimisant la capacité du modèle à inférer ces jetons masqués en fonction du contexte. Par ce processus, le modèle apprend à caractériser les nucléotides manquants sur la base des informations disponibles dans les lectures.
Le processus d'optimisation du pré-entraînement a été réalisé par phases de 5 à 10 époques d'entraînement (Epochs), jusqu'à l'obtention des meilleurs résultats, tout en sauvegardant tous les points de contrôle intermédiaires (Checkpoints, c'est-à-dire les poids du modèle). Généralement, on observe une diminution continue de la perte d'entraînement accompagnée d'une amélioration constante de la précision de classification. L'entraînement est arrêté lorsque les progrès stagnent et que les performances du modèle ne s'améliorent plus de manière significative.
② Réglage fin du modèle
Ensuite, pour permettre à BBERT d'exécuter la tâche de classification des lectures bactériennes, les chercheurs ont ajouté une tête de classification légère (Classification Head) au modèle : une couche linéaire est ajoutée au-dessus des embeddings de jetons générés par l'encodeur (Encoder) de BBERT, permettant de prédire directement si une lecture est d'origine bactérienne.
Cette tête de classification a été entraînée par apprentissage supervisé. Durant l'entraînement, les poids du modèle BBERT pré-entraîné n'ont pas été gelés ; l'encodeur et la tête de classification ont été réglés finement de manière conjointe, afin que les représentations de caractéristiques apprises par l'encodeur s'adaptent à la tâche de classification actuelle. Pour éviter d'affecter de manière instable les poids pré-entraînés, des taux d'apprentissage distincts ont été définis pour la tête de classification et l'encodeur : le taux d'apprentissage de l'encodeur était de 1×10⁻⁶, celui de la tête de classification de 1×10⁻⁵, et l'optimiseur AdamW a été utilisé.
Les recherches ont montré que la stratégie consistant à geler les deux couches inférieures de l'encodeur Transformer et à régler finement les autres couches est efficace. Le modèle génère finalement la probabilité qu'une lecture soit d'origine bactérienne, notée bact_prob ; lorsque bact_prob est supérieur à 0,5, la lecture est classée comme étant d'origine bactérienne.
③ Évaluation et comparaison du modèle
Enfin, les chercheurs ont calculé et rapporté les indicateurs globaux de performance de classification du modèle sur les ensembles de données, et ont comparé les résultats de référence à ceux de BERTax, Tiara et REMME.
Résultats : La précision de classification de BBERT, l'annotation fonctionnelle et l'efficacité d'assemblage sont toutes vérifiées
① Les performances de BBERT surpassent celles des outils de classification par apprentissage profond avancés existants
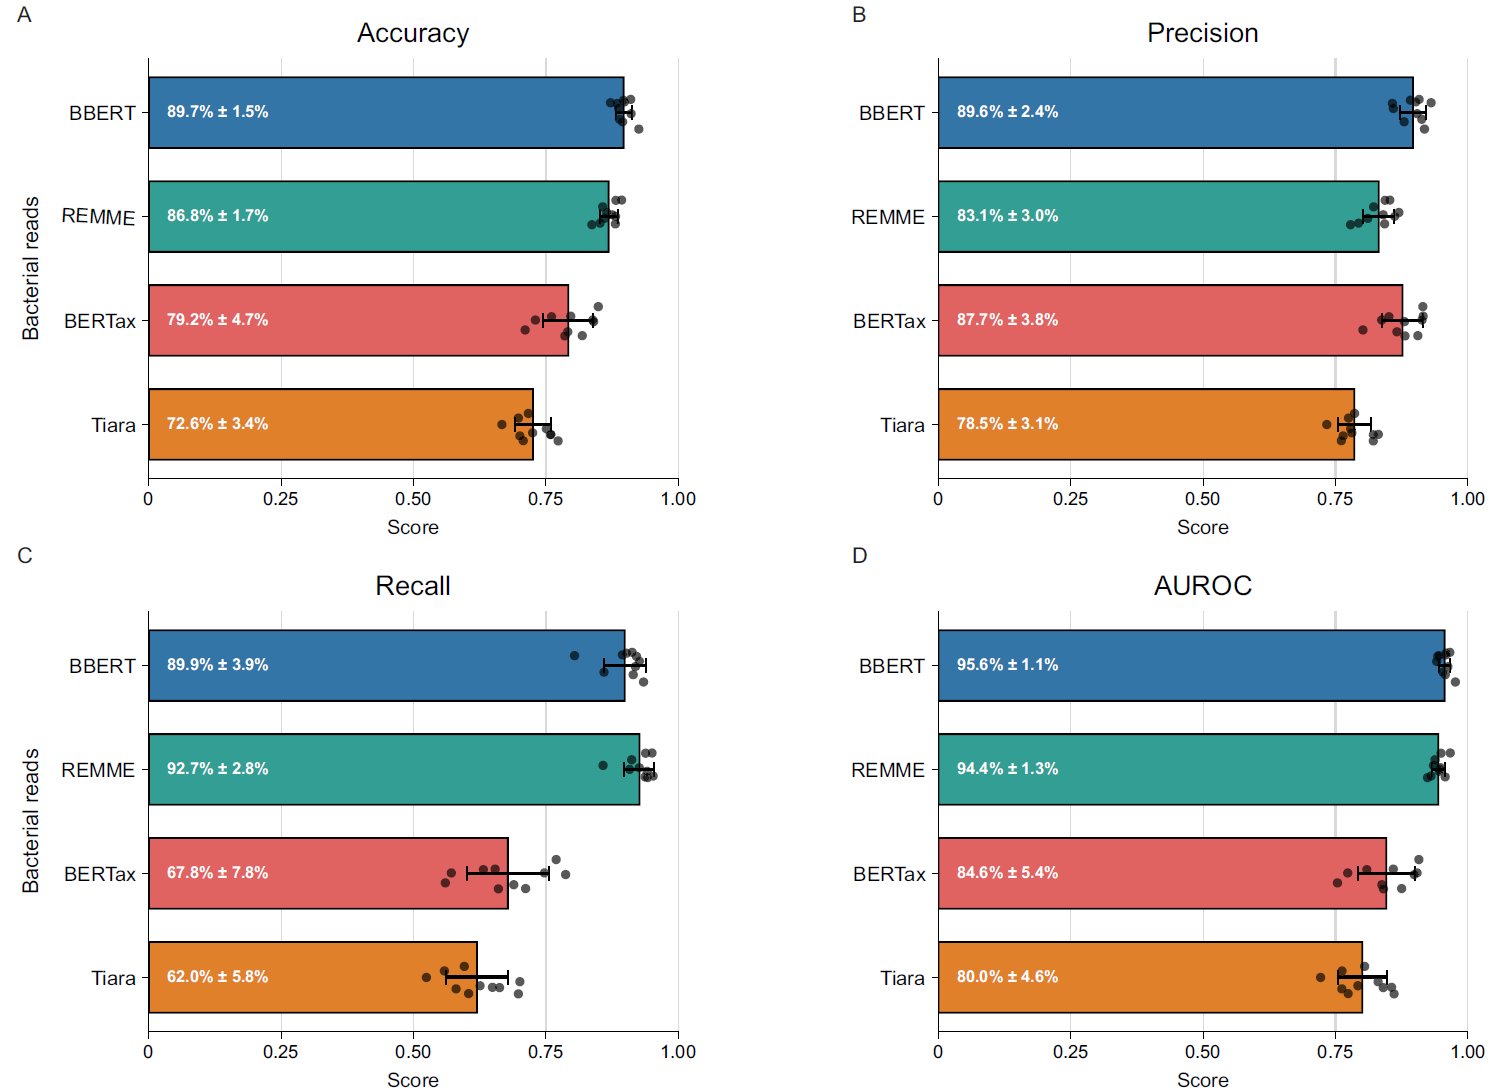
Tout d'abord, dans la tâche de classification des lectures bactériennes et non bactériennes, BBERT fait preuve d'une forte capacité de reconnaissance — comme le montre la figure ci-dessous, BBERT surpasse BERTax, Tiara et REMME optimisé en termes d'indicateurs standards de classification tels que la précision (accuracy), la précision (precision), le rappel (recall, comparable à REMME) et l'AUROC. La précision moyenne de classification par domaine de BBERT sur 10 ensembles de test est de 89,7 % ± 1,7 %, contre 86,8 % ± 1,7 % pour REMME, 79,2 % ± 4,7 % pour BERTax et 72,6 % ± 3,4 % pour Tiara.
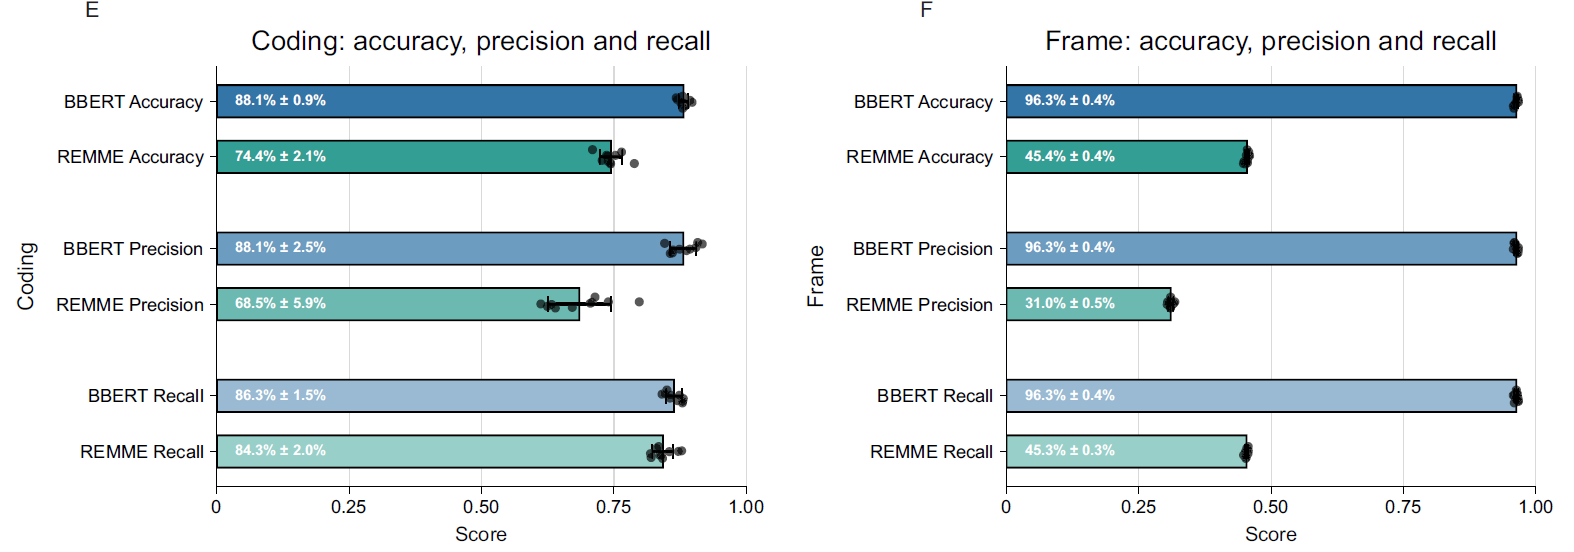
En ce qui concerne l'identification des séquences codantes et de leurs cadres de lecture, les performances de BBERT sont supérieures à celles de REMME, qui est le seul outil de la même catégorie disposant de cette fonctionnalité (figure E ci-dessous, précision de codage : 88,1 % ± 0,9 % pour BBERT, 74,4 % ± 2,1 % pour REMME ; figure F ci-dessous, précision du cadre de lecture : 96,3 % ± 0,3 % pour BBERT, 45,4 % ± 0,4 % pour REMME).
En termes de performances de calcul, BBERT démontre également une bonne utilité pratique. Sur un nœud de calcul équipé d'un GPU NVIDIA H200 dédié, BBERT peut traiter 45 912 lectures par seconde (reads per second, rps), tandis que BERTax et Tiara traitent respectivement 413 rps et 347 rps. Cependant, la version de REMME après optimisation du code est légèrement plus rapide, atteignant 50 745 rps. Lors de l'exécution sur un ordinateur personnel sous Windows 10 équipé d'un GPU NVIDIA RTX 3090, la vitesse de traitement de BBERT est de 15 373 rps. Cela signifie que les utilisateurs peuvent utiliser BBERT pour mener des analyses sans dépendre de clusters de calcul haute performance, ce que la plupart des outils similaires ne peuvent pas faire.
② BBERT est un outil d'identification bactérienne à haute sensibilité
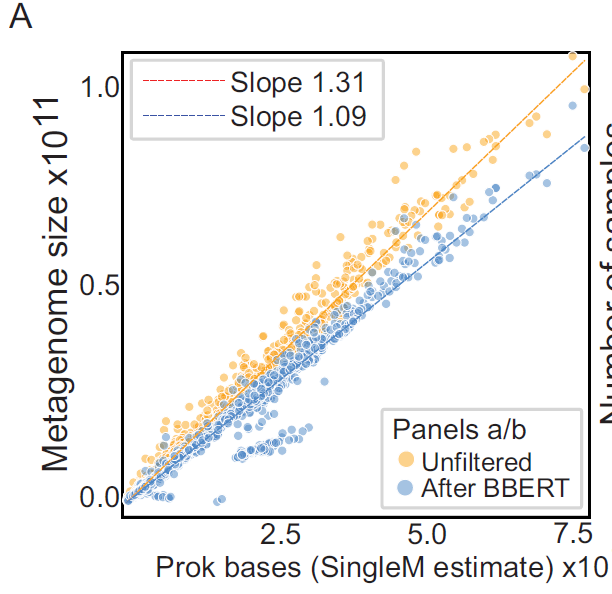
Les chercheurs ont également appliqué BBERT à 1 969 jeux de données de métagénomique de sols publiques soigneusement organisés, en utilisant le nombre de bases procaryotes estimé par SingleM comme référence, afin de valider davantage ses performances sur ces données réelles dépourvues de véritables résultats taxonomiques. Comme le montre la figure ci-dessous, sans filtrage préalable, le nombre total de bases dans les données métagénomiques est supérieur de 31 % au nombre de bases procaryotes estimé par SingleM (pente de 1,31 ± 0,01) ; après filtrage par BBERT, cet écart se réduit à 9 % (pente de 1,09 ± 0,01).
Contrairement à SingleM, Kraken2 permet des comparaisons au niveau de chaque lecture individuelle ; les chercheurs ont donc également comparé directement BBERT et Kraken2. Les résultats montrent que : pour les lectures identifiées comme étant d'origine bactérienne par Kraken2, les jugements de BBERT sont fondamentalement cohérents ; parallèlement, BBERT est capable d'identifier un nombre considérable de lectures que Kraken2 ne peut pas classer (voir figure ci-dessous) ; inversement, il y a très peu de lectures que Kraken2 peut identifier mais que BBERT ne parvient pas à identifier.
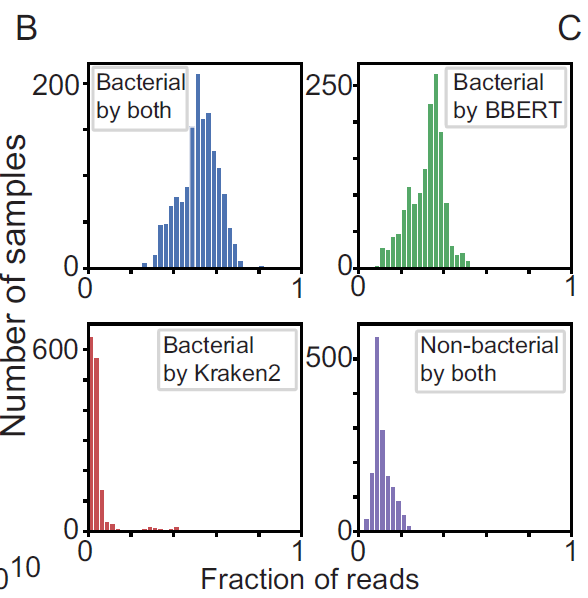
Par conséquent, BBERT est un outil d'identification bactérienne à haute sensibilité, capable de classer les lectures au niveau individuel comme le fait Kraken2, sans être limité par l'incomplétude de la couverture de la base de données de référence.
③ BBERT permet de traduire directement les courtes lectures d'ADN en séquences d'acides aminés
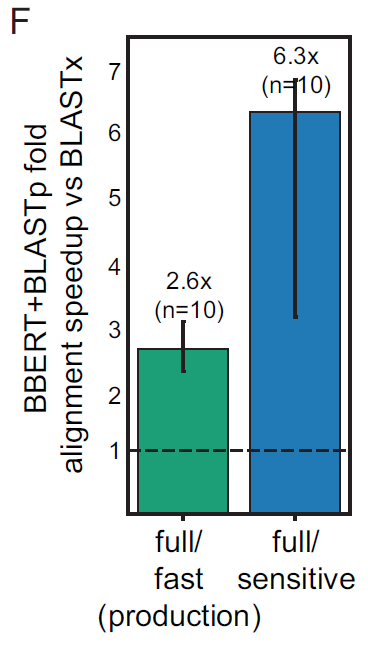
Étant donné que BBERT peut identifier les lectures codantes d'origine bactérienne ainsi que leurs cadres de lecture, il peut également traduire directement les courtes lectures métagénomiques en séquences d'acides aminés. Les recherches ont révélé que, par rapport à l'annotation des lectures d'ADN non filtrées via BLASTx, cette méthode permet d'obtenir des résultats d'annotation fondamentalement cohérents, mais avec une vitesse de traitement plus rapide : une amélioration d'environ 2,6 fois en mode « fast » et d'environ 6,3 fois en mode « sensitive » (voir figure ci-dessous). Cela signifie que BBERT peut non seulement aider les chercheurs à filtrer les données, mais aussi potentiellement optimiser davantage le processus d'annotation fonctionnelle métagénomique.
④ BBERT accélère l'assemblage de novo métagénomique et réduit les erreurs d'assemblage
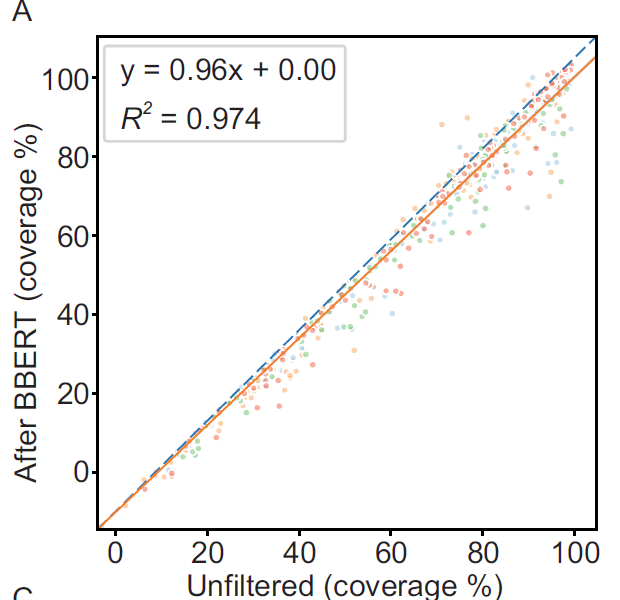
En ce qui concerne l'assemblage métagénomique, le rôle de BBERT est encore plus direct. L'équipe de recherche a découvert que, dans les données non filtrées, un grand nombre de séquences non ciblées augmentent la charge d'assemblage et peuvent introduire des lacunes et des mésappariements erronés. Après filtrage par BBERT sur des données métagénomiques simulées, la moyenne non pondérée de la couverture des génomes bactériens est passée de 68,23 % à 65,22 %, soit une perte de couverture d'environ 4,4 % (voir figure ci-dessous). Parallèlement, le temps d'assemblage a été réduit de 66 ± 8 heures à 25 ± 2 heures, soit une amélioration de l'efficacité d'environ 2,7 fois.
La précision de l'assemblage s'est également améliorée. En calculant la moyenne non pondérée sur 512 génomes et en normalisant les métriques par la longueur du génome de référence, on observe que le nombre d'ouvertures de gaps par 100 bp de séquence de référence a diminué de 0,51 à 0,36, soit une réduction de 0,15 et une baisse relative de 29,3 % ; le nombre de mismatches a diminué de 3,31 à 2,64, soit une réduction de 0,67 et une baisse relative de 20,2 %. La baisse combinée des deux métriques est d'environ 21,4 %.
⑤ Données métagénomiques réelles de nodules racinaires
Pour évaluer les gains potentiels du filtrage BBERT sur des données réelles, les chercheurs l'ont appliqué à des données métagénomiques de nodules racinaires de légumineuses. Le volume du résultat d'assemblage combiné après filtrage BBERT a réduit de 61 %, passant de 577,6 Mb à 222,4 Mb ; le nombre de contigs a diminué de 57 % ; et la teneur en GC est passée de 40,4 % à 58,5 %.
Ce changement est cohérent avec une teneur en GC d'environ 40 % pour les génomes de légumineuses et d'environ 62 % pour les génomes de l'ordre des Rhizobiales, indiquant que la grande majorité des lectures filtrées provenaient de l'hôte. De plus, le filtrage BBERT a doublé la valeur N50 de l'assemblage, passant de 0,9 kb à 1,8 kb, réduit de moitié le temps d'exécution de l'assemblage, et fait chuter l'occupation mémoire maximale de 188 Go à 82 Go.
Conclusion
BBERT démontre une autre possibilité pour les grands modèles de langage dans le traitement de courtes séquences d'ADN : même face à des lectures de 100 bp sans support de base de données de référence, il peut, en apprenant les caractéristiques intrinsèques des séquences, accomplir la détermination du domaine taxonomique, l'identification du potentiel codant et la prédiction du cadre de lecture. Plus important encore, cette capacité peut non seulement servir à identifier les séquences non ciblées dans les métagénomes, mais aussi améliorer les processus en aval tels que l'annotation fonctionnelle, l'assemblage de génomes et le binning.
L'étude montre également que les biais de reconnaissance de BBERT envers des séquences particulières comme les éléments génétiques mobiles peuvent refléter des caractéristiques évolutives distinctes entre ces séquences et le génome de l'hôte. À l'avenir, la sensibilité des grands modèles de langage aux motifs uniques de séquences d'ADN pourrait fournir de nouveaux outils pour retracer les événements de transfert horizontal de gènes. Avec le développement continu de ces modèles, leurs applications pourraient s'étendre de la taxonomie microbienne à une génomique écologique plus large.
Références :
https://phys.org/news/2026-10-ai-tool-scientists-bacteria-hidden.html
https://academic.oup.com/nar/article/54/19/gkag1002/8971853?login=false