Command Palette
Search for a command to run...
Deconstructing StyleCLIP: Textbasiertes On-Demand-Design, Vergleichbar Mit Menschlichem Photoshop
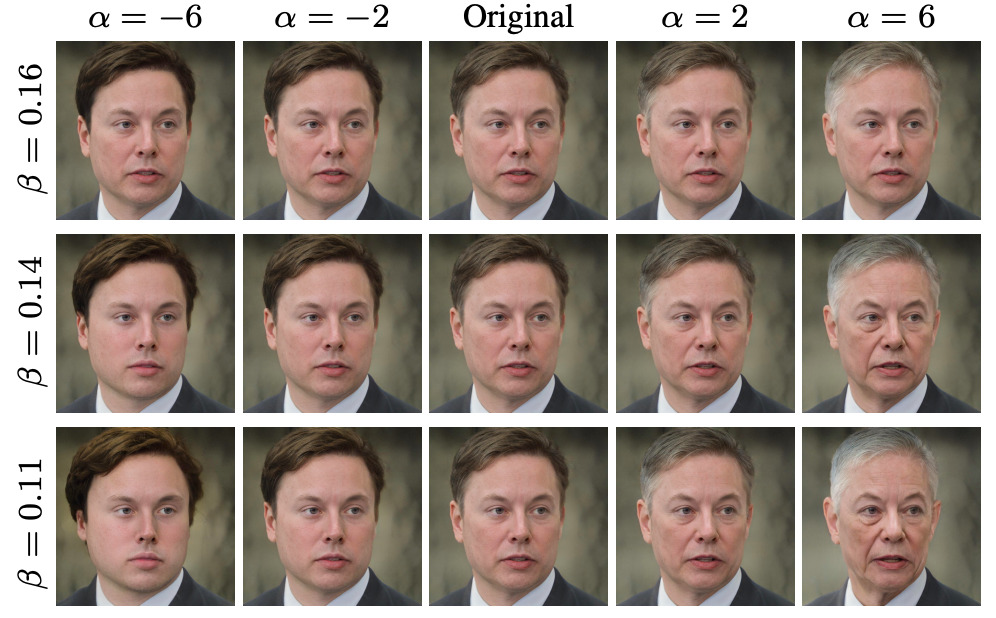
Jeder kennt StyleGAN. Dieses neue generative Adversarial Network von NVIDIA,Durch die Übernahme der Stilübertragung kann schnell eine große Anzahl neuer stilbasierter Bilder generiert werden.
**StyleGAN verfügt über eine starke Lernfähigkeit und generiert Bilder, die von echten nicht zu unterscheiden sind.**Allerdings ist diese Methode des Lernens und der sekundären Gestaltung, die auf dem „Anschauen von Bildern“ basiert, nach zu häufiger Anwendung etwas traditionell und konservativ geworden.
Forscher der Hebräischen Universität, der Universität Tel Aviv und von Adobe Research,**Kombiniert auf kreative Weise die generative Leistung des vortrainierten StyleGAN-Generators mit den visuellen Sprachfunktionen von CLIP.**Einführung einer neuen Möglichkeit zum Ändern von StyleGAN-Bildern – Angetrieben durch den Text erzeugt alles, was Sie „schreiben“, das von Ihnen gewünschte Bild..
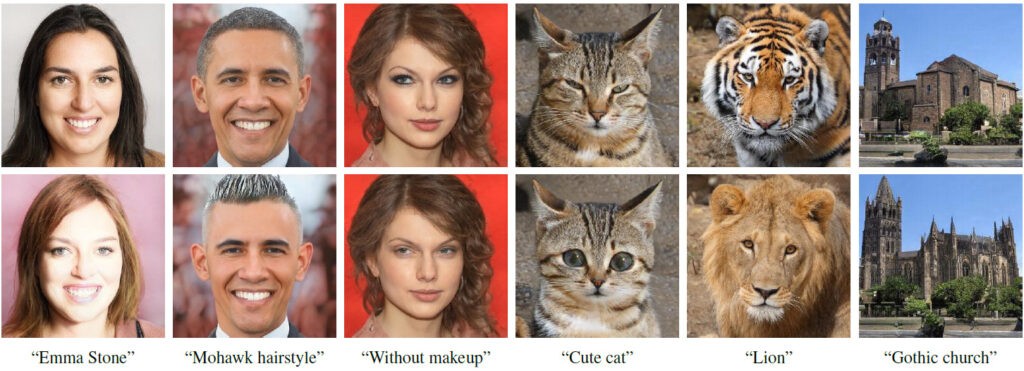
Wer ist StyleCLIP?
StyleCLIP ist, wie der Name schon sagt, eine Kombination aus StyleGAN und CLIP.
StyleGAN verwendet die Bildinversion, um Bilder als latenten Code darzustellen, und steuert dann den Bildstil durch Bearbeiten und Ändern des latenten Codes.
CLIP steht für Contrastive Language-Image Pretraining. Es handelt sich um ein neuronales Netzwerk, das mit 400 Millionen Bild-Text-Paaren trainiert wurde. Es kann das relevanteste Bild basierend auf einer gegebenen Textbeschreibung ausgeben.
In der Arbeit untersuchten die Forscher drei Methoden zur Kombination von StyleGAN und CLIP:
- Kontextgesteuerte latente Vektoroptimierung, bei der das CLIP-Modell als Verlustnetzwerk verwendet wird.
- Trainieren Sie Latent Mapper, um den latenten Vektor nacheinander dem jeweiligen Text zuzuordnen.
- Im StyleSpace von StyleGAN wird die Textbeschreibung der globalen Richtung des Eingabebildes zugeordnet, um die Intensität der Bildoperationen und den Grad der Trennung zu steuern.
Ähnliche Arbeiten
2.1 Vision und Sprache
Gemeinsame VertretungenEs gibt viele Aufgaben, bei denen modalübergreifende visuelle und sprachliche Darstellungen (VL) erlernt werden können, wie etwa textbasiertes Abrufen von Bildern, Bildbeschriftungen und visuelles Antworten. Aufgrund des Erfolgs von BERT bei verschiedenen Sprachaufgaben verwenden aktuelle VL-Methoden normalerweise Transformatoren, um gemeinsame Darstellungen zu erlernen.
Textgeführte Bildgenerierung und -verarbeitung
Trainieren Sie ein geeignetes GAN, um Text-Embeddings von einem vortrainierten Encoder für die textgesteuerte Bildgenerierung zu erhalten.
2.2 Latentraum-Bildverarbeitung
Der latente Zwischenraum von StyleGAN hat sich bewährt**Eine große Anzahl von Zerlegungen und sinnvollen Bildverarbeitungsoperationen kann erreicht werden,**Beispielsweise kann ein Netzwerk trainiert werden, ein gegebenes Bild in einen Einbettungsvektor des verarbeiteten Bildes zu kodieren und dadurch zu lernen, die Bildverarbeitung durchgängig durchzuführen.
Die Bildverarbeitung erfolgt direkt auf der Texteingabe und wird von einem vortrainierten CLIP-Modell überwacht. Da CLIP an Hunderten Millionen Text-Bild-Paaren trainiert wird,Daher ist diese Methode universell und kann in vielen Bereichen verwendet werden, ohne dass eine Datenannotation für bestimmte Felder oder eine spezielle Verarbeitung erforderlich ist.
3. StyleCLIP textgesteuerte Bildverarbeitung
Diese Arbeit untersucht drei Möglichkeiten der textgesteuerten Bildverarbeitung:Alle diese Ansätze kombinieren die generative Kraft von StyleGAN mit der umfassenden gemeinsamen Bildsprachendarstellung von CLIP.
4. Latente Optimierung
Eine einfache Möglichkeit, CLIP zur Steuerung der Bildverarbeitung zu verwenden, ist die direkte latente Codeoptimierung.
5. Latent Mapper
Latente Optimierung ist universell.**Weil es speziell für alle Quellbild-Textbeschreibungspaare optimiert ist.**Der Nachteil besteht darin, dass die Bearbeitung eines Bildes mehrere Minuten Optimierungszeit in Anspruch nehmen kann und die Methode etwas empfindlich auf ihre Parameterwerte reagiert.

Die Zuordnung von Texthinweisen zu einer einzigen, globalen Richtung im StyleGAN Style Space, was sich bewährt hatDiskreter als andere latente Räume.
Der Autor des Papiers: von israelischen Universitäten, mit Schwerpunkt auf GAN
**Der Erstautor des Artikels, Or Patashnik, ist ein Doktorand der Informatik an der Universität Tel Aviv.**Hauptsächlich an Projekten zur Bilderzeugung und -verarbeitung beteiligt. Sie interessiert sich sehr für maschinelles Lernen, Computergrafik und maschinelles Sehen.Beschäftigt sich hauptsächlich mit Projekten zur Bilderzeugung und -verarbeitung und hat mehrere Artikel zu StyleGAN veröffentlicht.
**Zongze Wu konzentriert sich auf Themen im Zusammenhang mit Computer Vision.Wie etwa generative kontradiktorische Netzwerke, Bildverarbeitung, Bildübersetzung usw.
Laut Zongze Wus LebenslaufVon 2011 bis 2016 studierte er an der Tongji-Universität mit Schwerpunkt Bioinformatik.**Nach seinem Abschluss schrieb sich Zongze Wu an der Hebräischen Universität Jerusalem ein, um in Computational Neuroscience zu promovieren.
Detaillierte Erklärung von drei Methoden, die StyleGAN und CLIP kombinieren
Laut dem StyleCLIP-bezogenen Artikel haben Forscher drei Methoden entwickelt, um StyleGAN und CLIP zu kombinieren.Diese drei Methoden basieren jeweils auf Latent Optimization, Latent Mapper und Global Direction.
1. Basierend auf latenter Optimierung
Dieses Tutorial stellt hauptsächlich die Gesichtsbearbeitung auf der Grundlage iterativer Optimierung vor. Der Benutzer gibt einen Textausdruck ein und erhält ein bearbeitetes Gesichtsbild, das zum Text passt.
Schritt 1: Vorbereiten der Codeumgebung
import os
os.chdir(f'./StyleCLIP')

! pip install ftfy regex tqdm
! pip install git+https://github.com/openai/CLIP.git
Schritt 2 Parametereinstellung
experiment_type = 'edit' # 可选: ['edit', 'free_generation']

description = 'A person with blue hair' # 编辑的描述,需要是字符串

latent_path = None # 优化的起点 (一般不需修改)

optimization_steps = 100 # 优化的步数

l2_lambda = 0.008 # 优化时候 L2 loss 的权重

create_video = True # 是否将中间过程存储为视频

args = {
    "description": description,
    "ckpt": "/openbayes/input/input0/stylegan2-ffhq-config-f.pt",
    "stylegan_size": 1024,
    "lr_rampup": 0.05,
    "lr": 0.1,
    "step": optimization_steps,
    "mode": experiment_type,
    "l2_lambda": l2_lambda,
    "latent_path": latent_path,
    "truncation": 0.7,
    "save_intermediate_image_every": 1 if create_video else 20,
    "results_dir": "results"
}
Schritt 3: Ausführen des Modells
from optimization.run_optimization import main
from argparse import Namespace
result = main(Namespace(**args))
Schritt 4: Visualisieren Sie die Bilder vor und nach der Verarbeitung
# 可视化图片
from torchvision.utils import make_grid
from torchvision.transforms import ToPILImage
result_image = ToPILImage()(make_grid(result.detach().cpu(), normalize=True, scale_each=True, range=(-1, 1), padding=0))
h, w = result_image.size
result_image.resize((h // 2, w // 2))
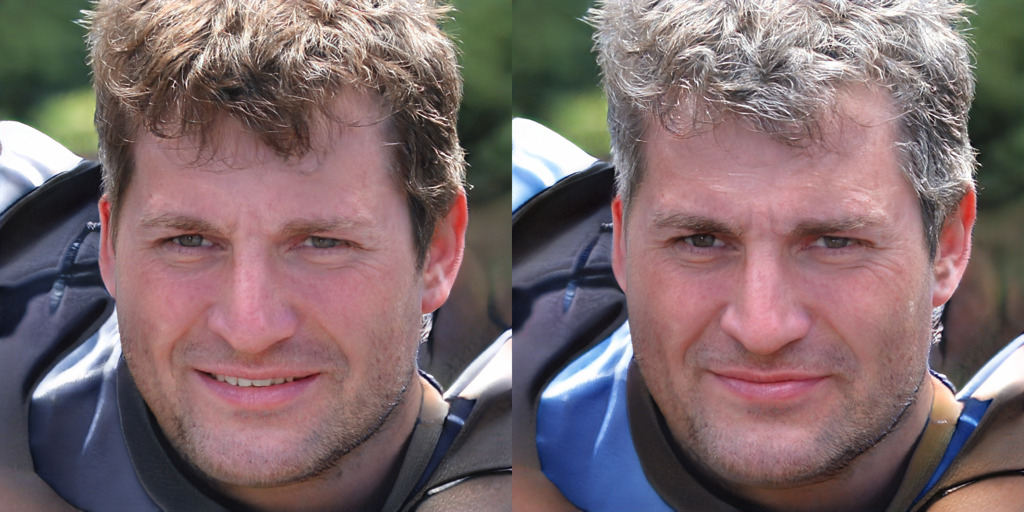 Schritt 5: Speichern Sie den Optimierungsprozess als Videoausgabe
#@title Create and Download Video

!ffmpeg -y -r 15 -i results/%05d.png -c:v libx264 -vf fps=25 -pix_fmt yuv420p /openbayes/home/out.mp4
[Vollständige Notebook-Zugriffsadresse](http://完整 notebook 请访问: https://openbayes.com/console/openbayes/containers/rlJisxxVhhD?path=%2Foptimization_playground.ipynb)
2. Basierend auf Latent Mapper
Der erste Schritt besteht darin, die Codeumgebung vorzubereiten
 Schritt 2: Parameter festlegen
 Schritt 3: Ausführen des Modells
 Schritt 4: Visualisieren Sie die Bilder vor und nach der Verarbeitung

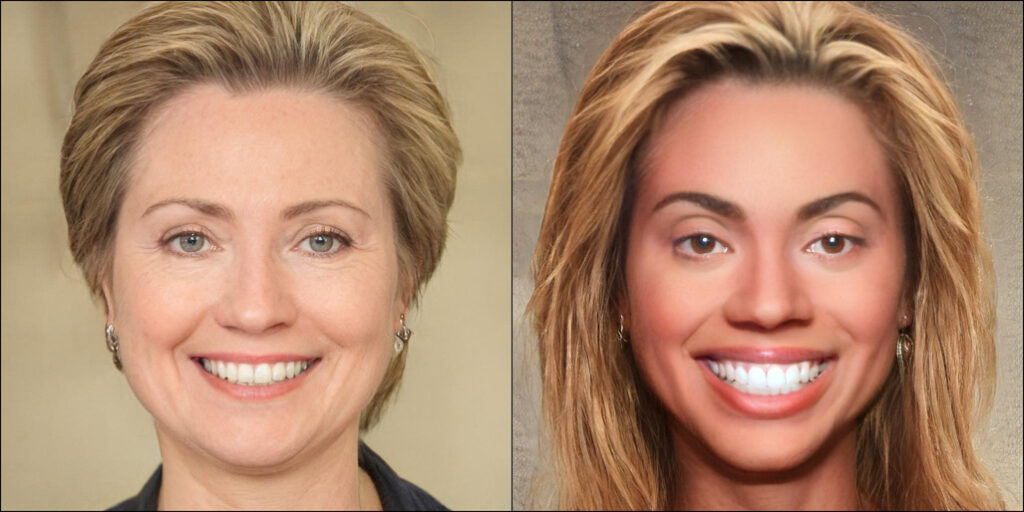 Klicken Sie hier, um zu besuchenKomplettes Notizbuch
3. Basierend auf globaler Ausrichtung
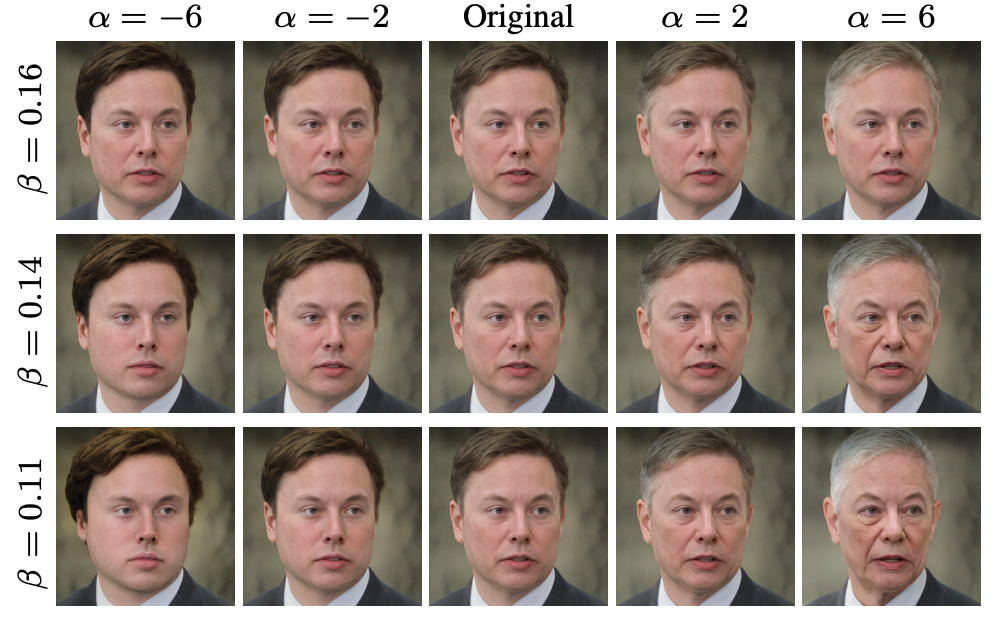
Dieses Tutorial führt in das Zuordnen von Textinformationen zum latenten Raum von StyleGAN und die weitere Änderung des Bildinhalts ein. Benutzer können eine Textbeschreibung eingeben und erhalten ein bearbeitetes Gesichtsbild, das dem Text sehr nahe kommt und eine gute Merkmalsentkopplung aufweist.
Schritt 1: Vorbereiten der Codeumgebung
 Schritt 2: StyleCLIP einrichten
 Schritt 3. e4e einrichten
 Schritt 4: Wählen Sie das Bild aus und verwenden Sie dlib zur Gesichtsausrichtung
 Schritt 5: Kehren Sie das zu bearbeitende Bild in den latenten Raum von StyleGAN zurück

 Schritt 6: Textbeschreibung eingeben
 Schritt 7: Wählen Sie die Manipulationsstärke (Alpha) und den Entkopplungsschwellenwert (Beta) für die Bildbearbeitung

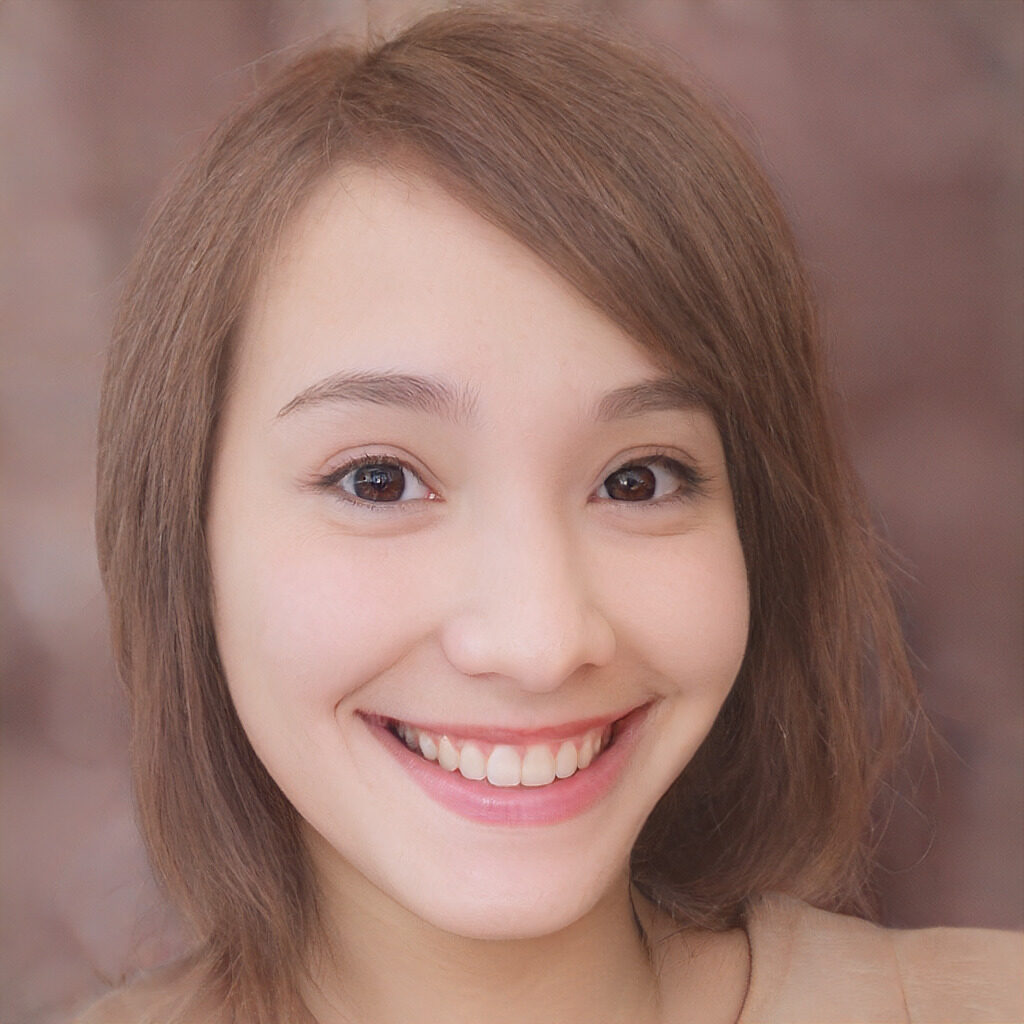 Schritt 8: Erstellen Sie ein Video, um den Bearbeitungsprozess zu visualisieren
 Klicken Sie hier, um zu besuchenKomplettes Notizbuch
Über OpenBayes
OpenBayes ist eine führende Forschungseinrichtung für maschinelle Intelligenz in China.Bietet eine Reihe grundlegender Dienste im Zusammenhang mit der KI-Entwicklung, darunter Rechenleistungscontainer, automatische Modellierung und automatische Parameteranpassung.
**Gleichzeitig hat OpenBayes auch viele gängige öffentliche Ressourcen wie Datensätze, Tutorials und Modelle veröffentlicht.**Damit Entwickler schnell lernen und ideale Modelle für maschinelles Lernen erstellen können.
Jetzt besuchen openbayes.com und registrieren,Erhalten Sie 600 Minuten/Woche vGPU-Nutzung Und 300 Minuten/Woche kostenlose CPU-Rechenzeit
Werden Sie jetzt aktiv und gestalten Sie mit StyleCLIP Ihr Wunschgesicht!
Klicken Sie hier, um zu besuchenVollständiges Tutorial