Command Palette
Search for a command to run...
通用机器人里程碑!MIT 提出策略组合框架 PoCo,解决数据源异构难题,实现机器人多任务灵活执行
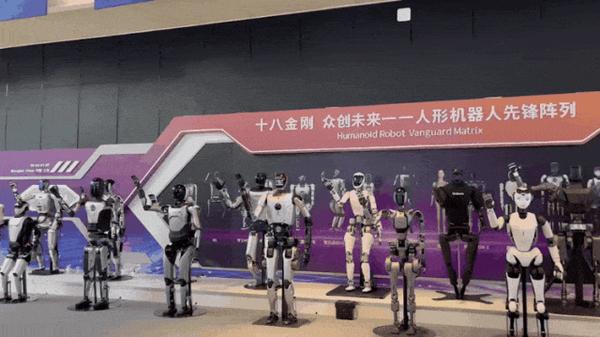
18 位人形机器人充当「迎宾」人员,整齐划一向嘉宾挥手,这是 2024 世界人工智能大会上的一个震撼场景,让人们直观感受到了今年机器人的飞速发展。
针对此,麻省理工研究人员提出了一个机器人策略组合框架 PoCo (Policy Composition),该框架使用扩散模型的概率合成,组合不同领域和模态的数据,为构建复杂的机器人策略组合开发了任务级、行为级、领域级的策略合成方法,能够解决机器人在工具使用任务中的数据异构性、任务多样性问题。相关研究已经以「PoCo: Policy Composition from and for Heterogeneous Robot Learning」为题,发表在 arXiv 上。
研究亮点: * 无需重新训练,PoCo 框架可以灵活组合不同领域数据训练的策略
* 在仿真模拟和真实世界中,PoCo 的工具使用任务都取得优异表现,与单个领域训练的方法相比,PoCo 对不同环境中的任务表现出高度泛化能力
 论文地址:
https://arxiv.org/abs/2402.02511
开源项目「awesome-ai4s」汇集了百余篇 AI4S 论文解读,并提供海量数据集与工具: https://github.com/hyperai/awesome-ai4s
三大数据集来源,涵盖人 &机数据、真实 &仿真数据等领域
本研究所涉及的数据集主要来自人类演示视频数据、真实机器人数据、仿真模拟数据。
人类演示视频数据集
人类演示视频可以从野外未校准的摄像机中收集,共收集多达 200 条轨迹。
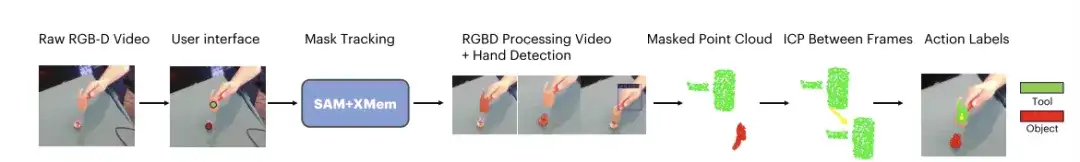
通过安装的手腕摄像头和头顶摄像头获取场景的局部、全局视图,用 GelSight Svelte Hand 采集工具姿势、工具形状、工具与对象接触时的触觉信息,每个任务收集 50-100 个轨迹演示。
仿真模拟数据集
模拟数据集遵循 Fleet-Tools,其中专家演示通过关键点轨迹优化生成,共收集大约 5 万个模拟数据点。在后续训练过程中,研究人员对点云数据和动作数据都进行了数据增强 (data augmentation),并保存固定的模拟场景以供测试使用。
此外,研究人员在来自深度图像 (depth images) 和遮罩 (masks) 中的 512 个工具和 512 个物体点云中,加入逐点噪声 (point-wise noises) 、随机裁剪 (random dropping) 等,以提升模型的鲁棒性。
通过概率分布乘积形式进行策略组合
在策略组合中,研究人员给定两个概率分布编码的轨迹信息 pDM(⋅∣c,T) 、 pD′M′(⋅∣c′,T′),推理时在乘积分布中采样直接结合这两个概率分布的信息。
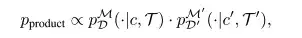 其中,pproduct 在同时满足两个概率分布的所有轨迹上表现出高似然性,可有效编码两种分布的信息。
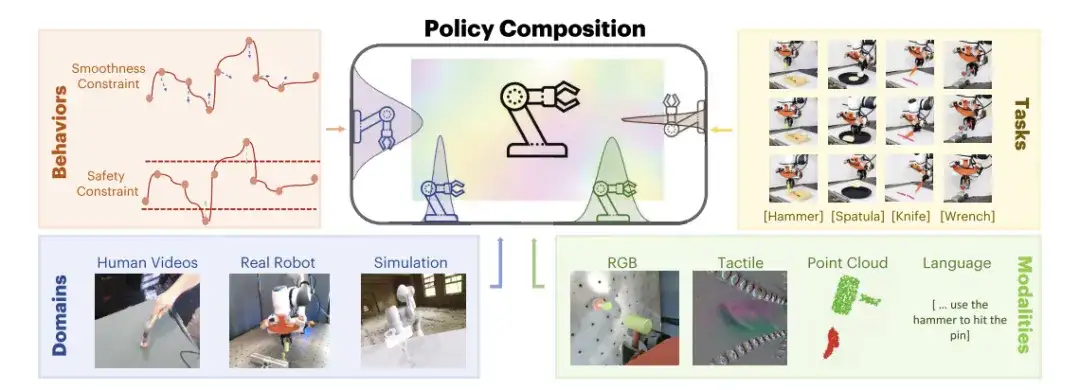
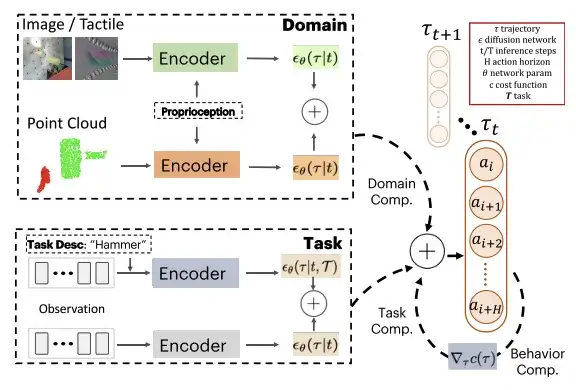
对此,研究人员提供了任务级组合 (Task-level Composition) 、行为级组合 (Behavior-level Composition) 、领域级组合 (Domain-level Composition) 这 3 个示例,以此说明 PoCo 如何提高策略性能。
任务级组合 Task-level Composition
任务级组合在可能完成任务 T 的轨迹上增加了额外权重,可提高合成轨迹的最终质量,不需要为每个任务单独训练,而是训练一个能够实现多任务目标的通用策略。
行为级组合 Behavior-level Composition
这种组合可以结合任务分布和成本目标 (cost objective) 的信息,确保合成的轨迹既能完成任务,又能优化指定的成本目标。
领域级组合 Domain-level Composition
这种组合可以利用来自不同传感器模态、领域捕获的信息,对单独领域收集的数据互补非常有用。例如,当真实机器人数据收集成本高但准确度更高,模拟演示数据收集成本较低但准确度低,可以对同一领域不同模式的数据进行特征串联 (feature concatenation) 以简化处理。
可视化工具使用任务,评估 3 大策略组合
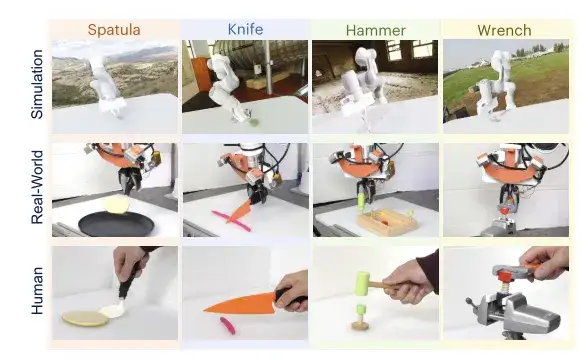
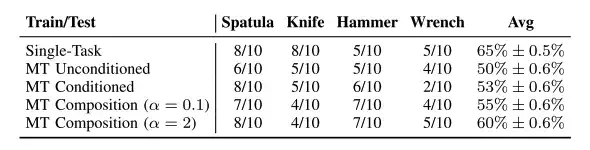
研究人员通过机器人对通用工具(扳手、锤子、铲子和扳手)的使用任务来评估提出的 PoCo,当达到特定阈值时,任务被确定为成功,例如,当销钉被敲入时,锤击任务被认为成功。
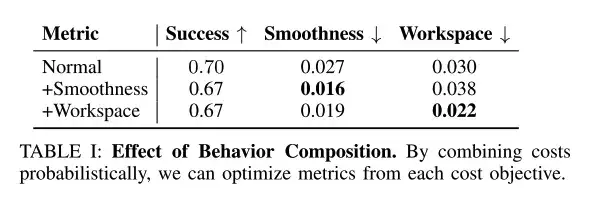
行为级组合可以改善期望的行为目标
研究人员使用 test-time 推理来组合诸如平滑度和工作空间约束等行为,合成权重被固定为 γc=0.1 。
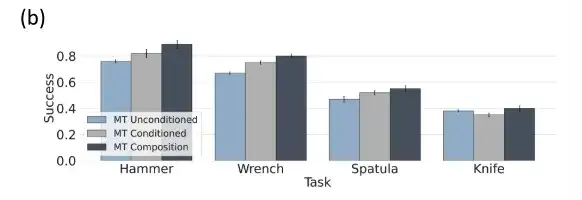
任务级组合在多任务策略评估中最优
当任务权重 α=0 时,任务级组合策略映射到无条件多任务策略 (unconditioned multitask policies),当 α=1 时,映射到标准任务条件策略 (task-conditioned policies),当 0 < α < 1 时,研究人员在任务条件、任务无条件策略 (task unconditional policies) 之间进行插值 (interpolating) 。当 α > 1 时,可以得到更加与任务条件相关的轨迹。
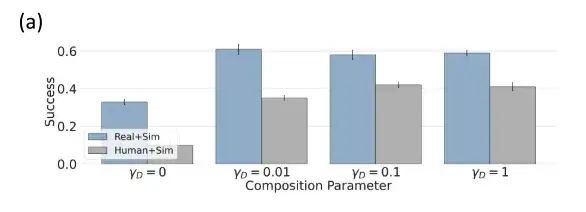
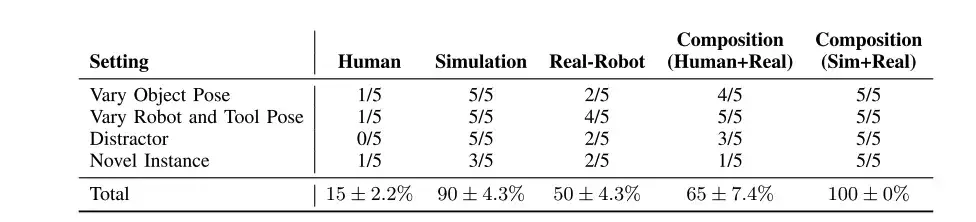
人类+模拟数据,领域级组合性能更优
研究人员使用模拟数据集 θsim 、人类数据集 θhuman 和机器人数据集 θrobot 训练单独的策略模型,并在仿真模拟设置中评估领域级组合。
策略组合性能超过单独组成部分,通用性更强
研究人员将 PoCo 用于机器人工具使用任务中,组合不同领域和任务的数据,进而提高其泛化能力。 4 项任务分别是:用扳手拧螺丝,用锤子敲击钉子,用铲子将煎饼从锅中铲起,用刀切开橡皮泥。
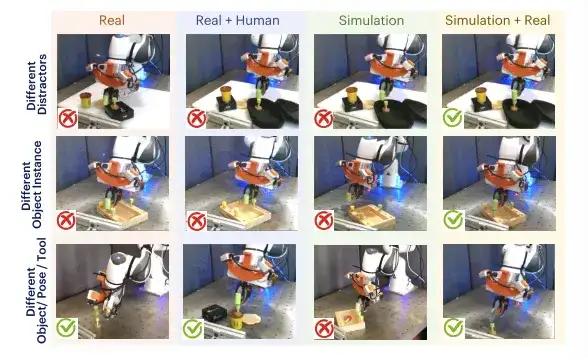 通过组合在仿真模拟、人类和真实数据中训练的策略,可以在跨多个干扰物(第 1 行)、不同物体和工具姿态(第 2 行),以及新的物体和工具实例(第 3 行)之间进行泛化
通用性的最佳条件,人形机器人强势崛起
通用机器人在过去两年得到了蓬勃发展,但一个有意思的现象是,目前行业似乎更认同以人形的方式来推动通用机器人的发展。为什么通用机器人一定要是人形?五源资本董事总经理陈哲对此表示,「因为只有人形机器人才可能在人类的生活环境中适应不同交互场景!」既然机器人要帮人类干活,以人形外在来模仿人类学习,这显然是最佳的。
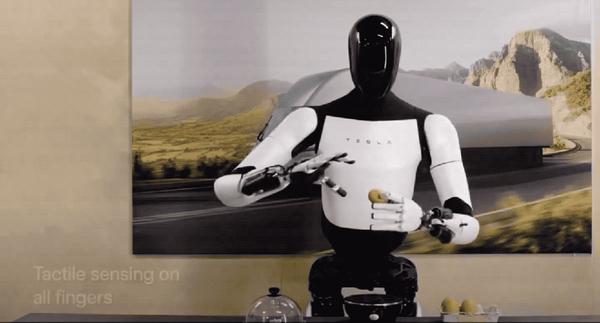
作为行业的指向标,早在 2022 年 9 月,特斯拉就发布了通用人型机器人 Optimus,虽然起初连路都走不稳,但它具备完整的人型机器人原型,满足人类能做的灵巧工作基础,在特斯拉软硬件技术的持续迭代下,Optimus 将具备更令人期待的功能,事实证明确实如此。
同样地,作为一家成立于 2015 年的行业领先通用机器人公司,上海傅利叶智能科技有限公司也将其人形机器人 GR-1 带到了大会现场。自 2023 年推出至今,GR-1 已率先实现量产交付,在环境感知、仿真模型、运动控制优化等方面实现进阶升级。
此外,在今年 3 月份,英伟达在年度 GTC 开发者大会上,也推出了名为 GR00T 的人形机器人项目,通过观察人类行为来理解自然语言和模仿动作,机器人可以快速学习协调性、灵活性和其他技能,以导航、适应、与现实世界互动。
随着科技的不断进步,我们有理由相信,人形机器人或将成为连接人与机器、现实与未来的桥梁,引领我们进入一个更加智能、美好的社会。
参考资料:
https://m.163.com/dy/article/J69LAFDR0512MLBG.html
https://36kr.com/p/1987021834257154
https://hub.baai.ac.cn/view/211